Data-任务-01 分类
文章目录
Data-任务-01 分类
There are three kinds of death in this world. There's heart death, there's brain death, and there's being off the network. --Guy Almes
- Data系列:目录 | 配置 | 代码仓库
- 分类任务(Classification Task),几乎所有有关自然语言处理、数据挖掘、机器学习的书中都会提到,而且也是各种模型方法示例常举的任务,我们在此作出介绍。
1. 分类任务的含义
- 分类任务就是通过学习得到一个目标函数$f$,把每个属性集$x$映射到一个预先定义的类标记$y$,是监督学习的一个核心问题。
-
输入数据:记录的集合$(x,y)$
- $x$表示属性的集合;
- $y$表示类标签/分类属性/目标属性(分类问题中是离散的值)
-
训练结果:目标函数/分类模型/分类决策器/分类器(classifier)
-
分类模型的作用
- 描述性建模:作为解释性工具,用于区分不同类的对象;
- 预测性建模:预测未知记录的类标签
-
-
分类任务的类别
- 二分类:即要标记的类仅为两类;
- 多分类:类别多于两类;
- 文本分类:对文本进行分类,可能需要先分词、构建词向量、句向量等;
- 标注(tagging):可以看为分类问题的推广,也是结构预测的简单形式。
2. 分类任务的评估指标
- 评估指标即性能度量,表示真实值和预测值的关系,详细可看[模型]()一节的内容。
【混淆矩阵】
- 混淆矩阵(confusion matrix)/误差矩阵,是表示精度评价的一种标准格式。
- 在分类问题中,行表示预测的类别$\hat c$,列表示实际的类别$c$,中间则记录了$c$类预测为$\hat c$的数量。
-
以二分类问题为例,
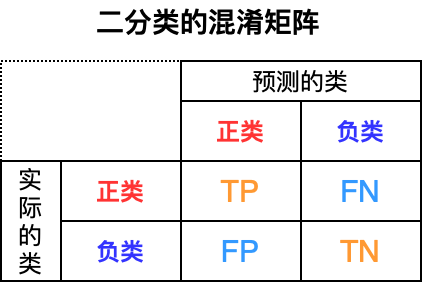
- TP:将正类预测为正类; TN:将负类预测为负类;
- FN:将正类预测为负类; FP:将负类预测为正类。
【几个指标】
- 准确率(accuracy)/精度:$acc = \frac{正确预测数}{预测总数}=\frac{TP+TN}{TP+FN+FP+TN}$
- 错误率(error rate):$error=\frac{错误预测数}{预测总数}=\frac{FP+FN}{TP+FN+FP+TN}$
- 精确率(precision)/查准率:$P=\frac{TP}{TP+FP}$
- 召回率(recall)/查全率:$R=\frac{TP}{TP+FN}$
-
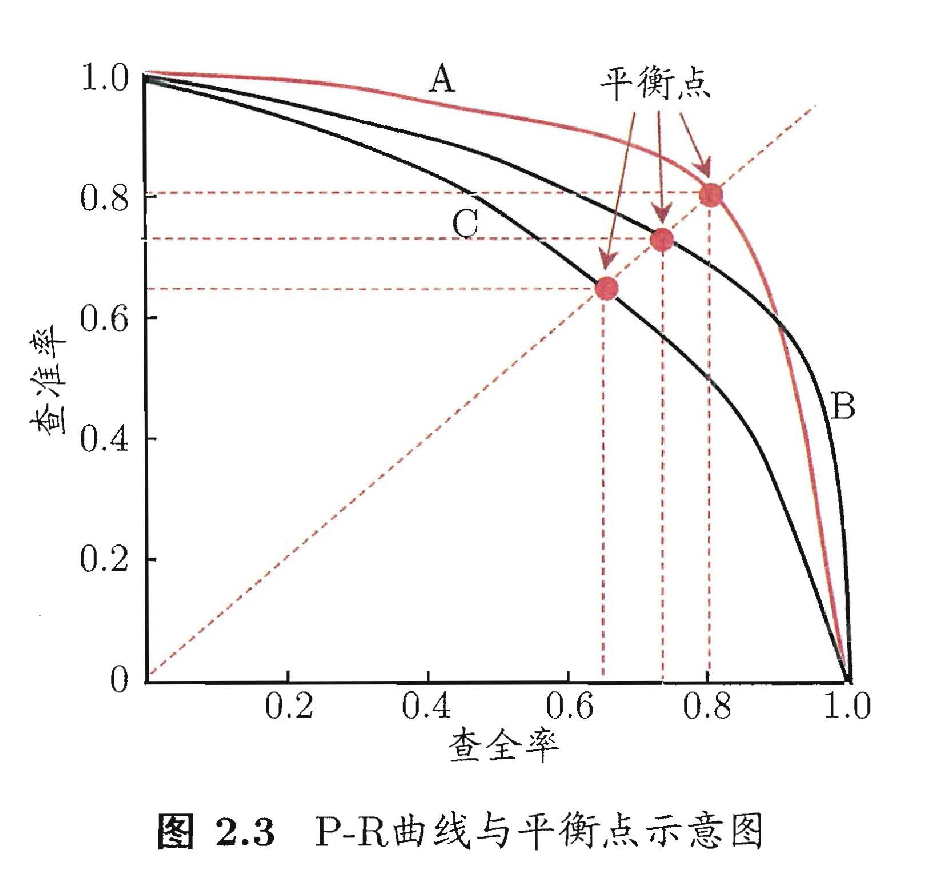
平衡点(BEP):查全率和查准率是一对矛盾的度量,绘制P-R曲线,寻找平衡点(BEP, Break-Even point),即查全率等于查准率的点,如下图(来自《机器学习》)
-
F1分数(F1 Score):$F1=\frac{2\times P\times R}{P+R}=\frac{2\times TP}{2\times TP+FP+FN}=\frac{2\times TP}{样本总量+TP-TN}$
- 即,$\frac{1}{F1}=\frac{1}{2}\cdot(\frac{1}{P}+\frac{1}{R})$
-
$F_\beta$分数:$F_\beta=\frac{(1+\beta^2)\times P\times R}{(\beta^2\times P)+R}$
- 即,$\frac{1}{F1}=\frac{1}{1+\beta^2}\cdot(\frac{1}{P}+\frac{\beta^2}{R})$
-
宏查准率、宏查全率、宏F1:对各个混淆矩阵先计算查准率、查全率
- $P_{macro}=\frac{1}{n}\sum^n_{i=1}P_i$
- $R_{macro}=\frac{1}{n}\sum^n_{i=1}R_i$
- $F1_{macro}=\frac{2\times P_{macro}\times R_{macro}}{P_{macro}+R_{macro}}$
-
微查准率、微查全率、微F1:先计算各元素的平均值,$\overline {TP}$、$\overline {FP}$、$\overline {TN}$、$\overline {FN}$
- $P_{micro}=\frac{\overline{TP}}{\overline{TP}+\overline{FP}}$
- $R_{micro}=\frac{\overline{TP}}{\overline{TP}+\overline{FN}}$
- $F1_{micro}=\frac{2\times P_{micro}\times R_{micro}}{P_{micro}+R_{micro}}$
【ROC与AUC】
- 上文我们看过了PR-曲线,与之相似的还有ROC曲线和AUC。
-
ROC曲线(Receiver Operating Characteristic):纵轴为真正例率(TPR, True Positive Rate),横轴为假正例率(FPR, False Positive Rate)
- $TPR=\frac{TP}{TP+FN}$, $FPR=\frac{FP}{TN+FP}$
-
AUC(Area Under ROC Curve):比较ROC结果的一种方式,即ROC曲线下的面积。
- 而曲线上方的面积则是排序损失loss,具体可看西瓜书。
- ROC和AUC的示例如下(图片来自《机器学习》),

【代价曲线】
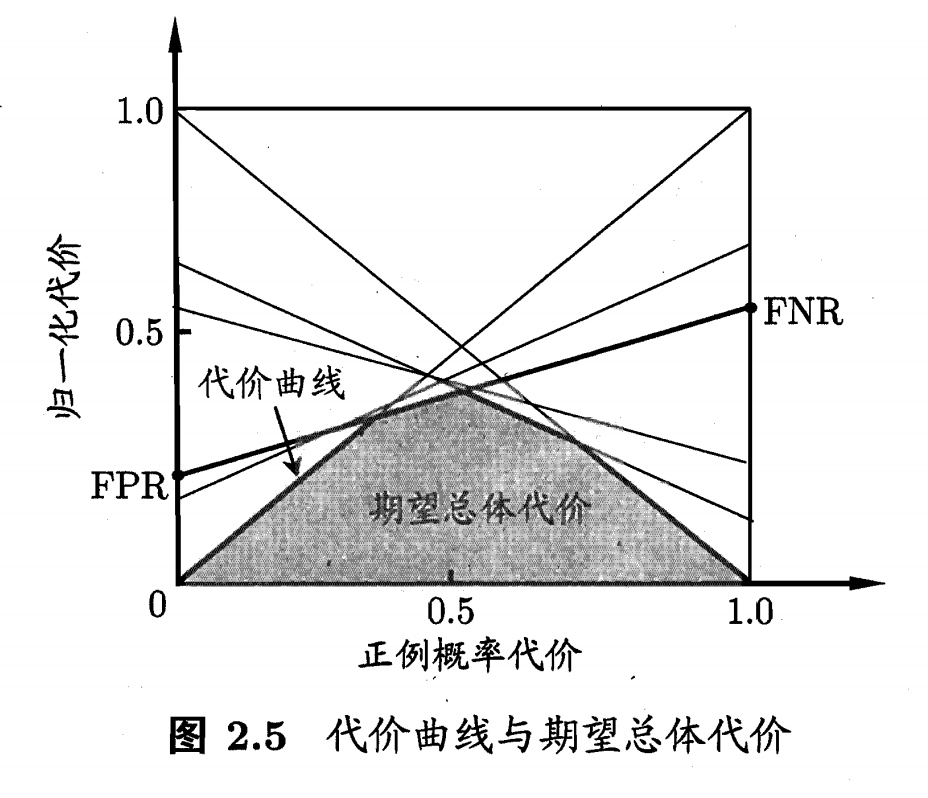
- 对应着损失函数的曲线,示例如下图(来自《机器学习》)
3. 分类任务的一般方法
- 关于方法的具体内容这里不做具体介绍,有兴趣可以查看方法篇,这里只用列表的形式来记录(关于其优缺,则等到自己都实验过后再做比较。
| 方法 | 优点 | 缺点 |
|---|---|---|
| 基于规则 | ||
| 最近邻 KNN | ||
| 决策树 | ||
| 朴素贝叶斯 NBC | ||
| 支持向量机 SVM | ||
| 人工神经网络 | ||
| AdaBoost | ||
| Rocchi |
参考资料
- 《数据挖掘导论》第4、5章
- 《统计学习方法(第2版)》第1章
- 《机器学习》第2章
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论