【并发编程】深入理解synchronized原理
文章目录
1 线程安全问题
在并发编程中,需要处理两个关键问题:线程之间如何通信及线程之间如何同步(这里的线程是指并发执行的活动实体)。
通信是指线程之间以何种机制来交换信息。Java中并发采用的是共享内存模型,在共享内存的并发模型里,线程之间共享程序的公共状态,通过写-读内存中的公共状态进行隐式通信。
而同步是指程序中用于控制不同线程间操作发生相对顺序的机制。在共享内存并发模型里,同步是显式进行的。程序员必须显式指定某个方法或某段代码需要在线程之间互斥执行。
Java内存模型(Java Memory Model,JMM)描述了Java程序中各种变量(线程共享变量)的访问规则,以及在JVM中将变量存储到内存和从内存中读取出变量这样的底层细节。
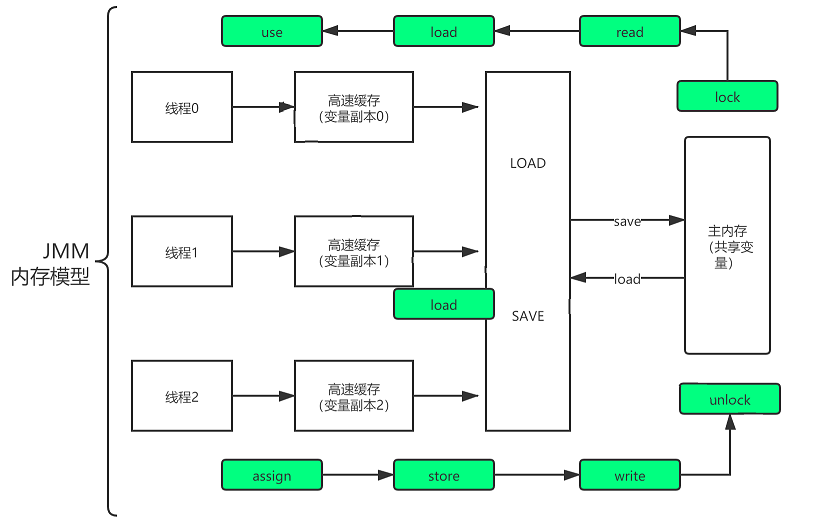 **
在Java中,所有实例域、静态域和数组元素都存储在堆内存中,堆内存在线程之间共享。由于线程的工作内存是线程私有内存,线程间无法互相访问对方的工作内存。所以线程 0 、线程 1 和线程 2需要读写主内存的共享变量时,就都先将该共享变量拷贝(load)到自己的工作内存,然后在自己的工作内存中对该变量进行所有操作,线程工作内存对变量副本完成操作之后再将结果同步(save)至主内存。
因此,在线程上下文切换期间,多线程读写共享内存中的全局变量及静态变量容易引发竞态条件。
下面用代码来说明:
@Slf4j
public class SafeTest {
    static int count = 0;

    public static void main(String[] args) throws InterruptedException {
        Thread t1 = new Thread(() -> {
            for (int i = 1; i < 5000; i++) {
                count++;
            }
        });
        Thread t2 = new Thread(() -> {
            for (int i = 1; i < 5000; i++) {
                count--;
            }
        });
        t1.start();
        t2.start();
        t1.join();
        t2.join();
        log.debug("count的值是: {}", count);
    }
}
按照常理而言,count最终结果应该为0。多次运行发现,最终count值还可能是正数,也可能为负数。这是为什么呢?
从字节码的层面进行分析:
 0 iconst_1
 1 istore_0
 2 iload_0
 3 sipush 5000
 6 if_icmpge 23 (+17)
 9 getstatic #10 <com/kai/demo/basic/SafeTest.count> // 获取静态变量i的值
12 iconst_1 // 准备常量1
13 iadd // 自增
14 putstatic #10 <com/kai/demo/basic/SafeTest.count> // 将修改后的值存入静态变量i
17 iinc 0 by 1
20 goto 2 (-18)
23 return
0 iconst_1
1 istore_0
2 iload_0
3 sipush 5000
6 if_icmpge 23 (+17)
9 getstatic #10 <com/kai/demo/basic/SafeTest.count> // 获取静态变量i的值
12 iconst_1 // 准备常量1
13 isub // 自减
14 putstatic #10 <com/kai/demo/basic/SafeTest.count> // 将修改后的值存入静态变量i
17 iinc 0 by 1
20 goto 2 (-18)
23 return可见count++ 和 count-- 操作实际都是需要这个4个指令完成的,那么这里问题就来了!Java 的内存模型如下,完成静态变量的自增、自减需要在主存和工作内存中进行数据交换。
正常顺序执行:

实际出现负数的情况:

实际出现正数的情况:

像上面count++ 和 count-- 的代码所在区域又称临界区(一段代码内如果存在对共享资源的多线程读写操作,那么称这段代码为临界区)。
跟上面案例一样。如果多个线程临界区代码执行竞争同一资源时,对资源的访问顺序敏感,执行时序的不同导致会出现某种不正常的行为,就称存在竞态条件(Race Condition)。
为避免竞态条件的出现,保证java共享内存的原子性、可见性、有序性,很有必要保持线程同步。Java中提供了synchronized、volatile关键字与Lock类。
2 初识synchronized
synchronized采用互斥同步(Mutual Exclusion & Synchnronization)的方式,让多个线程并发访问共享数据时,保证共享数据在同一时刻只被一个(或一些,使用信号量的时候)线程使用。互斥是实现同步的一种手段,临界区、互斥量和信号量都是主要的互斥实现方式。因此在互斥同步四个字中,互斥是因,同步是果;互斥是方法,同步是目的。
2.1 使用场景
在Java代码中使用synchronized可使用在代码块和方法中,根据Synchronized用的位置可以有这些使用场景:
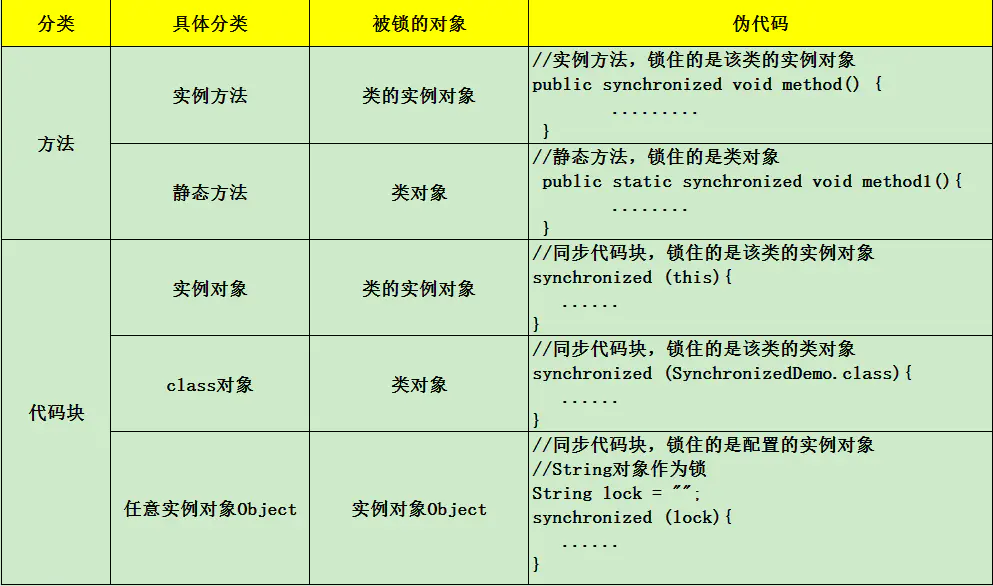
可见,synchronized的使用场景主要有3种:
- 修饰静态方法,给当前类对象加锁,进入同步方法时需要获得类对象的锁;
- 修饰实例方法,给当前实例变量加锁,进入同步方法时需要获得当前实例的锁;
- 修饰同步方法块,指定加锁对象(实例对象/是类变量),进入同步方法块时需要获得加锁对象的锁。
2.2 案例分析
下面,将synchronized应用到上面的案例中:
@Slf4j
public class SafeTest {
    static int count = 0;
    static final Object lock = new Object();

    public static void main(String[] args) throws InterruptedException {
        Thread t1 = new Thread(() -> {
            for (int i = 1; i < 5000; i++) {
                synchronized (lock){
                    count++;
                }
            }
        });
        Thread t2 = new Thread(() -> {
            for (int i = 1; i < 5000; i++) {
                synchronized (lock){
                    count--;
                }
            }
        });
        t1.start();
        t2.start();
        t1.join();
        t2.join();
        log.debug("count的值是: {}", count);
    }
}
多次测试发现,结果都为0。这是因为synchronized利用对象锁保证了临界区代码的原子性,临界区内的代码在外界看来是不可分割的,不会被线程切换所打断。

synchronized为什么这么神奇,它到底做了什么呢?下面就进一步探讨一下synchronized的实现原理。
3 synchronized原理
先来了解两个重要的概念:“Java对象头”、"锁记录"。
3.1 Java对象头
对象实例化内存布局与访问定位中描述了,JVM中对象内存布局主要分为三块区域:对象头区、实例数据区和填充区。
<img src="https://img-blog.csdnimg.cn/202010111456447.jpg" style="zoom: 67%;" />
Synchronized用到的锁就是存在Java对象头里的。对象头区又主要分为两部分,分别是 运行时元数据(Mark Word)和 类型指针。
如果对象是数组类型,则虚拟机用3个字宽(Word)存储对象头,如果对象是非数组类型,则用2字宽存储对象头。在32位虚拟机中,1字宽等于4字节,即32bit。 Java对象头具体结构描述如下:

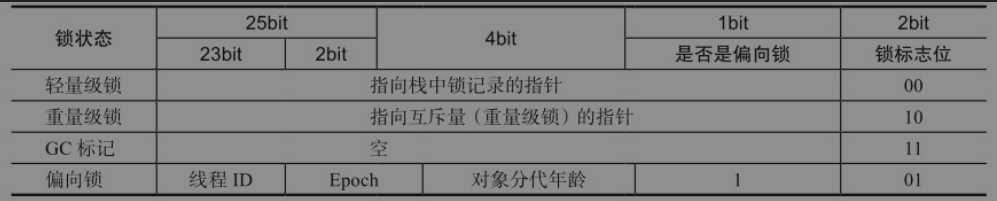
Mark Word用于存储对象自身的运行时数据,如:哈希码(HashCode)、GC分代年龄、锁状态标志、线程持有的锁、偏向线程 ID、偏向时间戳等。32位JVM的Mark Word的默认存储结构如下:

在运行期间,Mark Word里存储的数据会随着锁标志位的变化而变化。Mark Word可能变化为存储以下4种数据:
在64位虚拟机下,Mark Word是64bit大小的,其存储结构如下:

3.2 锁记录
在线程进入同步代码块的时候,如果此同步对象没有被锁定,它的锁标志位是01,则虚拟机首先在当前线程的栈中创建我们称之为“锁记录(Lock Record)”的空间,用于存储锁对象的Mark Word的拷贝,官方把这个拷贝称为Displaced Mark Word。整个Mark Word及其拷贝至关重要。
Lock Record是线程私有的数据结构,每一个线程都有一个可用Lock Record列表,同时还有一个全局的可用列表。每一个被锁住的对象Mark Word都会和一个Lock Record关联(对象头的Mark Word中的Lock Word指向Lock Record的起始地址),同时Lock Record中有一个Owner字段存放拥有该锁的线程的唯一标识(或者object mark word),表示该锁被这个线程占用。
| Lock Record | 描述 |
|---|---|
| Owner | 初始时为NULL表示当前没有任何线程拥有该monitor record,当线程成功拥有该锁后保存线程唯一标识,当锁被释放时又设置为NULL。 |
| EntryQ | 关联一个系统互斥锁(semaphore),阻塞所有试图锁住monitor record失败的线程。 |
| RcThis | 表示blocked或waiting在该monitor record上的所有线程的个数。 |
| Nest | 用来实现重入锁的计数。 |
| HashCode | 保存从对象头拷贝过来的HashCode值(可能还包含GC age)。 |
| Candidate | 用来避免不必要的阻塞或等待线程唤醒,因为每一次只有一个线程能够成功拥有锁,如果每次前一个释放锁的线程唤醒所有正在阻塞或等待的线程,会引起不必要的上下文切换(从阻塞到就绪然后因为竞争锁失败又被阻塞)从而导致性能严重下降。Candidate只有两种可能的值0表示没有需要唤醒的线程1表示要唤醒一个继任线程来竞争锁 |
3.3 Monitor原理
Monitor,常被翻译为“监视器”或者“管程”。
操作系统在面对进程/线程间同步时,所支持的最重要的同步原语即是semaphore 信号量 和 mutex 互斥量。在使用基本的 mutex 进行并发控制时,需要程序员非常小心地控制 mutex 的 down 和 up 操作,否则很容易引起死锁等问题。为了更容易地编写出正确的并发程序,在 mutex 和 semaphore 的基础上,提出了更高层次的同步原语 Monitor。
不过需要注意的是,操作系统本身并不支持 Monitor机制,Monitor是属于编程语言的范畴。例如C语言它就不支持 monitor,Java 语言支持 Monitor。Java对象则是天生的Monitor,每一个Java对象都有成为Monitor的“潜质”。这是为什么呢?
因为在Java的设计中,每一个对象自打娘胎里出来,就带了一把看不见的锁,通常我们叫“内部锁”,或者“Monitor锁”,或者“Intrinsic lock”。有了这个锁的帮助,只要把类的对象方法或者代码块用synchronized关键字修饰,就会先获取到与 synchronized 关键字绑定在一起的 Object 的对象锁,这个锁会限定其它线程进入与这个锁相关的synchronized 代码区域。而这个对象锁,也就是一个货真价实的Monitor。
因此,可以把Monitor理解为一种同步工具,也可以理解是一种同步机制,它通常被描述为一个对象。其主要特点有:
- 对象的所有方法都被“互斥”的执行。也就是说,同一个时刻,只有一个 进程/线程 能进入 Monitor 中定义的临界区。
- 通常提供singal机制。即允许正持有“许可”的线程暂时放弃“许可”,等待某个谓词成真(条件变量),而条件成立后,当前进程可以“通知”正在等待这个条件变量的线程,让他可以重新去获得运行许可。
使用synchronized给对象上锁时,该对象头的Mark Word中就被设置为指向Monitor对象的指针。Mark Word锁标识位为10,其中指针指向的是Monitor对象的起始地址。在Java虚拟机(HotSpot)中,Monitor是由ObjectMonitor实现的,其主要数据结构如下(位于HotSpot虚拟机源码objectMonitor.hpp文件,C++实现的):
  // initialize the monitor, exception the semaphore, all other fields
  // are simple integers or pointers
  ObjectMonitor() {
    _header       = NULL;
    _count        = 0;            // 记录个数
    _waiters      = 0,
    _recursions   = 0;
    _object       = NULL;
    _owner        = NULL;
    _WaitSet      = NULL;        // 处于wait状态的线程,会被加入到_WaitSet
    _WaitSetLock  = 0 ;
    _Responsible  = NULL ;
    _succ         = NULL ;
    _cxq          = NULL ;
    FreeNext      = NULL ;
    _EntryList    = NULL ;        // 处于等待锁block状态的线程,会被加入到该列表
    _SpinFreq     = 0 ;
    _SpinClock    = 0 ;
    OwnerIsThread = 0 ;
    _previous_owner_tid = 0;
}ObjectMonitor中有两个队列,_WaitSet 和 _EntryList,用来保存ObjectWaiter对象列表( 每个等待锁的线程都会被封装成ObjectWaiter对象 ),_owner指向持有ObjectMonitor对象的线程,当多个线程同时访问一段同步代码:

- 线程需要获取 Object 的锁时,会被放入 EntrySet(入口区) 中进行等待(enter)。
- 如果该线程获取到了锁(acquire),成为当前锁的 Owner。
- 如果根据程序逻辑,一个已经获得了锁的线程缺少某些外部条件,而无法继续进行下去(例如生产者发现队列已满或者消费者发现队列为空),那么该线程可以通过调用 wait 方法将锁释放(release),进入 Wait Set (等待区)中阻塞(BLOCKED)进行等待。
- 其它线程在这个时候有机会获得锁,从而使得之前不成立的外部条件成立,这样先前被阻塞的线程就可以重新进入 EntrySet 去竞争锁(acquire)。这个外部条件在 Monitor 机制中称为条件变量。
Tips:由于进入等待区只有号入口,由此可以推断,一个线程只有在持有监视器时才能执行wait操作,处于等待的线程只有再次获得监视器才能退出等待状态。
下面再从字节码角度理解一下Monitor原理:
public class Test {
    static int counter = 0;
    static final Object lock = new Object();

    public static void main(String[] args) {
        synchronized (lock) {
            counter++;
        }
    }
}
使用javap 命令反编译class文件: javap -v Test.class
public static void main(java.lang.String[]);
    descriptor: ([Ljava/lang/String;)V
    flags: ACC_PUBLIC, ACC_STATIC
    Code:
      stack=2, locals=3, args_size=1
         0 getstatic #2 <com/kai/demo/basic/Test.lock>        // <- 取得lock的引用(synchronized开始)
         3 dup                                                // 复制了一份lock临时引用
         4 astore_1                                            // lock临时引用 -> 存入局部变量表slot 1中
         5 monitorenter                                        // 将lock对象的Mark Word置为指向Monitor指针
         6 getstatic #3 <com/kai/demo/basic/Test.counter>    // <- i
         9 iconst_1                                            // 准备常数1
        10 iadd                                                // +1
        11 putstatic #3 <com/kai/demo/basic/Test.counter>    // -> i
        14 aload_1                                            // <- 取得lock临时引用,放入操作数栈栈顶
        15 monitorexit                                        // 将lock对象的Mark Word重置,唤醒EntryList
        16 goto 24 (+8)                                        // 执行到24行,代码结束
        //下面是异常处理指令。可见,如果出现异常,也能自动地释放锁。
        19 astore_2                                            // exception -> slot 2
        20 aload_1                                            // <- 取得lock的引用
        21 monitorexit                                        // 将lock对象的Mark Word重置,唤醒EntryList
        22 aload_2                                            // <- slot 2(exception)
        23 athrow                                            // throw(exception)
        24 return
      Exception table:
         from    to  target type
             6    16    19   any                            // 异常检测6-16行代码(即临时区)
            19    22    19   any
      LineNumberTable:
        line 22: 0
        line 23: 6
        line 24: 14
        line 25: 24
      LocalVariableTable:
        Start  Length  Slot  Name   Signature
            0      25     0  args   [Ljava/lang/String;
--- omit ---执行同步代码块后首先要先执行monitorenter指令,退出的时候monitorexit指令。
通过分析之后可以看出,使用Synchronized进行同步,其关键就是必须要对对象的监视器monitor进行获取,当线程获取monitor后才能继续往下执行,否则就只能等待。而这个获取的过程是互斥的,即同一时刻只有一个线程能够获取到monitor。过程大致如下:
- 如果monitor的进入数为0,则该线程进入monitor,然后将进入数设置为1,该线程即为monitor的所有者;
- 如果线程已经占有该monitor,如果重新进入,则进入monitor的进入数加1(锁的重入性);
- 如果其他线程已经占用了monitor,则该线程进入阻塞状态,直到monitor的进入数为0,再重新尝试获取monitor的所有权。
monitorexit指令执行时,monitor的进入数减1,如果减1后进入数为0,那线程退出monitor,不再是这个monitor的所有者。其他被这个monitor阻塞的线程可以尝试去获取这个 monitor 的所有权。
上面案例中,monitorexit指令出现了两次,第1次为同步正常退出释放锁,第2次为发生异步退出释放锁。
通过上面两段描述,我们应该能很清楚的看出Synchronized的实现原理,Synchronized的语义底层是通过一个monitor的对象来完成。
需要注意的是,synchronized用在同步方法上时,字节码指令中不会出现monitorenter和monitorexit指令。
例如:
public class Test1 {
    public synchronized void method() {
        System.out.println("Hello World!");
    }
}
使用javap 命令反编译class文件:javap -v Test1.class
public synchronized void method();
    descriptor: ()V
    flags: ACC_PUBLIC, ACC_SYNCHRONIZED
    Code:
      stack=2, locals=1, args_size=1
         0: getstatic     #2                  // Field java/lang/System.out:Ljava/io/PrintStream;
         3: ldc           #3                  // String Hello World!
         5: invokevirtual #4                  // Method java/io/PrintStream.println:(Ljava/lang/String;)V
         8: return
      LineNumberTable:
        line 11: 0
        line 12: 8
    --- omit ---
方法的同步并没有通过指令 monitorenter 和 monitorexit 来完成,不过相对于普通方法,其常量池中多了 ACC_SYNCHRONIZED 标示符。JVM就是根据该标示符来实现方法的同步的:
当方法调用时,调用指令将会检查方法的 ACC_SYNCHRONIZED 访问标志是否被设置,如果设置了,执行线程将先获取monitor,获取成功之后才能执行方法体,方法执行完后再释放monitor。在方法执行期间,其他任何线程都无法再获得同一个monitor对象。
两种同步方式本质上没有区别,只是方法的同步是一种隐式的方式来实现,无需通过字节码来完成。两个指令的执行是JVM通过调用操作系统的互斥原语mutex来实现,被阻塞的线程会被挂起、等待重新调度,会导致“用户态和内核态”两个态之间来回切换。
4 synchronized进阶
4.1 重量级锁
在JDK 6之前,synchronized通过监视器(Monitor)来实现线程同步,但是Monitor本质又是依赖于底层的操作系统的Mutex Lock来实现的。而操作系统要实现线程之间的切换需要从用户态转换到核心态,转换时间相对比较长,成本也非常高。因此,后来称这种锁为“重量级锁”。
JDK 6为了减少获得锁和释放锁带来的性能消耗,引入了“偏向锁”和“轻量级锁”。所以,目前锁一共有4种状态,级别从低到高依次是:无锁状态、偏向锁状态、轻量级锁状态和重量级锁状态,这几个状态会随着竞争情况逐渐升级。锁可以升级但不能降级,意味着偏向锁升级成轻量级锁后不能降级成偏向锁。这种锁升级却不能降级的策略,目的是为了提高获得锁和释放锁的效率。
四种锁状态对应的的Mark Word内容描述如下:

在64位虚拟机下,Mark Word在不同锁状态存储结构如下:

4.2 自旋
4.2.1 自旋锁
线程的阻塞和唤醒需要CPU从用户态切转为核心态,而且这种切换不易优化。如果锁的粒度很小,即锁持有的时间很短的时候。由锁竞争造成频繁地阻塞和唤醒线程就显得非常不值得,因此引入了自旋锁。
自旋锁可以减少线程阻塞造成的线程切换。其执行步骤如下:
- 当前线程尝试去竞争锁。
- 竞争失败,准备阻塞自己。
- 但是并没有阻塞自己,进入自旋状态(空等待,比如一个空的有限for循环)。
- 自旋状态下,继续竞争锁。
- 如果自旋期间成功获取锁,那么结束自旋状态,否则进入阻塞状态。
如果在自旋期间成功获取锁,那么就减少一次线程的切换。
可见,如果持有锁的线程很快就释放了锁,那么自旋的效率就非常好,反之,自旋的线程就会白白消耗掉处理的资源。所以自旋锁适合在持有锁时间短,并且竞争激烈的场景下使用。
在JDK1.6中自旋锁默认开启。可以使用-XX:+UseSpinning开启,-XX:-UseSpinning关闭自旋锁优化。
自旋的默认次数为10次,可以使用-XX:preBlockSpin参数修改默认的自旋次数。
4.2.2 适应性自旋锁
适应性自旋,是赋予了自旋一种学习能力,它并不固定自旋10次。他可以根据它前面线程的自旋情况,从而调整它的自旋。
例如,线程总是自旋成功,那么虚拟机就会允许自旋等待持续的次数更多。反之,如果对于某个锁,很少有自旋能够成功,那么在以后竞争这个锁的时,自旋的次数会减少甚至省略掉自旋过程直接进入阻塞状态,以免浪费处理器资源。
4.3 锁消除与锁粗化
4.3.1 锁消除
JVM会对不会存在线程安全的锁进行锁消除。例如使用JDK的内置API,如StringBuffer、Vector、HashTable等会存在隐形的加锁操作。
public void vectorTest(){
    Vector<String> vector = new Vector<String>();
    for(int i = 0 ; i < 10 ; i++){
        vector.add(i + "");
    }

    System.out.println(vector);
}
运行这段代码时,JVM明显检测到变量vector没有逃逸出方法vectorTest()之外,所以JVM会大胆地将vector内部的加锁操作消除。
锁消除的依据是逃逸分析的数据支持。
4.3.2 锁粗化
在遇到一连串地对同一锁不断进行请求和释放的操作时,JVM会把所有的锁操作整合成锁的一次请求,从而减少对锁的请求同步次数,这个操作叫做锁的粗化。
例如:
    for(int i = 0 ; i < 100 ; i++){
        synchronized(lock){
            // 同步块
        }
    }
锁粗化后:
    synchronized(lock){
        for(int i = 0 ; i < 100 ; i++){
           // 同步块
        }
    }
4.4 偏向锁
在大多数情况下,锁不仅不存在多线程竞争,而且总是由同一线程多次获得,为了减少此类情况下线程获得锁的性能消耗,JDK6中引进了偏向锁。
当一个线程访问同步代码块并获取锁时,会在Mark Word里存储锁偏向的线程ID。在线程进入和退出同步块时不再通过CAS操作来加锁和解锁,而是检测Mark Word里是否存储着指向当前线程的偏向锁。引入偏向锁是为了在没有多线程竞争的情况下尽量减少不必要的轻量级锁执行路径,偏向锁只需要在置换ThreadID的时候依赖一次CAS原子指令即可。

偏向锁只有遇到其他线程尝试竞争偏向锁时,持有偏向锁的线程才会释放锁,线程不会主动释放偏向锁。偏向锁的撤销,需要等待全局安全点(在这个时间点上没有字节码正在执行),它会首先暂停拥有偏向锁的线程,判断锁对象是否处于被锁定状态。撤销偏向锁后恢复到无锁(标志位为“01”)或轻量级锁(标志位为“00”)的状态。
偏向锁在JDK 6及以后的JVM里是默认启用的。可以通过JVM参数关闭偏向锁:-XX:-UseBiasedLocking=false,关闭之后程序默认会进入轻量级锁状态。
下面用OpenJDK 的 JOL 包来做实验,先添加 maven 依赖:
    <dependency>
        <groupId>org.openjdk.jol</groupId>
        <artifactId>jol-core</artifactId>
        <version>0.10</version>
    </dependency>
定义一个普通的 Java 对象:
public class Person {
    String str = "";
    Son son = new Son();
}

class Son {
}
利用 JOL 包下的 ClassLayout 来输出他的内存布局:
@Slf4j
public class BiasedLockTest {
   public static void main(String[] args) {
       Person person = new Person();
       log.debug(ClassLayout.parseInstance(person).toPrintable());
   }
}
打印结果如下:

图中的1、2、3、4分别对应 MarkWord、类型指针、实例数据、对齐填充。
- MarkWord:共8字节,该对象刚新建,锁标识位是 01,处于无锁状态。
- 类型指针:共4字节,标识新建的 person 对象。
- 实例数据:共8字节,定义的 Person 有两个属性,str 和 son对应的类型分别为 String 和 Son,这两个属性各占4个字节。
- 对齐填充:共4个字节,前三个部分字节相加为8+ 4+ 8 = 20,不是8的整数倍,所以得填充4个字节凑齐24字节。描述信息中也有说明:
loss due to the next object aligment。
上面提到,偏向锁在JDK 6及以后的JVM里是默认启用的。那为什么启动后标记位置是“001”无锁状态而不是“101”偏向锁状态呢?这是因为偏向锁默认是延迟加载的,不会在程序启动的时候立刻生效,可以通过JVM参数来避免延迟:-XX:BiasedLockingStartupDelay=0。
再次运行:

4.5 轻量级锁
偏向锁多应用只有一个线程访问同步块场景中,一旦偏向锁被其他线程访问,就会升级为轻量级锁。其他线程会通过自旋的形式尝试获取锁,不会阻塞,从而提高性能。
使用轻量级锁的多线程之间不存在锁竞争,线程是交替执行同步块的。引入轻量级锁的目的正是在没有多线程竞争的前提下,减少传统的重量级锁使用操作系统互斥量产生的性能消耗。
轻量级锁加锁过程如下:
- 在代码块进入同步块时,如果同步对象锁状态为无锁状态(锁标志位01,是否偏向锁0),虚拟机首先将在当前线程的栈帧中建立一个名为锁记录(Lock Record)的空间,用于存储锁对象目前的Mark Word的拷贝,官方称之为Displaced Mark Word。
- 拷贝对象头中的Mark Word复制到锁记录中。

- 拷贝成功后,虚拟机将使用CAS操作尝试将对象的Mark Word更新为指向Lock Record的指针,并将Lock Record里的owner指针指向对象的Mark Word。

- 如果更新动作成功了,那么这个线程就拥有了该对象的锁,此时对象Mark Word锁标志位设置为00,表示此对象处于轻量级锁定状态。

- 如果更新操作失败了,虚拟机首先会检查对象的Mark Word是否指向当前线程的栈帧,如果是,说明当前线程已经拥有了这个对象的锁,那么可用直接进入同步块继续执行。否则说明有多个线程竞争锁,若当前只有一个等待线程,则线程会通过自旋进行等待;但当自旋超过一定次数或者一个线程持有锁,一个在自旋,又来了第三个线程竞争锁,那么轻量级锁会膨胀升级为重量级锁,锁标志位设置为10。

4.6 锁膨胀/锁升级
锁升级过程:无锁—>偏向锁—>轻量级锁—>重量级锁。具体如下:

5 简析CAS
CAS全称 Compare And Swap(比较与交换),是一种无锁算法。在不使用锁(没有线程被阻塞)的情况下实现多线程之间的变量同步。
CAS算法涉及到三个操作数:
- V 内存地址存放的实际值
- A 比较的旧值
- B 更新的新值
当且仅当V的值等于A时(旧值和内存中实际的值相同),表明旧值A已经是目前最新版本的值,自然而然可以将新值 N 赋值给 V。反之则表明V和A变量不同步,直接返回V即可。当多个线程使用CAS操作一个变量时,只有一个线程会更新成功,其余失败的线程会重新尝试。也就是说,“更新”是一个不断重试的操作。
进入原子类AtomicInteger的源码,看一下AtomicInteger的定义:
public class AtomicInteger extends Number implements java.io.Serializable {
    private static final long serialVersionUID = 6214790243416807050L;

    // 获取并操作内存的数据。
    private static final Unsafe unsafe = Unsafe.getUnsafe();
    // 存储value在AtomicInteger中的偏移量。
    private static final long valueOffset;

    static {
        try {
            valueOffset = unsafe.objectFieldOffset
                (AtomicInteger.class.getDeclaredField("value"));
        } catch (Exception ex) { throw new Error(ex); }
    }

    // 存储AtomicInteger的int值,该属性需要借助volatile关键字保证其在线程间是可见的。
    private volatile int value;
接下来,我们查看AtomicInteger的自增函数incrementAndGet()的源码时,发现自增函数底层调用的是unsafe.getAndAddInt()。
    // AtomicInteger 自增方法
    public final int incrementAndGet() {
      return unsafe.getAndAddInt(this, valueOffset, 1) + 1;
    }

    // Unsafe.class
    public final int getAndAddInt(Object var1, long var2, int var4) {
        int var5;
        do {
            var5 = this.getIntVolatile(var1, var2);
        } while(!this.compareAndSwapInt(var1, var2, var5, var5 + var4));

        return var5;
}compareAndSwapInt这个函数,它也是CAS缩写的由来。通过OpenJDK 8 来查看Unsafe.cpp的源码:
// Unsafe.java
public final int getAndAddInt(Object o, long offset, int delta) {
   int v;
   do {
       v = getIntVolatile(o, offset);
   } while (!compareAndSwapInt(o, offset, v, v + delta));
   return v;
}
根据OpenJDK 8的源码我们可以看出,getAndAddInt()循环获取给定对象o中的偏移量处的值v,然后判断内存值是否等于v。如果相等则将内存值设置为 v + delta,否则返回false,继续循环进行重试,直到设置成功才能退出循环,并且将旧值返回。整个“比较+更新”操作封装在compareAndSwapInt()中,在JNI里是借助于一个CPU指令完成的,属于原子操作,可以保证多个线程都能够看到同一个变量的修改值。
后续JDK通过CPU的cmpxchg指令,去比较寄存器中的 A 和 内存中的值 V。如果相等,就把要写入的新值 B 存入内存中。如果不相等,就将内存值 V 赋值给寄存器中的值 A。然后通过Java代码中的while循环再次调用cmpxchg指令进行重试,直到设置成功为止。
6 写在最后
在并行编程过程中,很容易产生线程安全问题,比如多线程读写共享内存中的全局变量及静态变量时引发的竞态条件。
我们可以使用synchronized关键字来保持线程同步,避免上述问题发生。而synchronized是基于Monitor 机制实现的,但是Monitor本质又是依赖于底层的操作系统的Mutex Lock来实现的。而操作系统要实现线程之间的切换需要从用户态转换到核心态,转换时间相对比较长,成本也非常高。因此,后来称这种锁为“重量级锁”。
JDK 6为了减少获得锁和释放锁带来的性能消耗,引入了“偏向锁”和“轻量级锁”。所以,目前锁一共有4种状态,级别从低到高依次是:无锁状态、偏向锁状态、轻量级锁状态和重量级锁状态,这几个状态会随着竞争情况逐渐升级,性能开销也逐渐增大。这4种锁并不是相互替代的关系,它们只是在不同场景下的不同选择。
| 锁 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| 偏向锁 | 加锁和解锁不需要额外消耗, 和执行非同步方法相比仅仅存在纳秒级的差距。 | 线程间存在锁竞争, 会带来额外的锁撤销的消耗。 | 适用于只有一个线程访问同步块场景。 |
| 轻量级锁 | 竞争的线程不会阻塞, 提高了线程的响应速度。 | 如果始终得不到锁竞争的线程, 使用自旋会消耗CPU。 | 追求响应速度, 同步块执行速度非常快。 |
| 重量级锁 | 线程竞争不会使用自旋, 不会消耗CPU。 | 线程阻塞,响应时间缓慢。 | 追求吞吐量, 同步块执行时间较长。 |
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论