排序算法 part 1(冒泡排序、快速排序、简单选择排序)
文章目录
[TOC]
1、排序的概念
2、交换排序
2.1、冒泡排序及其优化
2.1.1 冒泡排序的思想
2.1.2 冒泡排序的三种优化思路
2.2、快速排序
2.2.1 快速排序的思想
2.2.2 由快速排序时间复杂度计算引申出来的问题
3、选择排序
3.1 简单选择排序
3.1.1 简单选择排序算法
3.1.2 选择排序的优化
1、排序的概念
根据排序过程中,待排序的数据是否全部被放在内存中,分为两大类:内部排序和外部排序。内部排序:指的是待排序的数据存放在计算机内存中进行的排序过程。外部排序:指的是排序过程中要对外存储器进行访问的排序过程。
其中,内部排序是排序的基础。在内部排序中,可以根据排序过程中所依据的原则将排序算法分为5类:交换排序、插入排序、选择排序、归并排序。
根据排序过程的时间复杂度来分,可以分为简单排序和先进排序。冒泡排序、简单选择排序、直接插入排序就是简单排序算法。
评价排序算法的优劣标准主要是两条:一个是算法的运算量,这主要通过记录的比较次数和移动次数来反应;另一个是执行算法所需要的附加存储单元的多少。这两个也就是老生常谈的时间复杂度和空间复杂度。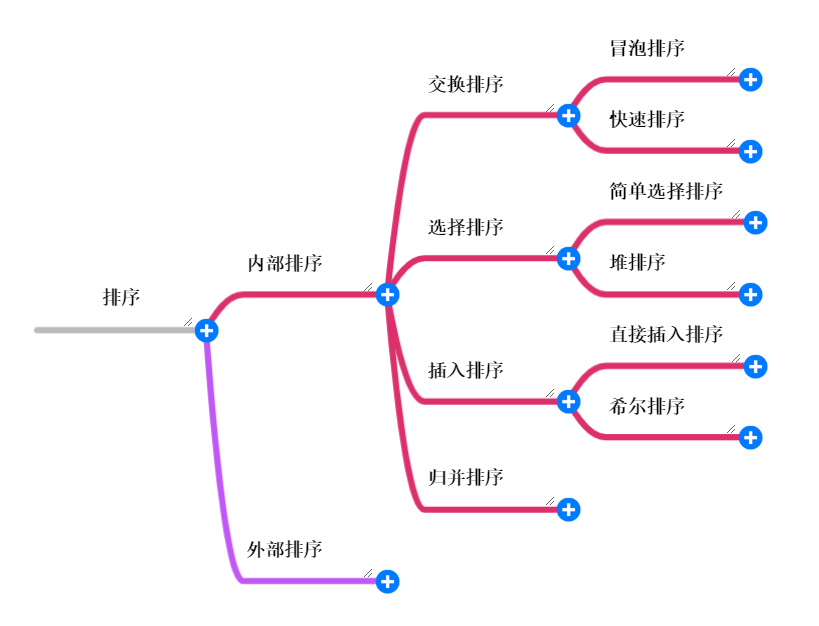
2、交换排序
2.1、冒泡排序及其优化
2.1.1 冒泡排序
冒泡排序是一种简单的排序算法。由于在排序过程中总是小数往前方,大叔往后放,相当于气泡往上升,所以称作为冒泡排序。
算法规则:
1、比较相邻的元素。如果前者比后者大,就交换它们两个。
2、每一轮都是从前往后,按照第一条规则进行,知道求出本轮最大元素,放到上一轮最大元素的前一位。
3、执行1和2,直到排序完毕。
示例:
代码实现
//用宏定义声明SWAP ,利用异或运算来实现操作
#define SWAP(a,b) {a^=b;b^=a;a^=b;}

void bubbleSort(int a[],int n)
{
    //k代表当前循环要确定的index上的值
    //最大数的第一个位置index是n-1
    k=n-1;
    //n个元素排序,一共需要进行n-1次循环
    for(i=0;i<n-1;i++)
    {
        //每次选出最大的一个数,把它放到k处
        for(j=0;j<k-1;j++)
        {
            if(a[j]>a[j+1])
                SWAP(a[j],a[j+1]);
        }
        k--;
    }
}
算法性能分析:
1、时间复杂度
冒泡排序有两层循环嵌套,第一层是n的函数。第二层是k的函数,而k又是n的函数,第二层也是n的函数。所以冒泡排序的时间复杂度是O(n*n)。
2、空间复杂度
冒泡排序中除了声明一些变量之外,再没有使用和n相关的内存了,所以空间复杂度是O(1)。
3、排序稳定性
冒泡排序是一个稳定的排序算法。
2.1.2 冒泡排序的三种优化思路
第一种优化思路:
假设我们现在排序 a[]={1,2,3,4,5,6,7,8,10,9}这组数据,首先我们分析这组数的特点,是前面的数大部分有序,后面小部分无序。如果我们按照冒泡排序的思想,在第一次循环遍历的时候,就将10和9进行了交换,这个时候数组已经变成有序了,但是依旧会循环遍历8次,接下来的8次是多余的,什么也没做。所以我们可以在交换的地方加一个标记,如果某一趟排序没有交换元素,说明这组数据已经有序了。
//a为数组,n为数组元素个数
void bubbleSortOptimize_1(int a[],int n)
{
    //flag用来标记是否进行过交换,0为没交换,1为交换了
    int flag;
    //k用来标记当前循环要确定的index下标,初始下标是数组最后一位
    int k=n-1;
    //n个元素,需要进行n-1次遍历
    for(i=0;i<n-1;i++)
    {
        flag=0;
        for(j=0;j<k-1;j++)
        {
            if(a[j]>a[j+1])
            {
                //条件成立,需要执行交换动作
                SWAP(a[j],a[j+1]);
                flag=1;
            }
        }
        //如果内层for循环一次,一次交换都没有发生,则意味着数组有序
        if(flag==0)
            return;

        k--;

    }

}
第二种优化思路:
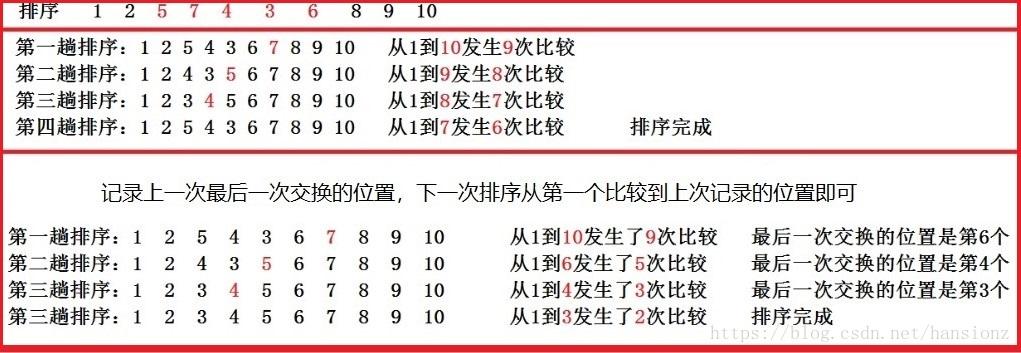
第一种优化思路仅适用于前面大部分有序后面小部分无序的数据(例如:1,2,3,4,7,6,5),但是对于前面大部分是无序而后面小部分有序的数据(例如:1,2,5,7,4,3,6,8,9,10)的排序效率也不可观。
对于前面大部分无序后面小部分有序这种类型的数据,我们可以继续优化,即我们可以记录下最后一次交换的位置,后面没有交换,必然是有序的,然后下一次排序从第一个比较到上次记录的位置结束即可。
void bubbleSortOptimize_2(int a[],int n)
{
    //k用来表示在一次内层循环中,最大值需要放置的位置index
    int k=n-1;
    //flag来自于优化思路1
    int flag;
    //利用pos来记录最后一次交换的位置
    int pos;

    for(i=0;i<n-1;i++)
    {
        pos=0;
        flag=0;
        for(j=0;j<k-1;j++)
        {
            if(a[j]>a[j+1])
            {
                SWAP(a[j],a[j+1]);
                flag=1;
                pos=j;
            }
        }
        if(flag==0)
            return;
        k=pos; //下一次比较到记录位置即可

    }

}
第三种优化思路
第二种优化思路的效率有了很大的提升,还有一种优化方法可以继续提高效率。大致思想就是一次排序可以确定两个数的位置,正向扫描找到最大值交换到最后,反向扫描找到最小值交换到最前面。例如:排序数据1,2,3,4,5,6,0。
void bubbleSortOptimize_3(int a[],int n)
{
    int maxPos=n-1;//记录最大值的下标
    int minPos=0; //记录最小值的下标

    int flag; //来源于优化思路一
    int swapPos; //来源于优化思路二

    //首先确定外层循环次数,一次确定2个数,则进行n/2次循环即可
    for(int i=0;i<n/2;j++)
    {
        flag=0;
        swapPos=0;
        //正向寻找最大值
        for(j=0;j<maxPos;j++)
        {
            if(a[j]>a[j+1])
            {
                SWAP(a[j],a[j+1]);
                flag=1; //发生交换
                swapPos=j;//记录最后一次交换的为知
            }
        }
        if(flag==0)//如果没有交换过元素,则已经有序
            return;
        maxPos=swapPos; //下一次比较到记录位置即可
        //反向寻找最小值
        for(j=maxPos;j>minPos;j--)
        {
            if(a[j]<a[j-1])
            {
                SWAP(a[j],a[j-1]);
            }
        }

        minPos++;
    }

}
2.2、快速排序
2.2.1 快速排序的思想
快速排序是由东尼霍尔所发明的一种排序算法,它采用分治的思想,首先在要排序的序列中选取一个基准数(一般选取序列的第一个),将序列分成两部分,其中基准数的左边都是小于基准数的数,基准数的右边都是大于或等于基准数的数。这样,基准数的位置在序列中的位置就固定了,然后将基准数两遍的序列进行相同的处理,直到最后一个序列只有一个数字,这样算法就完成了。
算法规则:
1、从数列中挑出一个元素,称为基准;
2、所有元素比基准值小的摆在基准值的左边,比基准值大的摆在基准值的右边(相同的可以在任意一边);
3、把小于基准值的子序列和大于基准值的子序列按上述规则递归排序。
举例:
代码实现:
void QuickSort(int a[],int begin,int end)
{
    if(begin>=end) return;

    //把这个当做基准,一般选择数组第一个元素
    int baselineValue=a[begin];
    int baselineIndex=begin;
    int i=begin;
    int j=end;
    while(i<j)
    {
        //从右到左寻找第一个小于基准的数
        while(i<j && a[j]>=baselineValue)
            j--;
        if(i<j) //则是a[j]<baselineValue
        {
            a[i]=a[j];
            i++;
        }
        //从左到右寻找第一个大于基准的数
        while(i<j && a[i]<=baselineValue)
            i++;
        if(i<j) //则是a[i]>baselineValue
        {
            a[j]=a[i];
            j--;
        }
    }
    //跳出while循环的条件是i=j,此时就是基准应该放的位置
    a[i]=baselineValue;
    baselineIndex=i;

    //递归调用,基准左右两边的子序列分别进行排序
    QuickSort(a,begin,baselineIndex-1);
    QuichSort(a,baselineIndex+1,end);

}
算法性能分析:
1、时间复杂度
快速排序的最坏时间复杂度是O(n*n),最坏情况是序列逆向有序,这样每次基准的位置都是在最边上,两个子序列其中有一个子序列为空。
快速排序的平均时间复杂度是O(n*logn)。这个平均时间复杂度是怎么计算出来的?
首先我们知道快速排序是一个递归算法,而递归算法的时间复杂度=递归次数*每次递归遍历的次数。
我们可以把快速排序近似想象成一个完全二叉树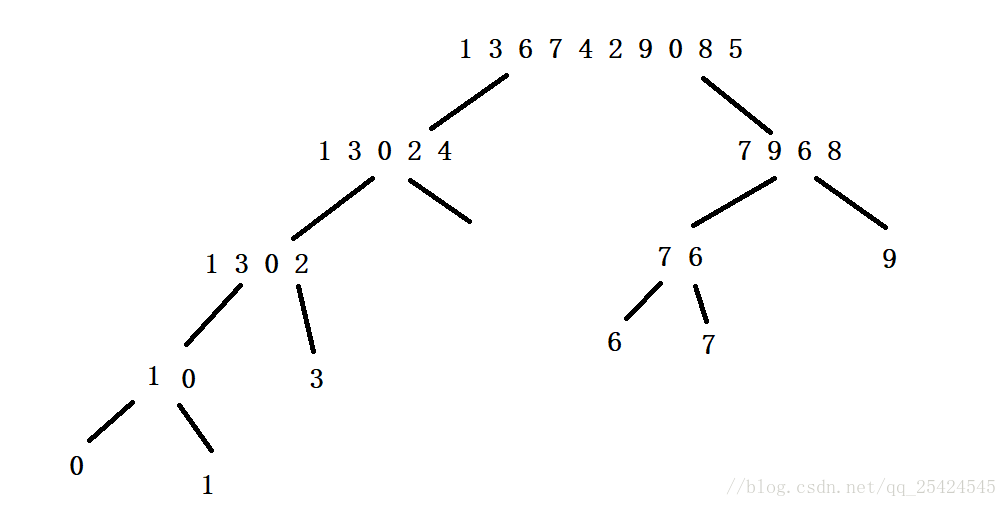
一个数组的容量是n,第一层遍历的次数是n,因为数组里每个数字都需要和key比较,那么接下来遍历分出来的两个区间,总的遍历次数还是会近似是N,以此类推,直到分为最后一个,也就是说每次递归的遍历次数是N。
而树的高度是logn,也就是递归次数是logn,所以总的时间复杂度是n*logn。
2、空间复杂度
在对序列的操作过程中只需要花费常数级别的空间,空间复杂度为S(1)。但需要注意递归调用需要花费最少S(logn),最多S(n)的空间。
最少的情况是:每次基准的位置都能将序列对半分。
最多的情况是:每次基准的位置都在边缘,这样的话,子序列就只有一个。这样递归调用是一个链式,链上有n个节点。
3、排序稳定性
快速排序是一种不稳定的排序算法
2.2.2 由快速排序时间复杂度计算引申出来的问题
有100万个无序数字,请找出位置排在第10万的数字。
这个问题,首先不是大数据的问题,内存是可以放下的,这是快速排序的变形问题。位置在第10万,其实就是让我们找基准下标在第10万。
int PartSort(int a[],int begin,int end)
{

    int div=begin; //基准下标
    int divValue=a[begin]; //基准的值
    int i=begin;
    int j=end;

    while(i<j)
    {
        //从右往左找小于基准的数
        while(i<j&&a[j]>divValue)
            j--;
        if(i<j) //a[i]<divValue
        {
            a[i]=a[j]
            i++;
        }
        //从左往右找大于基准的数
        while(i<j&&a[i]<divValue)
            i++;
        if(i<j) //a[i]>divValue
        {
            a[j]=a[i]
            j--;
        }
    }
    //跳出循环i=j
    a[i]=divValue;
    div=i;
    return div; //返回基准此刻的下标
}
//快速排序
void QuickSort(int a[],int begin,int end)
{
    if(begin>=end)
        return;
    int div=PartSort(a,begin,end);
    QuickSort(a,begin,div-1);
    QuickSort(a,div+1,end);
}


//快速排序变种问题的求解
int find_10wan_from_100wan(int a[],int begin,int end)
{
    if(begin>=end)
        return;

    int div=PartSort(a,begin,end);
    if(div==100000)
        return a[div];
    else if(div>100000)
        find_10wan_from_100wan(a,begin,div-1);
    else
        find_10wan_from_100wan(a,div+1,end);
}
变种问题的时间复杂度分析(这块暂定,不是很懂)
这个代码的时间复杂度是多少呢?我们可以用树形结合的方法,这个算法相当于一直走树的一个枝,另外一个枝没有走,我们假定走的是左枝,这其实就相当于变成了单链表,那遍历单链表的时间复杂度其实就是O(n),所以,这个算法的时间复杂度是O(n)。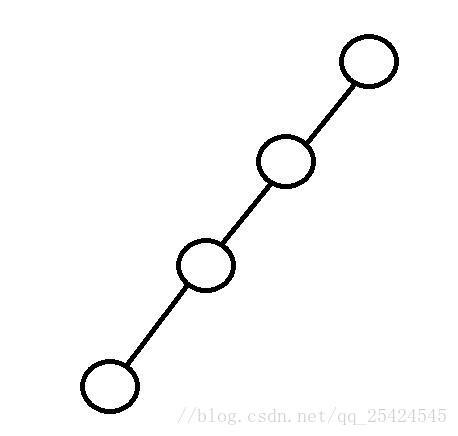
3、选择排序
3.1 简单选择排序
3.1.1 简单选择排序算法
选择排序是一种简单的排序算法。算法的思想主要是:
1、初始状态,将一个数组元素分为无序区和有序区,有序区为空,无序区初始为a[0...n-1].
2、第1趟排序:在无序区a[0...n-1]中选出关键字最小的元素a[k],将它和无序区的第一个元素a[0]交换,使得有序区变成a[0],无序区缩减为a[1...n-1]。
3、第i趟排序:经过i趟排序,此时有序区为a[0... i-1],无序区变成a[i...n-1]。
4、第i+1趟排序:经过前面i趟排序,此时有序区为a[0... i-1],无序区变成a[i...n-1]。从无序区a[i...n-1]中选出关键字最小的记录a[k],与无序区第一个元素a[i]进行交换,使得有序区变成a[0...i],无序区缩减变成a[i+1....n-1]。
这样,数组长度为n,直接选择排序经过n-1趟排序可以得到有序结果。

代码实现
void SelectSort(int a[],int n)
{
    int min;
    //确定循环次数,n个数,只需要选n-1次即可
    for(int i=0;i<n-1;i++)
    {
        min=i;
        //从无序区a[i...n-1]中选出最小的数,放到a[i]处
        //使得有序区变成a[0..i],无序区变成a[i+1...n]
        for(int j=i+1;j<n;j++)//这个for循环用来选出最小数
        {
            if(a[j]<min)
                min=j;
        }
        if(a[i]>a[j])
            SWAP(a[i],a[j]);

    }

}
算法性能分析
1、时间复杂度
选择排序的时间复杂度是O(n*n),但是选择排序的性能要优于冒泡排序。
2、空间复杂度是O(1)
3、排序稳定性
选择排序是一个不稳定的排序算法
3.1.2 选择排序的优化
简单的选择排序是一次确定一个元素的位置,而选择排序的优化则是一次确定两个元素的位置,比如说升序排列,每次将最小值放到起始位置,将最大值放到末尾位置。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论