Using Flume要点

文章目录
flume是什么
可靠的,可扩展的大数据搬运系统,从数据生产者到数据最终目的地之间充当缓冲的角色,平衡数据生产者和消费者,提供稳定的流状态。
主要的目的地以hdsf以及hbase为主。
类似的有apache kafka以及facebook的scribe。
为什么要使用flume
把数据存储到hdfs或者hbase并不是简单地调用api那样简单,这里得考虑各种复杂的场景,比如并发写入的量以及hdfs及hbase的系统压力,网络延迟等等问题。
flume设计为灵活的分布式系统,提供可定制化的管道,保证不会丢失数据,提供持久的channel
flume的构成
agent为其基本单元(每个agent包括source、channel、sink三大部分)
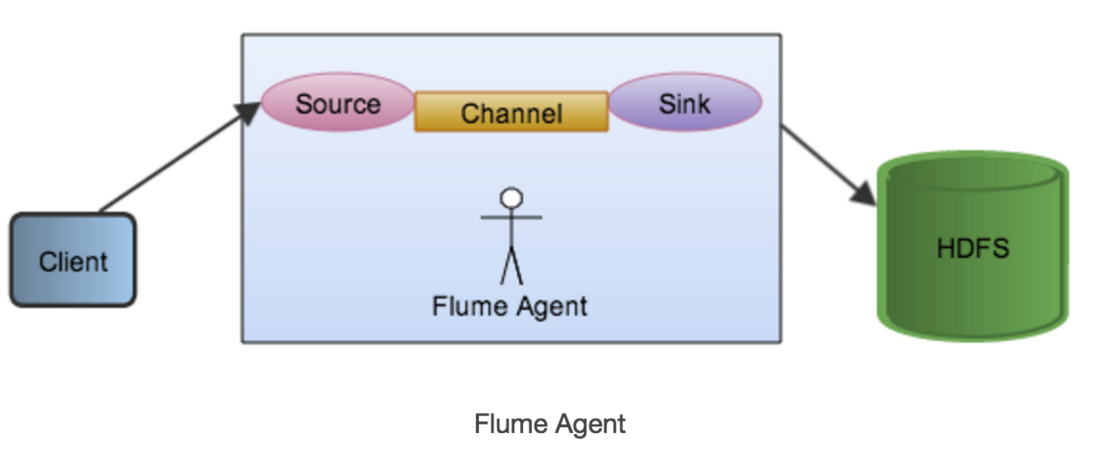
source,负责捕获数据到agent
source拦截器,修改或删除事件
Avro Source
Exec Source
Spooling Directory Source
NetCat Source
Sequence Generator Source
Syslog Sources
Syslog TCP Source
Multiport Syslog TCP Source
Syslog UDP Source
HTTP Source
channel,一个缓冲区,负责在成功写入数据到sink之前,保存source已经接收的数据
channel过滤器/选择器(
对事件应用过滤条件,决定事件应该写入到哪个source附带的channel中)内置channel
Memory Channel
File Channel
JDBC Channel
-
channel处理器(
处理事件写入channel)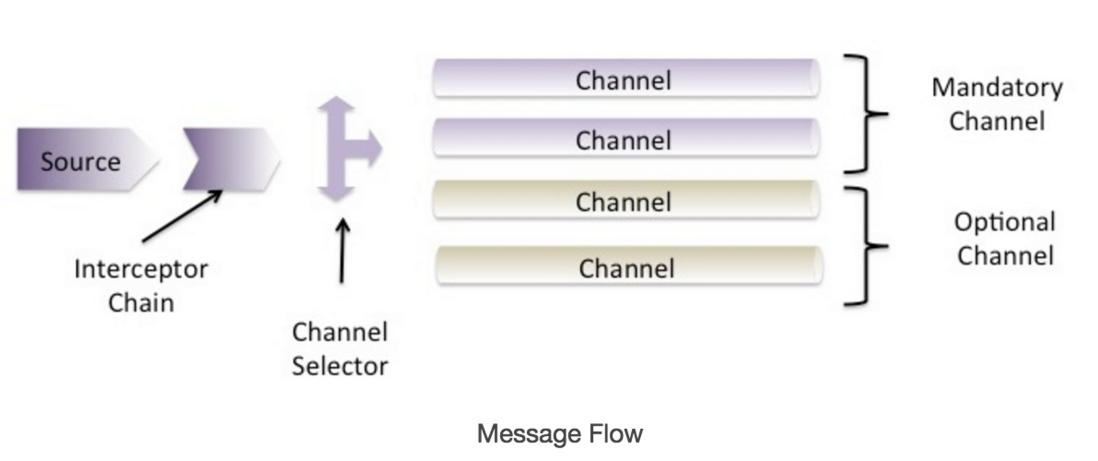
sink,负责从channel移走数据到目的地或下一个agent
sink运行器(
事件处理分发)sink组(
包含多个sink)sink处理器(
从channel取数据写入到目的地)
内置sink
HDFS Sink
Logger Sink
Avro Sink
IRC Sink
File Roll Sink
Null Sink
HBaseSinks
ElasticSearchSink
事件
flume把数据表示为事件,事件包括byte数组的主体以及map形式的报头(路由信息)
拦截器

内置拦截器
Timestamp Interceptor
Host Interceptor
Static Interceptor
UUID Interceptor
Morpline Interceptor
Regex Filtering Interceptor
Regex Extractor Interceptor
适用场景
数据可以表示为多个独立记录
实时推送持续而且量级很大的数据流(
如果每几个小时有几G的数据,不损害hdfs,没必要部署flume)
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论