Python爬虫极速入门
文章目录
想要学习爬虫,我们先需要解决四个问题:
- 了解Python基础语法
- 了解HTML语法结构
- 了解网络爬虫的基本原理
- 掌握HTTP爬虫请求库
一、什么是爬虫?
网络爬虫,其实网络数据采集更容易理解。就是通过编程向网络服务器请求数据(HTML表单),然后解析HTML,提取出自己想要的数据。
归纳为四大步:
1、确定要采集数据网站的url地址信息
2、根据url地址发起请求,获取网页源代码
3、对获取到的网页源代码进行解析,找到需要抓取的数据
4、对解析出来的数据进行存储
这会涉及到数据库、网络服务器、HTTP协议、HTML、网络安全、图像处理等非常多的内容。但对于初学者而言,并不需要掌握这么多。
二、Python要学习到什么程度
如果你不懂Python的话,那么需要先学习Python这门非常easy的语言(相对其它语言而言),跟一起学习就对啦,嘻嘻~
刚开始入门爬虫,需要掌握语法逻辑,比如列表、字典、字符串、if语句、for循环等最核心的东西,需要熟悉Python基础语法。
三、为什么要懂HTML
前面说到过爬虫要爬取的数据藏在网页里面的HTML里面的数据,有点绕哈,不要急,现在就来给你讲讲~
维基百科是这样解释HTML的
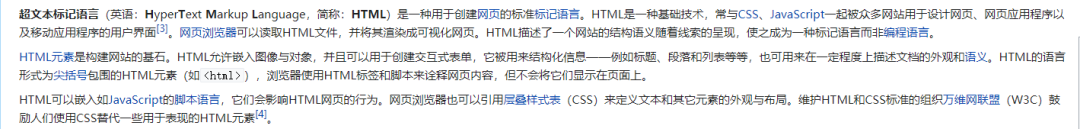
简单来讲,HTML是一种用于创建网页的标记语言,里面嵌入了文本、图像等数据,可以被浏览器读取,并渲染成我们看到的网页样子。
所以我们需要先爬取HTML,再解析数据,因为数据藏在HTML里。
学习HTML并不难,它并不是编程语言,你只需要熟悉它的标记规则,这里大致讲一下:
HTML标记包含标签(及其属性)、基于字符的数据类型、字符引用和实体引用等几个关键部分。
HTML标签是最常见的,通常成对出现,比如<h1>与</h1>。
这些成对出现的标签中,第一个标签是开始标签,第二个标签是结束标签。两个标签之间为元素的内容(文本、图像等),有些标签没有内容,为空元素,如<img>。
以下是一个经典的Welcome to html 程序的例子:
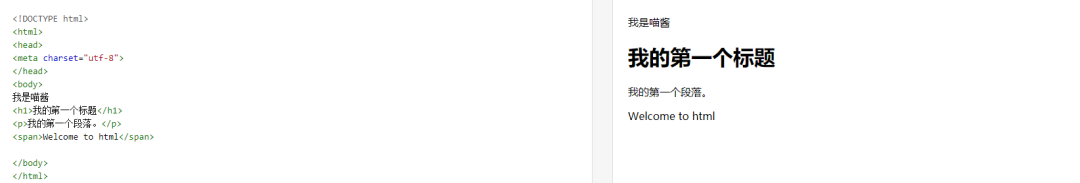
HTML文档由嵌套的HTML元素构成。它们用HTML标签表示,包含于尖括号中,如<p>
在一般情况下,一个元素由一对标签表示:“开始标签”<p>与“结束标签”</p >。元素如果含有文本内容,就被放置在这些标签之间。
四、了解Python网络爬虫的基本原理
在编写Python爬虫程序时,只需要做以下两件事:
👉发送GET请求,获取HTML
👉解析HTML,获取数据
这两件事,Python都有相应的库帮你去做,你只需要知道如何去用它们就可以了。
模块可以实现很多功能,就像是一个强大的工具箱,需要什么功能,就调用相关模块,甚至你还可以自己定义一个模块来达到你所需的功能
五、用Python库爬取百度首页标题
首先,发送HTML数据请求可以使用Python模块库requests,该库有一个get函数,可以根据url获取HTML文件,这里尝试获取百度首页“https://www.baidu.com/” 的HTML内容。
模块可以实现很多功能,就像是一个强大的工具箱,需要什么功能,就调用相关模块,甚至你还可以自己定义一个模块来达到你所需的功能~这个在我们后面爬虫的课程里面会讲到
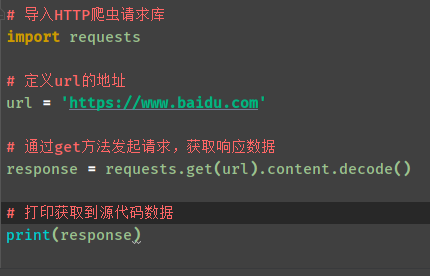
看下效果~

我们来看一下真正百度首页html是什么样的,如果你用的是谷歌浏览器,打开百度主页---鼠标点击右键---点击检查,就可以看到了:
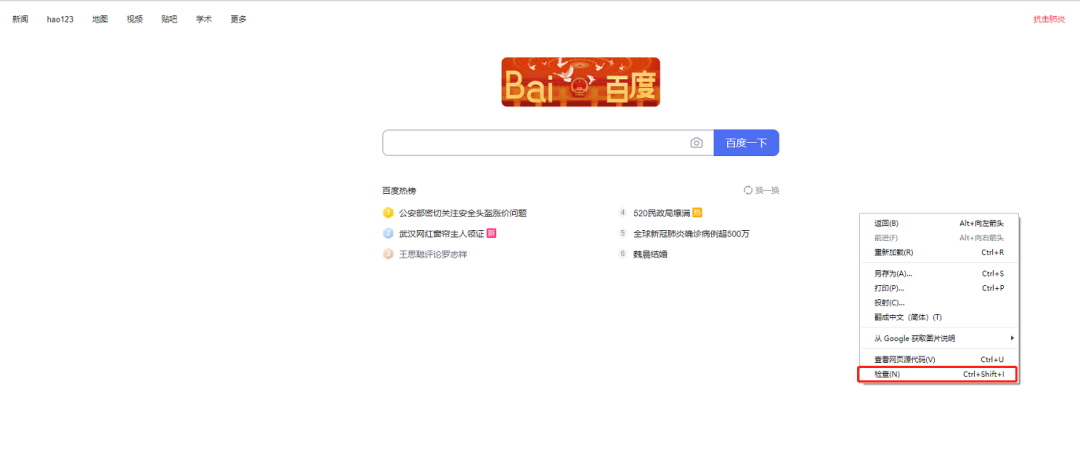
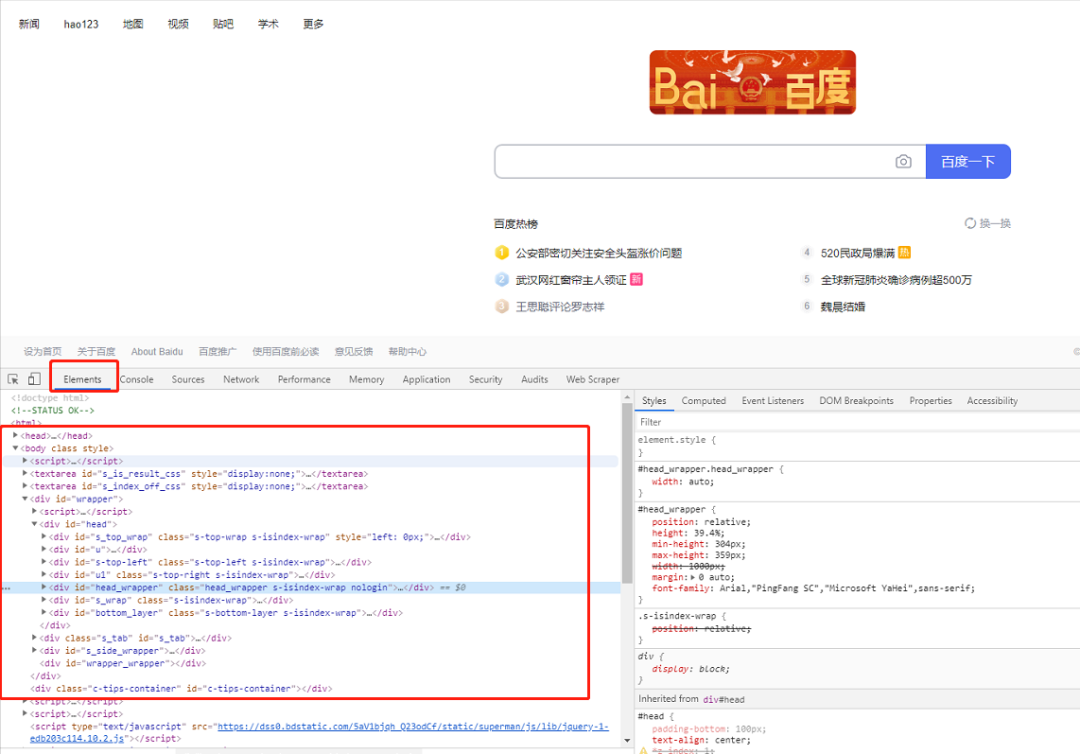
对比一下你就会知道,刚才通过Python程序获取到的HTML和网页中的一样!
获取了HTML之后,接下就要解析HTML了,因为你想要的文本、图片、视频都藏在HTML里,你需要通过某种手段提取需要的数据。
Python同样提供了非常多且强大的库来帮助你解析HTML,这里以著名的Python库lxml为工具来解析上面已经获取的HTML。
lxml是第三方库,需要安装使用。在命令行用pip安装就可以了:
pip install lxml
lxml会将HTML内容转换成结构化内容,你只要从结构化标签里面提取数据就OK了。
比如,我想获取百度首页的标题“百度一下,我就知道”,怎么办呢?
在整个网页中<title>标签是唯一的,因此我们只需要匹配title标签包裹的文本内容即可。
看看结果:
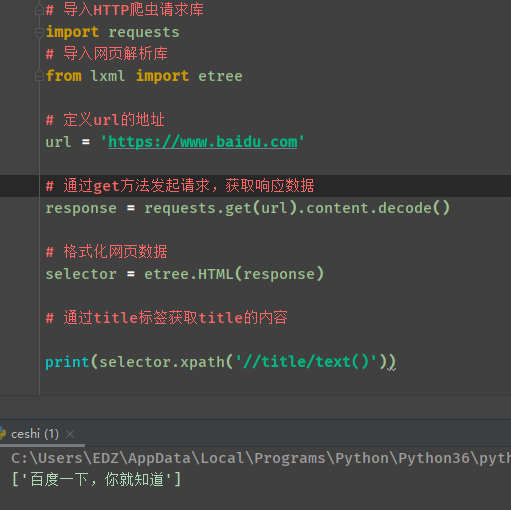
这样就搞定了,成功提取出百度首页的标题。
怎么样是不是很简单呢,对于其他的数据也是一样的,首先分析数据在网页中的结构,再针对性的进行匹配就可以啦。
想要成为一名合格的爬虫攻城狮,必须要学会
在战略上藐视:
“所有网站皆可爬”:互联网的内容都是人写出来的,而且都是偷懒写出来的(不会第一页是a,下一页是8),所以肯定有规律,这就给人有了爬取的可能,可以说,天下没有不能爬的网站
“框架不变”:网站不同,但是原理都类似,大部分爬虫都是从 发送请求——获得页面——解析页面——下载内容——储存内容 这样的流程来进行,只是用的工具不同
在战术上重视:
持之以恒,戒骄戒躁:对于初学入门,不可轻易自满,以为爬了一点内容就什么都会爬了,爬虫虽然是比较简单的技术,但是往深学也是没有止境的(比如搜索引擎等)!只有不断尝试,刻苦钻研才是王道!
然后,需要一个宏伟的目标,来让你有持续学习的动力(没有实操项目,真的很难有动力)
比如,
我要爬整个知乎!
我要爬整个微博!
我要爬各种爱奇艺视频!...
当然啦,这一切的一切,要先扪心自问,自己的Python基本功吼不吼啊?
掌握本文讲的知识点,你就已经入门Python爬虫了。加油吧,小可爱们
以上就是本次分享的所有内容,如果你觉得文章还不错,欢迎关注公众号:Python编程学习圈,每日干货分享,发送“J”还可领取大量学习资料,内容覆盖Python电子书、教程、数据库编程、Django,爬虫,云计算等等。或是前往编程学习网,了解更多编程技术知识。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论