Redis 迭代器(全遍历)
文章目录
字典迭代器主要用于迭代整个字典(dict)中的数据,必然会出现一个问题,如果在迭代的过程中出现的数据增删改查,则可能导致 字典的 rehash操作,从而导致一条数据可能会被多次遍历。一、迭代器数据结构
typedef struct dictIterator {
    dict *d;
    long index;
    int table, safe;
    dictEntry *entry, *nextEntry;
    /* unsafe iterator fingerprint for misuse detection. */
    long long fingerprint;
} dictIterator;- *d 迭代器的字典
- index 当前迭代到 hash 表中的哪个索引
- table 用于表示当前迭代的hash表,ht[0]和ht[1]。
- safe 用于表示当前创建的是否为安全的迭代器。
- *entry 当前迭代的节点。
- *nextEntry 下一个迭代的节点
- fingerprint 字典的指纹,用于验证字典数据是否数据变化过
二、迭代器的Api
dictIterator *dictGetIterator(dict *d); //初始化迭代器
dictIterator *dictGetSafeIterator(dict *d); //初始化安全迭代器
dictEntry *dictNext(dictIterator *iter); //获取下一个迭代的节点
void dictReleaseIterator(dictIterator *iter); //释放迭代器
三、dictFingerprint函数,用于计算字典中ht[0]和ht[1]中所有的值组成的hash值。用来保证字典迭代的数据的准确性。
long long dictFingerprint(dict *d) {
    long long integers[6], hash = 0;
    int j;

    integers[0] = (long) d->ht[0].table;
    integers[1] = d->ht[0].size;
    integers[2] = d->ht[0].used;
    integers[3] = (long) d->ht[1].table;
    integers[4] = d->ht[1].size;
    integers[5] = d->ht[1].used;

    /* We hash N integers by summing every successive integer with the integer
     * hashing of the previous sum. Basically:
     *
     * Result = hash(hash(hash(int1)+int2)+int3) ...
     *
     * This way the same set of integers in a different order will (likely) hash
     * to a different number. */
    for (j = 0; j < 6; j++) {
        hash += integers[j];
        /* For the hashing step we use Tomas Wang's 64 bit integer hash. */
        hash = (~hash) + (hash << 21); // hash = (hash << 21) - hash - 1;
        hash = hash ^ (hash >> 24);
        hash = (hash + (hash << 3)) + (hash << 8); // hash * 265
        hash = hash ^ (hash >> 14);
        hash = (hash + (hash << 2)) + (hash << 4); // hash * 21
        hash = hash ^ (hash >> 28);
        hash = hash + (hash << 31);
    }
    return hash;
}
四、普通迭代器 (以 sort来测试)
普通迭代器迭代字典时,会对迭代器中的 fingerprint 字段进行严格的检验,来保证迭代中字典的数据不会发生变化,保证迭代的数据不会出现重复。
普通迭代器:在有序集合遍历、sort命令时。
一、命令行代码,输入以下
127.0.0.1:6379> zadd sort 1 100
(integer) 1
127.0.0.1:6379> zadd sort 2 200
(integer) 1
127.0.0.1:6379> zadd sort 3 300
(integer) 1
127.0.0.1:6379> sort sort
2、使用gdb 断点在 b dictGetIterator函数。
(gdb) b dictGetIterator
Breakpoint 1 at 0x42cc00: dictGetIterator. (3 locations)
(gdb) c
Continuing.
3、初始化迭代器。
dictGetIterator 函数初始化
dictIterator *dictGetIterator(dict *d)
{
    dictIterator *iter = zmalloc(sizeof(*iter));

    iter->d = d;
    iter->table = 0;
    iter->index = -1;
    iter->safe = 0;
    iter->entry = NULL;
    iter->nextEntry = NULL;
    return iter;
}
如图: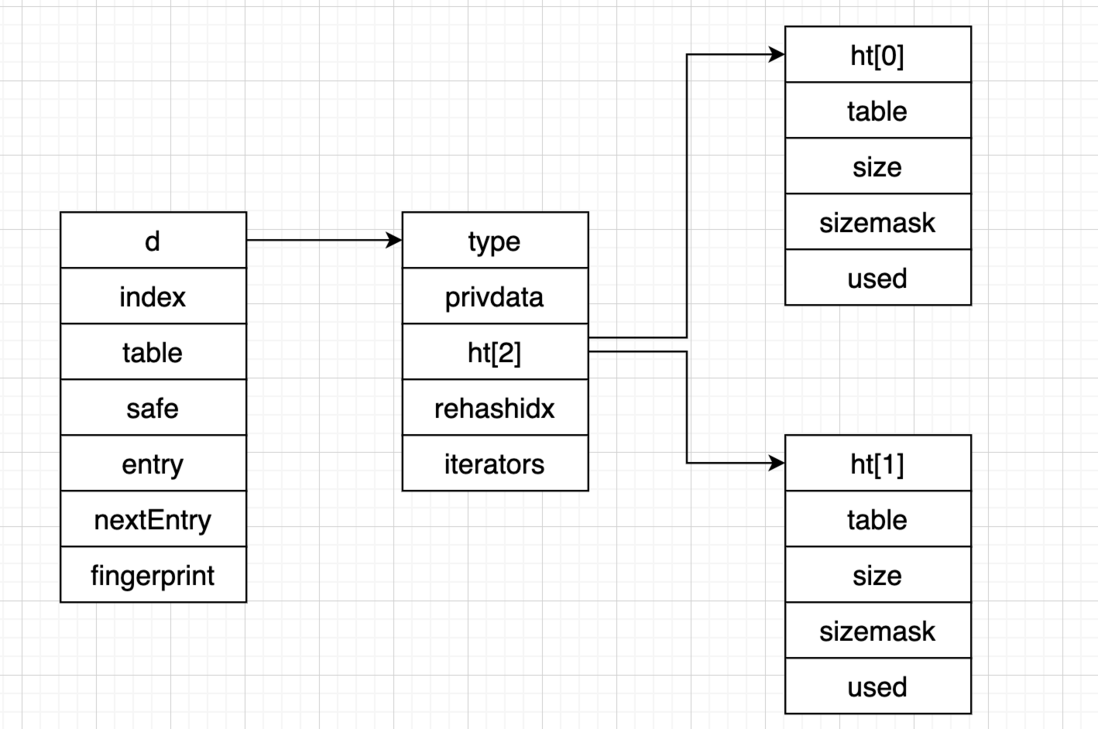
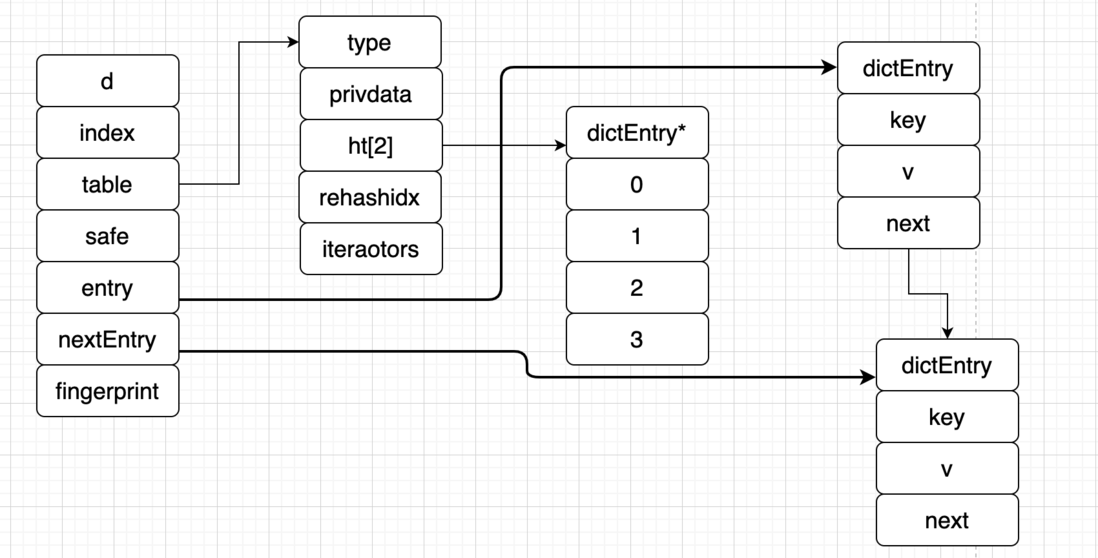
4、循环调用 dictNext 函数遍历 字典中的 dictEntry 节点。
gdb结果:{d = 0x7ff810c0d400, index = 1, table = 0, safe = 0, entry = 0x7ff810c28fc0, nextEntry = 0x7ff810c2a688, fingerprint = 6114603812730110666}
如图:
5、dictReleaseIterator 迭代器释放,
1、使用 assert(iter->fingerprint == dictFingerprint(iter->d)); 验证指纹,如果不通过则异常。
gdb结果
599         if (!(iter->index == -1 && iter->table == 0)) {
(gdb)
600             if (iter->safe)
(gdb)
603                 assert(iter->fingerprint == dictFingerprint(iter->d)); //验证指纹
(gdb)
605         zfree(iter);
(gdb)
606     }
代码
void dictReleaseIterator(dictIterator *iter)
{
    if (!(iter->index == -1 && iter->table == 0)) {
        if (iter->safe)
            iter->d->iterators--;
        else
            assert(iter->fingerprint == dictFingerprint(iter->d));
    }
    zfree(iter);
}
五、安全迭代器
安全迭代器和普通迭代器类似,也是通过 dictNext函数依次遍历字典的hash节点,安全迭代器确保数据的准确性,不是通过限制字典的部分操作实现的,而是通过显示 rehash来进行确保数据的准确性,因此迭代器可以对字典进行增删改查操作。

我们知道,在字典的增删改查中可以使用dictRehashStep函数进行渐进式 rehash操作,那么如何限制呢?看一下 _dictRehashStep 源码。
static void _dictRehashStep(dict *d) {
    if (d->iterators == 0) dictRehash(d,1);
}
gdb可以看到,在迭代操作,第一次迭代对于iterators++,限制了在迭代器操作中,不会进行 rehash操作,字典的数据就不会重复遍历,保证了数据的准确性。
$6 = {type = 0x786a40 <dbDictType>, privdata = 0x0, ht = {{table = 0x7ff8088a5000, size = 32, sizemask = 31, used = 18}, {table = 0x0, size = 0, sizemask = 0,
      used = 0}}, rehashidx = -1, iterators = 1}
keys命令执行如下
1、keysCommand
代码
void keysCommand(client *c) {
    dictIterator *di;
    dictEntry *de;
    sds pattern = c->argv[1]->ptr;//获取命令行输入的第二个参数 *
    int plen = sdslen(pattern), allkeys;
    unsigned long numkeys = 0;
    void *replylen = addDeferredMultiBulkLength(c);
    //迭代器初始化
    di = dictGetSafeIterator(c->db->dict);
    //是否需要遍历所有的 key
    allkeys = (pattern[0] == '*' && pattern[1] == '\0');
    //循环遍历迭代
    while((de = dictNext(di)) != NULL) {
        sds key = dictGetKey(de);//获取迭代器的key
        robj *keyobj;

        //获取所有的key,或者需要遍历匹配的key。
        if (allkeys || stringmatchlen(pattern,plen,key,sdslen(key),0)) {
            keyobj = createStringObject(key,sdslen(key));
            if (expireIfNeeded(c->db,keyobj) == 0) {
                addReplyBulk(c,keyobj);
                numkeys++;
            }
            decrRefCount(keyobj);
        }
    }
    //检查迭代器的指纹是否和字典数据的生成的指纹指纹相当,不相等异常退出。
    dictReleaseIterator(di);
    setDeferredMultiBulkLength(c,replylen,numkeys);
}
2、初始化迭代器
代码
dictIterator *dictGetSafeIterator(dict *d) {
    dictIterator *i = dictGetIterator(d);

    i->safe = 1;
    return i;
}
dictIterator *dictGetIterator(dict *d)
{
dictIterator *iter = zmalloc(sizeof(*iter));
iter->d = d;
iter->table = 0;
iter->index = -1;
iter->safe = 0;
iter->entry = NULL;
iter->nextEntry = NULL;
return iter;
}1、通过 keysCommand 进入迭代器初始化。
2、dictGetSafeIterator表示为安全迭代,把 safe 赋值为1。
3、进入 dictGetIterator 初始化各个成员变量。
gdb 看到初始化完成的结构。
(gdb) p *di
$2 = {d = 0x7ff810c0b360, index = -1, table = 0, safe = 1, entry = 0x0, nextEntry = 0x0, fingerprint = 6715654033350638210}
(gdb) p *di.d
$3 = {type = 0x786a40 <dbDictType>, privdata = 0x0, ht = {{table = 0x7ff8088c4000, size = 16, sizemask = 15, used = 15}, {table = 0x0, size = 0, sizemask = 0,
      used = 0}}, rehashidx = -1, iterators = 0}
3、循环迭代 调用 dictNext函数,执行过程如下
1、如果遍历的 entry 为null,获取 ht[0] 中的 dict数据。
2、如果迭代器中的 index 没有遍历过,并且是安全迭代,dict中的 iterators 数据+1。
3、把获取 的 dictentry 赋值给 entry。
4、否则 entry 存在,赋值给下个nextEntry数据,以便下次遍历。
5、返回 获取的 entry。
4、dictReleaseIterator,如果是安全迭代器,把 iterators --
gdb可以看到 iterators 值 为 0,确保了迭代器后能进行rehash操作。
601                 iter->d->iterators--;
(gdb) n
606     }
(gdb) p *iter.d
$4 = {type = 0x786a40 <dbDictType>, privdata = 0x0, ht = {{table = 0x7ff8088a5000, size = 32, sizemask = 31, used = 18}, {table = 0x0, size = 0, sizemask = 0,
      used = 0}}, rehashidx = -1, iterators = 0}
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论