浏览官网带你搭建资源管家--yarn
文章目录
关于集群的搭建,其实就是说明书的使用问题,会用说明书,很简单,不会用说明书,只能去参考别人的智慧,针对这个情况,对于yarn的搭建,我就把官方文档的相关文档拿出来进行搭建
1、打开官方网址
hadoop.apache.org
2、选择属于自己的hadoop版本
能看懂的直接看英文,看不懂的也可以借助浏览器的翻译功能,就会有下面的这样一个页面
根据官方文档,我们知道,hadoop的设置分为单节点以及集群设置,一步步的来
首先是单节点的设置
1、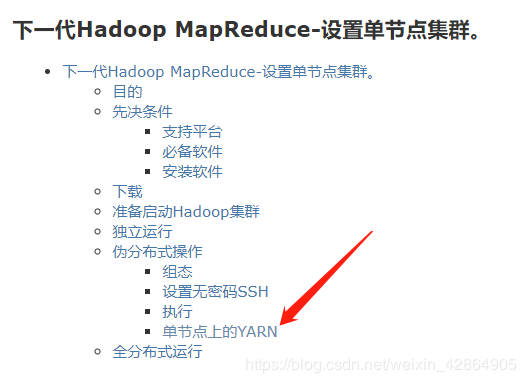
单节点上的yarn配置,点击链接,我们会看到
它提示说:
您可以通过设置一些参数并另外运行ResourceManager守护程序和NodeManager守护程序,以伪分布式模式在YARN上运行MapReduce作业。
那找到如何配置的位置了,接下来就是配置相应的文件了,单节点的yarn的配置是非常简单的,在hadoop的/etc/hadoop目录下,找到对应的mapred-site.xml 和yarn-site.xml这两个文件,然后将官网的配置信息进行拷贝即可
配置etc / hadoop / mapred-site.xml

<configuration>
    <property>
        <name> mapreduce.framework.name </ name>
        <value> yarn </ value>
    </ property>
</ configuration>

配置etc / hadoop / yarn-site.xml:

<configuration>
    <property>
        <name> yarn.nodemanager.aux-services </ name>
        <value> mapreduce_shuffle </ value>
    </ property>
</ configuration>
接下来启动yarn
使用start-yarn.sh启动yarn
使用jps进行查看,会发现,会有resourcemanager以及nodemanager两个进程
接下来是集群yarn的搭建
https://hadoop.apache.org/doc...
链接奉上,自己研究一下吧
注意:
要注意的一点,yarn和hdfs是两个不同的部分,相互之间不影响
可以单独启动yarn而不启动hdfs,但是如果mapreduce等处理进程需要使用到hdfs中的数据,必须启动hdfs
hdfs和yarn一起启动可以使用start-all.sh提交mapreduce任务
hadoop jar jar包名 类名全路径既然我说hdfs和yarn是两个不同的框架,相互之间互不影响,那hdfs有web端的管理页面,yarn是不是也有啊,对的,没有问题,在官网中也对他有相应的解释
ResourceManager- http:// localhost:8088 /
NameNode-http://localhost:50070/
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论