Eureka服务注册与发现探究
文章目录
一、为什么使用服务注册发现
拟定一个场景,假设我们已经有一个服务生产者为用户微服务,这个服务提供了可以通过Id获得用户的RESTful方法:
@GetMapping("/{id}")
public User findUserById(@PathVariable Long id){
     User user = this.userMapper.findById(id);
     return user;
}
另外我们再提供一个服务消费者为 电影微服务, 使用RestTemplate 调用服务生产者的API:
@GetMapping("/user/{id}")
public User findUserById(@PathVariable Long id){
     return this.restTemplate.getForObject("http://localhost:8000/" + id, User.class);
}
通过这样简单的编码, 就可以实现服务之间的简单调用了,其中服务消费中使用的ip+端口, 我们还可以写到application.yml中,这样就完美的实现了服务的调用。
但是,这样真的就完美了吗?以上的硬编码有存在哪些问题呢?
(1)适应场景有限:
如果服务的提供者ip端口发生变化, 那么我们的服务消费者就必须同时修改代码或者配置,并重新发布。
(2)无法动态伸缩:
在生产环境中,每个微服务一般都会部署多个实例,从而实现容灾和负载均衡。动态增减节点, 而硬编码无法适应这种需求。
为了解决以上问题,我们需要使用服务注册与发现。
二、服务发现简介
服务发现架构图如下:
服务提供者、服务消费者、服务发现者之间的关系如下:
- 在各个微服务启动时, 将自己的网络地址等信息注册到服务发现组件,服务发现组件会存储这些信息。
- 服务消费者会从服务发现组件获取服务提供者的网络地址,并使用该地址调用服务提供者的接口。
- 各个微服务与服务发现组件使用一定的机制通信(例如心跳)。若长时间无法与某个实例通信,服务发现组件就会注销这个实例。
- 各个微服务的网络地址发生变化时, 会重新注册到服务发现组件。
三、Eureka简介
Eureka是Netflix开源的服务发现组件,本身是一个基于REST的服务。它包含Server和Client两部分。Spring Cloud将它集成在Netflix中, 从而实现微服务的注册与发现。当然Eureka的使用架构不能脱离服务发现的架构: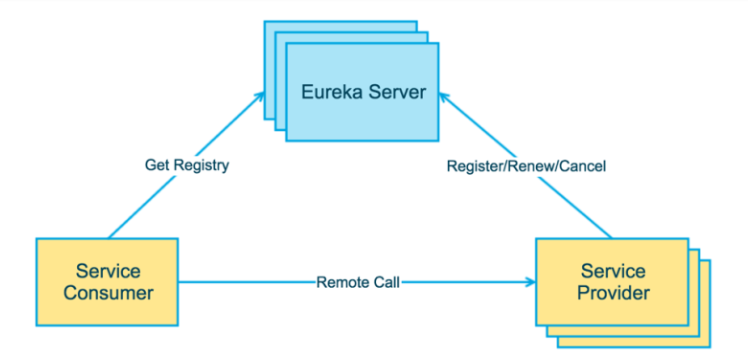
由此图可知,Eureka 分成 Client 和 Server 两部分。
-
Eureka Server 提供服务发现的能力:
- 各个微服务启动时,会向Eureka Server 注册自己的信息。
- 运行过程中,定时运行 evict 任务,剔除没有按时 renew 的服务(包括非正常停止和网络故障的服务)。
- 运行过程中,接收到的 register、renew、cancel 请求,都会同步至其他注册中心节点。
- Eureka Client 是一个java客户端,微服务启动后, 会周期性的(默认30s)地向 Eureka Server 发送心跳以续约自己的“租期”。
- 如果 Eureka Server 在一定时间内没有收到某个微服务实例的心跳, Eureka Server 将会注销该实例(默认90s)。
四、Eureka原理浅析
1、 程序的构成
(1)Eureka 是一个 servlet 应用;
(2)使用了 Jersey 框架实现自身的 RESTful HTTP接口;
(3)Eureka 之间的同步与服务的注册全部通过 HTTP 协议实现;
(4)定时任务(发送心跳、定时清理过期服务、节点同步等)通过 JDK 自带的 Timer 实现;
(5)内存缓存使用Google的guava包实现。
注:开发RESTful WebService意味着支持在多种媒体类型以及抽象 底层的客户端-服务器通信细节,如果没有一个好的工具包可用,这将是一个困难的任务
为了简化使用JAVA开发RESTful WebService及其客户端,一个轻量级的标准被提出:JAX-RS API
Jersey RESTful
WebService框架是一个开源的、产品级别的JAVA框架,支持JAX-RS API并且是一个JAX-RS(JSR 311和 JSR 339)的参考实现。
2、Eureka的注册表
Eureka 是通过内存和缓存来实现服务的注册功能的,在Eureka中 PeerAwareInstanceRegistry 用这样一个接口, 用来保存所有的服务,这个也是所谓的服务注册表。注册的服务列表保存在一个hashmap中。
除此之外Eureka还做了服务的多级缓存来, 如下图所示: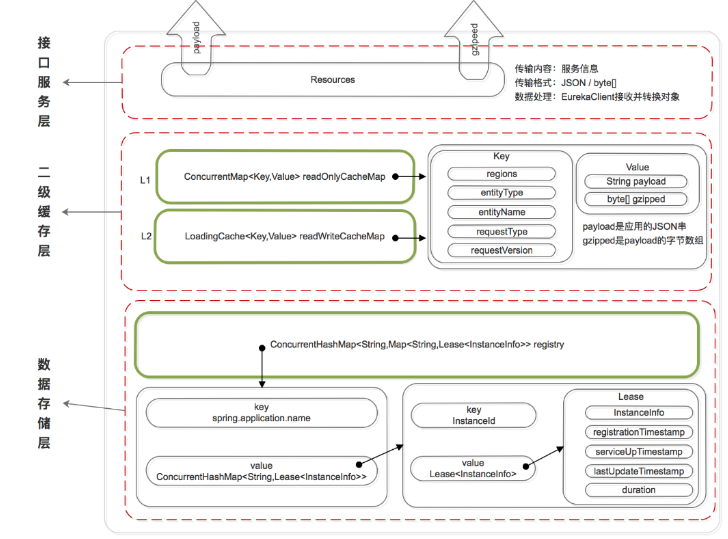
Eureka 的数据存储分了两层:数据存储层和缓存层。
Eureka Client 在拉取服务信息时,先从缓存层获取(相当于 Redis),如果获取不到,先把数据存储层的数据加载到缓存中(相当于 Mysql),再从缓存中获取。值得注意的是,数据存储层的数据结构是服务信息,而缓存中保存的是经过处理加工过的、可以直接传输到 Eureka Client 的数据结构。
Eureka 这样的数据结构设计是把内部的数据存储结构与对外的数据结构隔离开了,就像是我们平时在进行接口设计一样,对外输出的数据结构和数据库中的数据结构往往都是不一样的。
数据存储层
这里为什么说是存储层而不是持久层?因为 rigistry 本质上是一个双层的 ConcurrentHashMap,存储在内存中的。
第一层的 key 是spring.application.name,value 是第二层 ConcurrentHashMap;
第二层 ConcurrentHashMap 的 key 是服务的 InstanceId,value 是 Lease 对象;
Lease 对象包含了服务详情和服务治理相关的属性。
二级缓存层
Eureka 实现了二级缓存来保存即将要对外传输的服务信息,数据结构完全相同。
一级缓存:ConcurrentHashMap<Key,Value> readOnlyCacheMap,本质上是 HashMap,无过期时间,保存服务信息的对外输出数据结构。
二级缓存:Loading<Key,Value> readWriteCacheMap,本质上是 guava 的缓存,包含失效机制,保存服务信息的对外输出数据结构。
既然是缓存,那必然要有更新机制,来保证数据的一致性。下面是缓存的更新机制:
更新机制包含删除和加载两个部分,上图黑色箭头表示删除缓存的动作,绿色表示加载或触发加载的动作。
- 删除二级缓存:
Eureka Client 发送 register、renew 和 cancel 请求并更新 registry 注册表之后,删除二级缓存;
Eureka Server 自身的 Evict Task 剔除服务后,删除二级缓存;
二级缓存本身设置了 guava 的失效机制,隔一段时间后自己自动失效;
- 加载二级缓存:
Eureka Client 发送 getRegistry 请求后,如果二级缓存中没有,就触发 guava 的 load,即从 registry 中获取原始服务信息后进行处理加工,再加载到二级缓存中。
Eureka Server 更新一级缓存的时候,如果二级缓存没有数据,也会触发 guava 的 load。
- 更新一级缓存:
Eureka Server 内置了一个 TimerTask,定时将二级缓存中的数据同步到一级缓存(这个动作包括了删除和加载)。
服务注册机制
服务提供者、服务消费者、以及服务注册中心自己,启动后都会向注册中心注册服务(如果配置了注册)。下图是介绍如何完成服务注册的: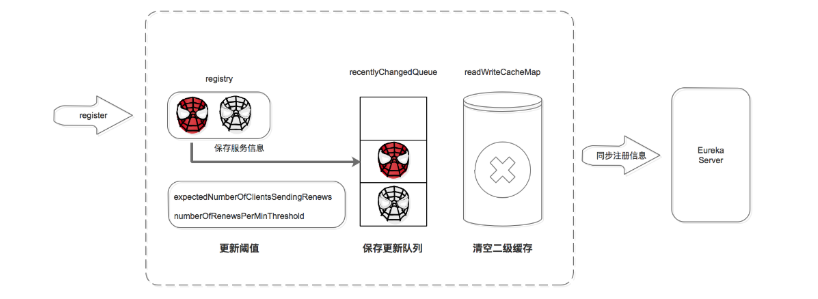
注册中心服务接收到 register 请求后:
- 保存服务信息,将服务信息保存到 registry 中;
- 更新队列,将此事件添加到更新队列中,供 Eureka Client 增量同步服务信息使用。
- 清空二级缓存,即 readWriteCacheMap,用于保证数据的一致性。
- 更新阈值,供剔除服务使用。
- 同步服务信息,将此事件同步至其他的 Eureka Server 节点。
服务续约机制
服务注册后,要定时(默认 30S,可自己配置)向注册中心发送续约请求,告诉注册中心“我还活着”。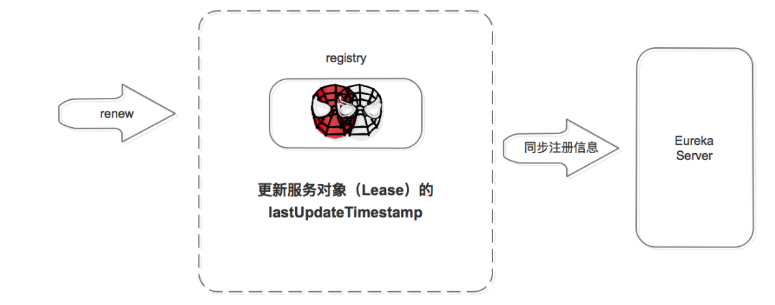
注册中心收到续约请求后:
- 更新服务对象的最近续约时间,即 Lease 对象的 lastUpdateTimestamp;
- 同步服务信息,将此事件同步至其他的 Eureka Server 节点。
- 剔除服务之前会先判断服务是否已经过期,判断服务是否过期的条件之一是续约时间和当前时间的差值是不是大于阈值。
服务注销机制
服务正常停止之前会向注册中心发送注销请求,告诉注册中心“我要下线了”。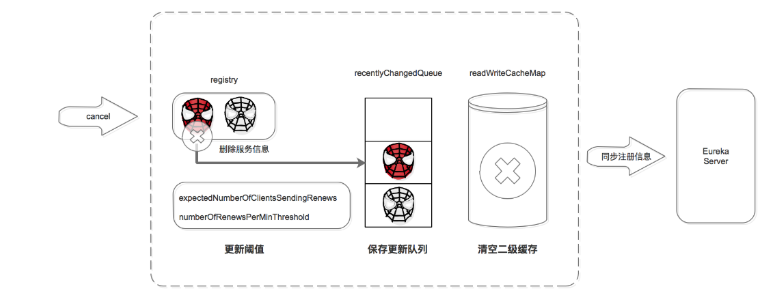
注册中心服务接收到 cancel 请求后:
- 删除服务信息,将服务信息从 registry 中删除;
- 更新队列,将此事件添加到更新队列中,供 Eureka Client 增量同步服务信息使用。
- 清空二级缓存,即 readWriteCacheMap,用于保证数据的一致性。
- 更新阈值,供剔除服务使用。
- 同步服务信息,将此事件同步至其他的 Eureka Server 节点。
- 服务正常停止才会发送 Cancel,如果是非正常停止,则不会发送,此服务由 Eureka Server 主动剔除。
服务剔除机制
Eureka Server 提供了服务剔除的机制,用于剔除没有正常下线的服务。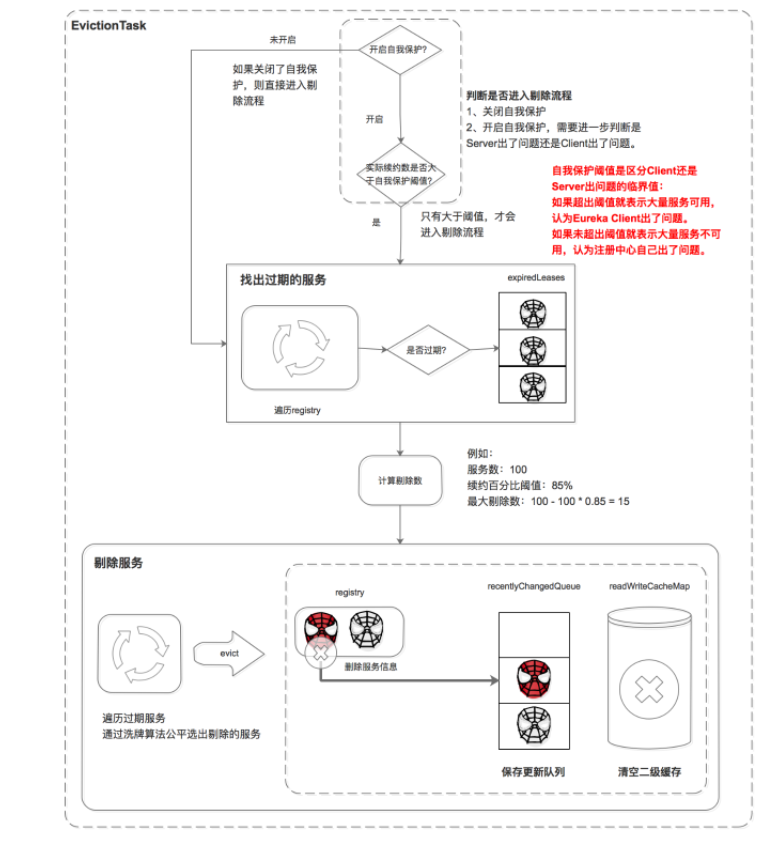
服务的剔除包括三个步骤,
- 判断是否满足服务剔除的条件;
- 找出过期的服务;
- 执行剔除。
服务同步机制
服务同步机制是用来同步 Eureka Server 节点之间服务信息的。它包括 Eureka Server 启动时的同步,和运行过程中的同步。
1) 启动时同步
Eureka Server 启动后,遍历 eurekaClient.getApplications 获取服务信息,并将服务信息注册到自己的 registry 中。
注意这里是两层循环,第一层循环是为了保证已经拉取到服务信息,第二层循环是遍历拉取到的服务信息。
2)运行过程中同步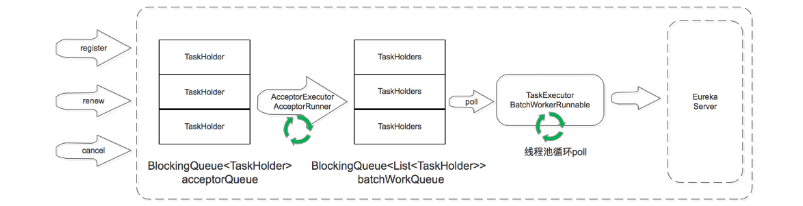
- 当 Eureka Server 节点有 register、renew、cancel 请求进来时,会将这个请求封装成 TaskHolder 放到 acceptorQueue 队列中,然后经过一系列的处理,放到 batchWorkQueue 中。
- TaskExecutor.BatchWorkerRunnable是个线程池,不断的从 batchWorkQueue 队列中 poll 出 TaskHolder,然后向其他 Eureka Server 节点发送同步请求。
这里省略了两个部分:
*一个是在 acceptorQueue 向 batchWorkQueue 转化时,省略了中间的 processingOrder 和 pendingTasks 过程。
另一个是当同步失败时,会将失败的 TaskHolder 保存到 reprocessQueue 中,重试处理。*
注:Eureka Client对已经获取到的注册信息也做了30s缓存。即服务通过eureka客户端第一次查询到可用服务地址后会将结果缓存,下次再调用时就不会真正向Eureka发起HTTP请求了。
五、Eureka安装及部署
1、首先来构建Eureka Server这个服务注册发现的Server端。本文采用Maven来构建项目。
(1)添加以下依赖:
    <dependencyManagement>
        <dependencies>
            <dependency>
                <groupId>org.springframework.cloud</groupId>
                <artifactId>spring-cloud-dependencies</artifactId>
                <version>${spring-cloud.version}</version>
                <type>pom</type>
                <scope>import</scope>
            </dependency>
        </dependencies>
    </dependencyManagement>
    <dependency>
        <groupId>org.springframework.cloud</groupId>
        <artifactId>spring-cloud-starter-netflix-eureka-server</artifactId>
    </dependency>
(2)编写启动类,在启动类上添加@EnableEurekaServer注解, 声明这是一个Eureka Server
@SpringBootApplication
@EnableEurekaServer
public class MicroserviceDiscoveryEurekaApplication {

    public static void main(String[] args) {
        SpringApplication.run(MicroserviceDiscoveryEurekaApplication.class, args);
    }

}
(3)在配置文件application.yml中添加以下内容。
server:
  port: 8761
eureka:
  client:
    register-with-eureka: false # 表示是否将自己注册到Eureka Server
    fetch-registry: false       # 表示是否从别的Eureka Server 获取注册信息,因为是单点部署, 所以设置为false
    service-url:
        # 设置与Eureka Server交互的地址,查询服务和注册服务都要依靠这个地址。默认是当前这个,多个地址间可以用 “,” 分隔
        default-zone: http://localhost:8761/eureka/
本地服务器部署地址:
http://192.168.30.161:8761/
注:如果Eureka A的peer指向了B, B的peer指向了C,那么当服务向A注册时,B中会有该服务的注册信息,但是C中没有。也就是说,如果你希望只要向一台Eureka注册其它所有实例都能得到注册信息,那么就必须把其它所有节点都配置到当前Eureka的peer属性中。
2、其次构建一个服务提供者的微服务。
(1)添加以下依赖:
    <dependencyManagement>
        <dependencies>
            <dependency>
                <groupId>org.springframework.cloud</groupId>
                <artifactId>spring-cloud-dependencies</artifactId>
                <version>${spring-cloud.version}</version>
                <type>pom</type>
                <scope>import</scope>
            </dependency>
        </dependencies>
    </dependencyManagement>
    <dependency>
        <groupId>org.springframework.cloud</groupId>
        <artifactId>spring-cloud-starter-netflix-eureka-client</artifactId>
    </dependency>
    <dependency>
        <groupId>org.springframework.cloud</groupId>
        <artifactId>spring-cloud-starter</artifactId>
    </dependency>
(2)在配置文件中添加以下配置
spring:
  application:
    # 注册到Eureka Server 的应用名称
    name: microservice-provider-user
eureka:
  client:
    service-url:
      # 注册到Eureka 的地址
      default-zone: http://192.168.30.161:8761/eureka/
  instance:
    # 表示将自己的ip注册到 Eureka Server, false 表示将自己所在操作系统的hostname 注册到Eureka Server
    prefer-ip-address: true
如果是SpringCloud Edgware 版本以前,还需要在Application.java 中加上@EnableEurekaClient 注解 或 @EnableDiscoverClient 注解标识开启服务组件客户端。
注: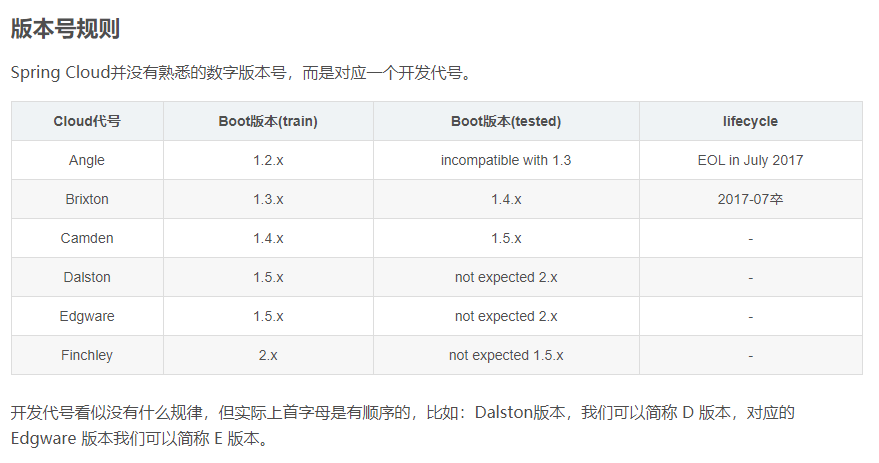
- 这些版本都是以开头字母顺序命名的, 开始的几个版本都是伦敦地铁站的名字, 每个版本的生产版本都是.GA。
- 在单例模式下,eureka.instance.hostname必须是localhost,而且defaultZone不能使用ip,要使用eureka.instance.hostname且走域名解析才可以。 这里我们配置的是localhost,不需要修改hosts文件。
(3)编写简单的接口
@RestController
@RequestMapping(value = "/user")
public class UserController {
    @Autowired
    private UserRepository userRepository;

    @GetMapping("/{id}")
    public User findById(@PathVariable Long id) {
        Optional<User> findOne = userRepository.findById(id);
        return findOne.orElse(null);
    }
}
这样就有了一个可以测试的接口了。
http://192.168.30.161:8888/user/1
3、构建一个服务消费者的微服务
这个服务的消费者只需要和服务提供者的配置相同就可以了。下面我们部署一个microservice-consumer-movie 用来消费提供者提供的接口。
部署地址是:http://192.168.30.161:8889/
@RestController
@RequestMapping(value = "/user")
public class MovieController {
    @Autowired
    private RestTemplate restTemplate;

    @Autowired
    private DiscoveryClient discoveryClient;

    /**
     * Method Description: Created by whx
     * 〈从8888 获取user  信息〉
     *
     * @param id user id
     * @return com.ultrapower.consumermovie.pojo.User
     * @date 11/02/2019 15:08
     */
    @GetMapping("/{id}")
    public User findById(@PathVariable Long id) {
        return this.restTemplate.getForObject("http://192.168.30.161:8888/user/" + id, User.class);
    }

    /**
     * Method Description: Created by whx
     * 〈从服务注册中心 获取 microservice-provider-user 服务提供的信息〉
     *
     * @param id user id
     * @return com.ultrapower.consumermovie.pojo.User
     * @date 11/02/2019 15:09
     */
    @GetMapping("/instance/{id}")
    public User findByUserInstanceId(@PathVariable Long id) {
        List<ServiceInstance> list = discoveryClient.getInstances("microservice-provider-user");
        String url = list.get(0).getUri().toString();
        return this.restTemplate.getForObject(url + "/user/" + id, User.class);
    }


    /**
     * Method Description: Created by whx
     * 〈获取 microservice-provider-user 服务的 instance 信息 〉
     *
     * @return java.util.List<org.springframework.cloud.client.ServiceInstance>
     * @date 11/02/2019 15:10
     */
    @GetMapping("/instance")
    public List<ServiceInstance> findByUserInstance() {
        return discoveryClient.getInstances("microservice-provider-user");
    }
}
以下是该服务的获取结果:
http://192.168.30.161:8889/user/1
http://192.168.30.161:8889/user/instance/1
[{
    "metadata": {
        "management.port": "8888"
    },
    "secure": false,
    "uri": "http://192.168.30.161:8888",
    "instanceId": "localhost:microservice-provider-user:8888",
    "serviceId": "MICROSERVICE-PROVIDER-USER",
    "instanceInfo": {
        "instanceId": "localhost:microservice-provider-user:8888",
        "app": "MICROSERVICE-PROVIDER-USER",
        "appGroupName": null,
        "ipAddr": "192.168.30.161",
        "sid": "na",
        "homePageUrl": "http://192.168.30.161:8888/",
        "statusPageUrl": "http://192.168.30.161:8888/actuator/info",
        "healthCheckUrl": "http://192.168.30.161:8888/actuator/health",
        "secureHealthCheckUrl": null,
        "vipAddress": "microservice-provider-user",
        "secureVipAddress": "microservice-provider-user",
        "countryId": 1,
        "dataCenterInfo": {
            "@class": "com.netflix.appinfo.InstanceInfo$DefaultDataCenterInfo",
            "name": "MyOwn"
        },
        "hostName": "192.168.30.161",
        "status": "UP",
        "overriddenStatus": "UNKNOWN",
        "leaseInfo": {
            "renewalIntervalInSecs": 30,
            "durationInSecs": 90,
            "registrationTimestamp": 1572502252210,
            "lastRenewalTimestamp": 1572502972612,
            "evictionTimestamp": 0,
            "serviceUpTimestamp": 1572502251658
        },
        "isCoordinatingDiscoveryServer": false,
        "metadata": {
            "management.port": "8888"
        },
        "lastUpdatedTimestamp": 1572502252211,
        "lastDirtyTimestamp": 1572502251644,
        "actionType": "ADDED",
        "asgName": null
    },
    "host": "192.168.30.161",
    "port": 8888,
    "scheme": null
}]
六、Eureka与Zookeeper对比
著名的CAP理论指出,一个分布式系统不可能同时满足C(一致性)、A(可用性)和P(分区容错性)。由于分区容错性在是分布式系统中必须要保证的,因此我们只能在A和C之间进行权衡。在此Zookeeper保证的是CP, 而Eureka则是AP。
1. Zookeeper保证CP
当向注册中心查询服务列表时,我们可以容忍注册中心返回的是几分钟以前的注册信息,但不能接受服务直接down掉不可用。也就是说,服务注册功能对可用性的要求要高于一致性。但是zk会出现这样一种情况,当master节点因为网络故障与其他节点失去联系时,剩余节点会重新进行leader选举。问题在于,选举leader的时间太长,30 ~ 120s, 且选举期间整个zk集群都是不可用的,这就导致在选举期间注册服务瘫痪。在云部署的环境下,因网络问题使得zk集群失去master节点是较大概率会发生的事,虽然服务能够最终恢复,但是漫长的选举时间导致的注册长期不可用是不能容忍的。
2. Eureka保证AP
Eureka看明白了这一点,因此在设计时就优先保证可用性。Eureka各个节点都是平等的,几个节点挂掉不会影响正常节点的工作,剩余的节点依然可以提供注册和查询服务。而Eureka的客户端在向某个Eureka注册或时如果发现连接失败,则会自动切换至其它节点,只要有一台Eureka还在,就能保证注册服务可用(保证可用性),只不过查到的信息可能不是最新的(不保证强一致性)。除此之外,Eureka还有一种自我保护机制,如果在15分钟内超过85%的节点都没有正常的心跳,那么Eureka就认为客户端与注册中心出现了网络故障,此时会出现以下几种情况:
- Eureka不再从注册列表中移除因为长时间没收到心跳而应该过期的服务
- Eureka仍然能够接受新服务的注册和查询请求,但是不会被同步到其它节点上(即保证当前节点依然可用)
- 当网络稳定时,当前实例新的注册信息会被同步到其它节点中
因此, Eureka可以很好的应对因网络故障导致部分节点失去联系的情况,而不会像zookeeper那样使整个注册服务瘫痪。
以下对以上两个注册中心进行以下对比: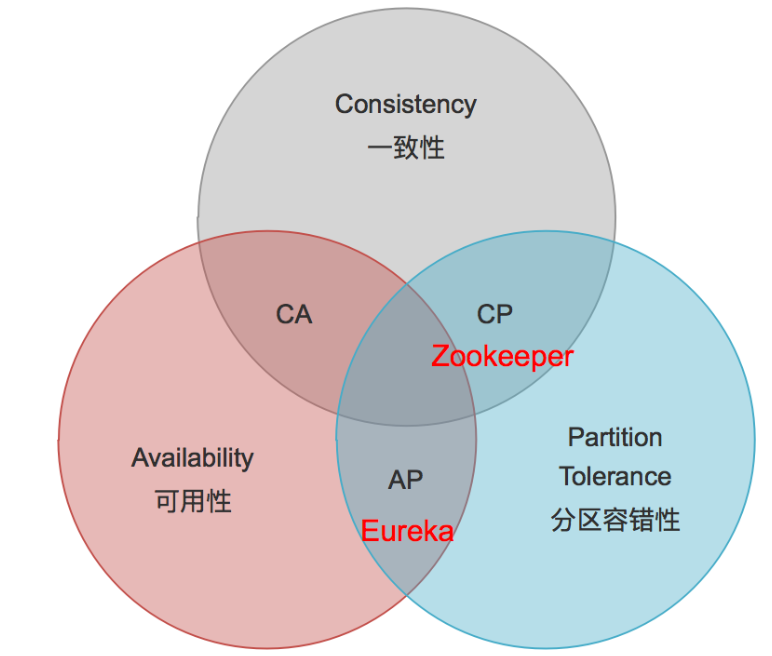
| Zookeeper | Eureka | |
|---|---|---|
| 设计原则 | CP | AP |
| 优点 | 强一致性 | 服务高可用 |
| 缺点 | 网络分区会影响leader选举,超过阈值后集群不可用 | 服务节点之间的数据可能不一致,Client 和 Server 之间的数据可能不一致 |
| 适用场景 | 单机房集群,对数据一致想要求较高 | 云机房集群,跨机房部署,对服务的可用性要求较高 |
————————————————————————————————
参考内容:
https://blog.csdn.net/neosmit...
http://www.uml.org.cn/wfw/201901292.asp
《Spring Cloud 与Docker 微服务架构实战》
七、结语
当然服务注册发现的中间件也有很多,本文只是以Eureka为例浅析,除此,Eureka 中的配置内容还有很多, 比如权限配置、健康检查、元数据配置以及分布式部署等内容需要深入学习。本文只是泛泛而谈,如果错误,还请读者指正。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论