Spark on Hive & Hive on Spark,傻傻分不清楚

文章目录
点击右侧关注,大数据开发领域最强公众号!
点击右侧关注,暴走大数据!
上车前需知
Spark on hive 与 Hive on Spark 的区别
- Spark on hive
Spark通过Spark-SQL使用hive 语句,操作hive,底层运行的还是 spark rdd。
(1)就是通过sparksql,加载hive的配置文件,获取到hive的元数据信息
(2)spark sql获取到hive的元数据信息之后就可以拿到hive的所有表的数据
(3)接下来就可以通过spark sql来操作hive表中的数据
- Hive on Spark
是把hive查询从mapreduce 的mr (Hadoop计算引擎)操作替换为spark rdd(spark 执行引擎) 操作. 相对于spark on hive,这个要实现起来则麻烦很多, 必须重新编译你的spark和导入jar包,不过目前大部分使用的是spark on hive。
上车
概述
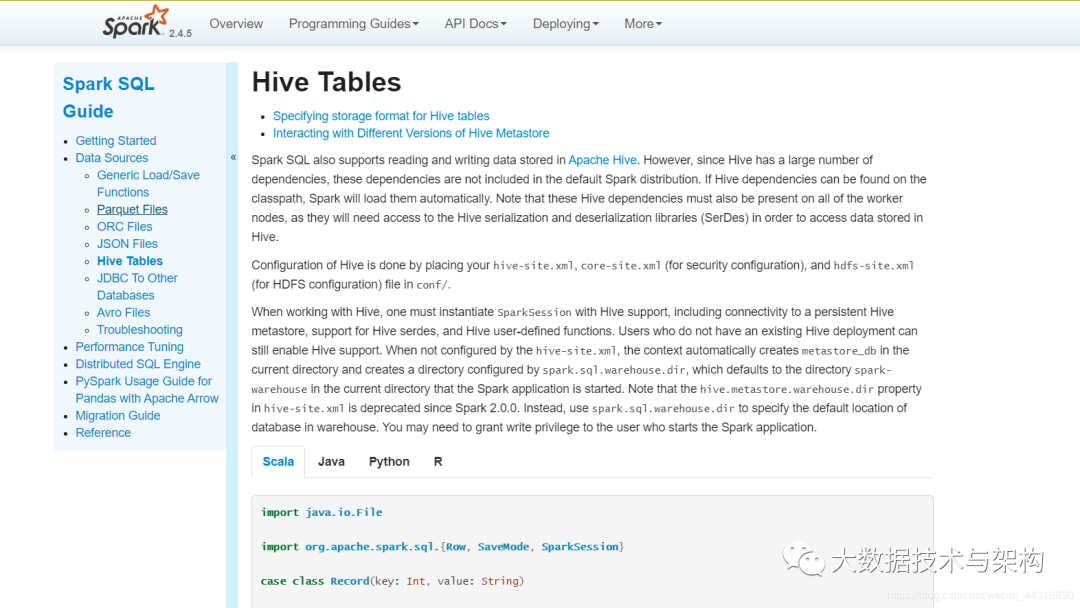
最权威的解释请见Apache Spark官网, http://spark.apache.org/docs/latest/sql-data-sources-hive-tables.html
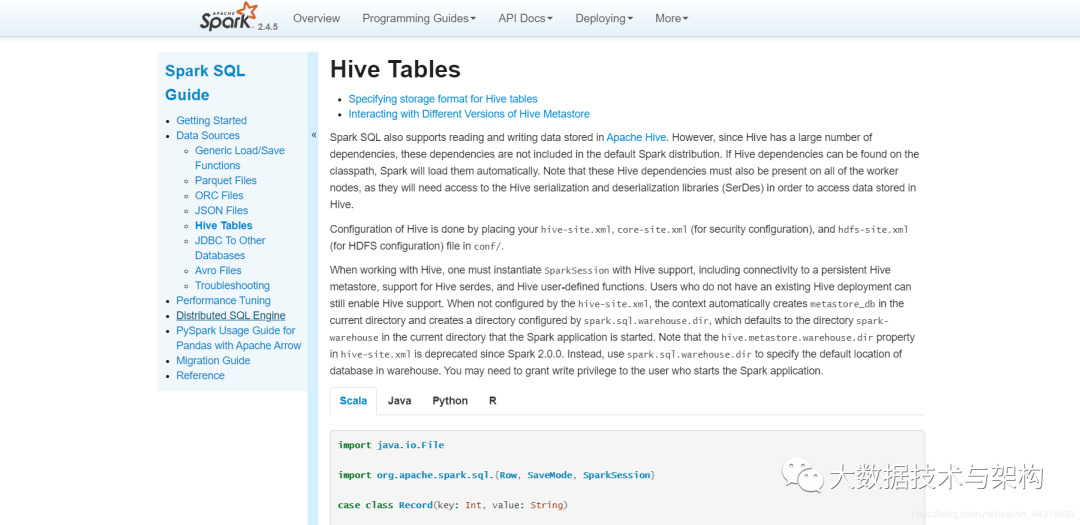
其中最关键的一句已经为大家提取出来了
Configuration of Hive is done by placing your hive-site.xml, core-site.xml (for security configuration), and hdfs-site.xml (for HDFS configuration) file in conf/.
到底是什么意思呢,这里先卖个关子,看到后面大伙就懂了
Hive查询流程及原理
执行HQL时,先到MySQL元数据库中查找描述信息,然后解析HQL并根据描述信息生成MR任务
Hive将SQL转成MapReduce执行速度慢
使用SparkSQL整合Hive其实就是让SparkSQL去加载Hive 的元数据库,然后通过SparkSQL执行引擎去操作Hive表内的数据
首先需要开启Hive的元数据库服务,让SparkSQL能够加载元数据。
发车
一、Hive开启MetaStore服务
<1>修改 hive/conf/hive-site.xml 新增如下配置
<?xml version="1.0"?>
<2>后台启动 Hive MetaStore服务
nohup /export/servers/hive/bin/hive --service metastore 2>&1 >> /var/log.log &
二、SparkSQL整合Hive MetaStore
Spark 有一个内置的 MateStore,使用 Derby 嵌入式数据库保存数据,但是这种方式不适合生产环境,因为这种模式同一时间只能有一个 SparkSession 使用,所以生产环境更推荐使用 Hive 的 MetaStore。
SparkSQL 整合 Hive 的 MetaStore 主要思路就是要通过配置能够访问它, 并且能够使用 HDFS 保存 WareHouse,所以可以直接拷贝 Hadoop 和 Hive 的配置文件到 Spark 的配置目录
hive-site.xml 元数据仓库的位置等信息core-site.xml 安全相关的配置hdfs-site.xml HDFS 相关的配置
我们进入到shell窗口,执行以下命令
将hive目录下的hive-site.xml拷贝至spark安装目录下
cp /export/servers/hive-1.1.0-cdh5.14.0/conf/hive-site.xml /export/servers/spark/conf
将hadoop安装目录下的core-site.xml和 hdfs-site.xml拷贝至spark安装目录下
cp /export/servers/hadoop-2.6.0-cdh5.14.0/etc/hadoop/core-site.xml /export/servers/spark/conf

cp /export/servers/hadoop-2.6.0-cdh5.14.0/etc/hadoop/hdfs-site.xml /export/servers/spark/conf
提示:使用IDEA本地测试直接把以上配置文件放在resources目录即可
飙车
先完成如下所示的代码,使用SparkSQL完成创建一个表,并将本地文件中的数据导入到表格中的操作
使用SparkSQL操作Hive表
import org.apache.spark.sql.SparkSession
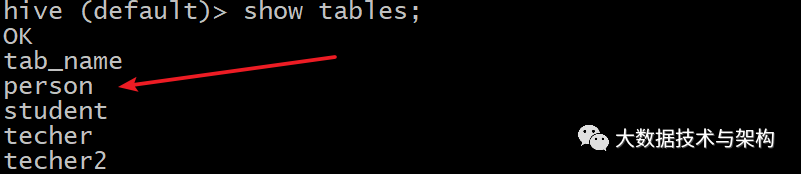
在运行程序之前,先让我们进入到hive的shell窗口,查看一下当前默认数据库default有哪些表
hive (default)> show tables;
然后右键运行,当IDEA控制台打印以下结果,说明我们的程序运行成功了。
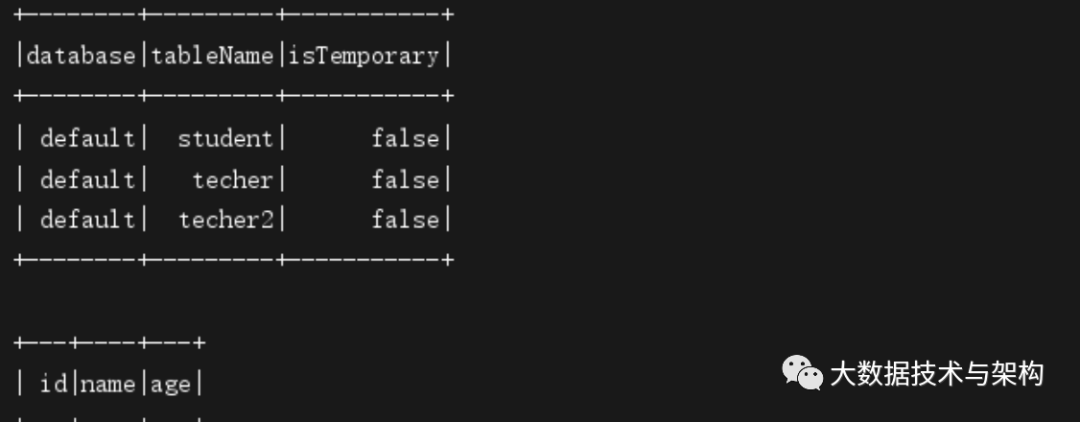
再次进入到hive的shell窗口,查看当前表,此时已经发现了我们刚刚用SparkSQL所创建的表
欢迎点赞+收藏+转发朋友圈素质三连
文章不错?点个【在看】吧!** 👇**
本文分享自微信公众号 - 大数据技术与架构(import_bigdata)。
如有侵权,请联系 support@oschina.cn 删除。
本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论