Data-爬虫-02 第一个网络爬虫
文章目录
Data-爬虫-02 第一个网络爬虫
We're here to put a dent in the universe. Otherwise why else even be here. --Steve Jobs
- 本篇内容主要来自Python 网络爬虫从入门到实践一书的第2章,和其网站给出的代码。
1. 环境配置
- 关于python环境、anaconda使用等内容请参考前言-02 环境与配置部分,本次实验所需要安装的库是requests和bs4。
- requests库:一个方便简单的Python HTTP库,提供了http所有的请求方法,其优势、特点可以看起官方文档。
- bs4库:全名BeautifulSoup,编写爬虫的常用库之一,主要用来解析html标签。
-
安装
# 进入终端
$conda install -n data_env_37 requests #在环境中配置requests库和其依赖
$conda install -n data_env_37 beautifulsoup4 #在环境中配置bs4库和其依赖
$jupyter-notebook #打开jupyter,新建一个notebook
2. 第一个网络爬虫
- 爬取网站为作者个人维护的网页,感谢作者,如若侵权,还请告知。
网页分析
- 在爬去之前,我们有必要对要进行爬取的网页做一定的分析,这里我们以Safari浏览器为例。
- 首先,我们需要打开浏览器的开发者模式,点击
safari浏览器-偏好设置-高级,勾选最下方在菜单栏中显示“开发”菜单,然后,我们可以看到在顶部栏出现了开发选项。 -
然后进入网页,点击
开发-显示网页检查器,出现如下图内容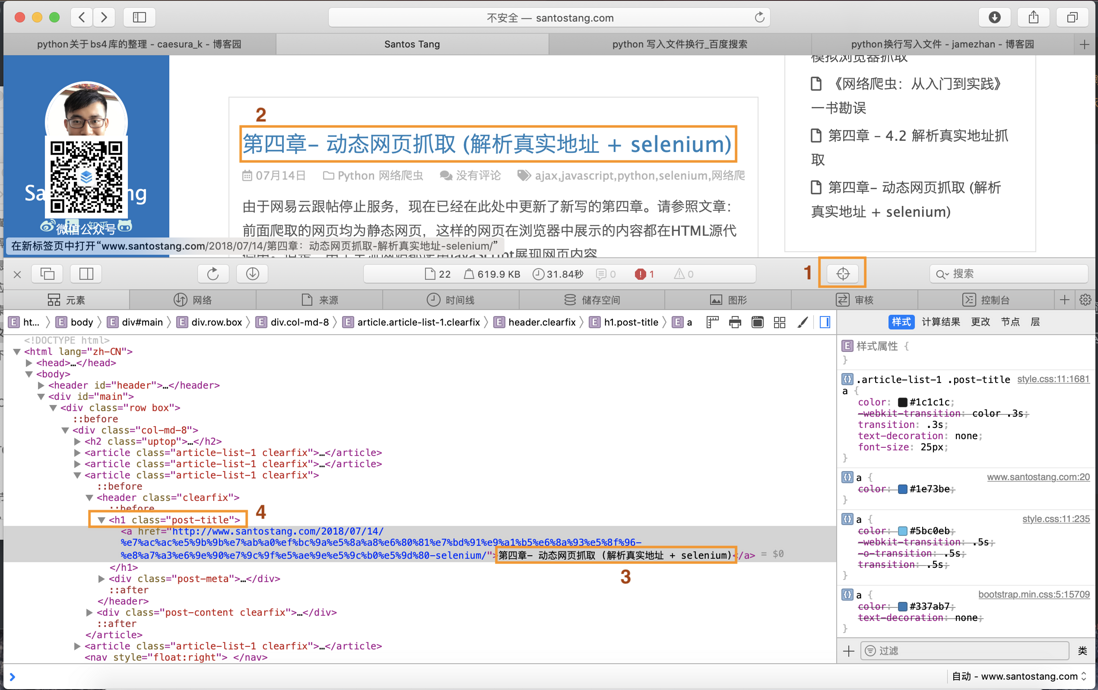
- 首先点击1处,再选择想要爬取的内容,如2处标题;
- 点击后,会出现代码中该标题位置,如3处,可知其标签和类信息,如4处;
- 这些信息会用在步骤二的解析网页、提取数据之中。
步骤一:获取网页
import requests
from bs4 import BeautifulSoup

link = "http://www.santostang.com/" #link为目标网页地址
# 定义请求头的浏览器代理,伪装成浏览器
headers = {'User-Agent' : 'Mozilla/5.0 (Windows; U; Windows NT 6.1; en-US; rv:1.9.1.6) Gecko/20091201 Firefox/3.5.6'}

r = requests.get(link, headers= headers) #请求网页
print (r.text)  # r.text是获取的网页内容代码
步骤二:提取数据
soup = BeautifulSoup(r.text, "html.parser")  #解析页面代码

#找到全部文章标题,定位到class是"post-title"的h1元素,然后逐一提取a,提取里面的字符串,strip()去除左右空格
titles = soup.find_all("h1", class_="post-title")
titlelist = []
for title in titles:
    titlelist.append(title.text.strip())
print(titlelist)
步骤三:存储数据
# 打开一个空白的txt,然后使用f.write写入获得的标题名称
with open('title_test.txt', "a+") as f:
    for title in titlelist:
        f.write(title+'\n')
原文爬取了单个标题,这里自己则捕获页面中全部标题,大家可以尝试爬取网页中其他信息。再次感谢作者的贡献。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论