Data-方法-04 贝叶斯学习
文章目录
Data-方法-04 贝叶斯学习
When you have eliminated the impossible, whatever remains, however improbable, must be the truth. --Sherlock·Holmes, 'The sign of the four'
- Data系列:目录 | 配置 | 代码仓库 | 对应实战
- 对应《数据挖掘导论》第5章、《机器学习》第7章、《统计学习方法(第2版)》第4章。
- 贝叶斯学习是指利用参数的先验分布、由样本信息求得的后验信息,求出总体分布的方法。这里我们主要介绍的是有关贝叶斯分类器的知识。
1. 贝叶斯定理、贝叶斯决策论、参数估计
【贝叶斯定理】
- 贝叶斯定理(Bayes theorem),也叫贝叶斯推理,是一种把类的先验知识和从数据中收集的新证据相结合的统计原理。
-
贝叶斯公式:${\rm P}(Y|X)=\frac{{\rm P}(X\ |\ Y){\rm P}(Y)}{{\rm P}(X)}$
- 联合概率 ${\rm P}(X=x,Y=y)$:表示$X$取$x$且$Y$取$y$的概率;
- 条件概率 ${\rm P}(Y=y\ |\ X=x)$:表示在$X$取$x$情况下,$Y$取$y$的概率;
- 有,${\rm P}(X,Y)={\rm P}(Y\ |\ X)\times{\rm P}(X)={\rm P}(X\ |\ Y)\times{\rm P}(Y)$
【贝叶斯决策论】
- 贝叶斯决策论(Bayesian decision theory),是概率论框架下实施决策的基本方法。
- 对分类任务而言,在所有相关概率都已知的理想情况下,贝叶斯决策论考虑如何基于这些概率和误判损失来选择最优的类别标记。
-
假设:
- $\mathcal{Y}=\{c_1,c_2,...,c_N\}$:有$N$种可能的类别标记
- $\lambda_{ij}$:将一个真实标记为$c_j$的样本误分类为$c_i$所产生的损失
-
有:
-
期望损失(expected loss):${\rm R}(c_i\ |\ x)=\sum^N_{j=1}\lambda_{ij}{\rm P}(c_j\ |\ x)$
- 将样本$x$分类为$c_i$所产生的期望损失;
- 即在样本$x$上的条件风险(conditional disk);
- 目标是寻找一个判定标准 $h:\mathcal{X}\rightarrow\mathcal{Y}$ 以最小化总体风险 ${\rm R}(h)={\rm E}_x[{\rm R}(h(x)\ |\ x)]$
- 对每个样本$x$,若$h$能最小化条件风险${\rm R}(c_i\ |\ x)$,则总体风险也最小化
-
-
贝叶斯判定准则(Bayes decision rule):为最小化总体风险,只需在每个样本上选择能使条件风险 ${\rm R}(c\ |\ x)$最小的类别标记,即 $h^*(x)={\arg\min}_{c\in\mathcal{Y}}R(c\ |\ x)$
- $h^*$:贝叶斯最优分类器(Bayes optimal classifer)
- ${\rm R}(h^*)$:贝叶斯风险(Bayes risk)
- $1-{\rm R}(h*)$:分类器所能达到的最好性能,即通过机器学习能产生的模型精度的理论上限
-
具体而言,若目标是最小化分类错误
- 误判损失$\lambda_{ij}$:$\begin{equation}\lambda_{ij}=\left\{\begin{aligned}&0,&{\rm if}\ i=j\\&1,&{\rm otherwise}\end{aligned}\right.\end{equation}$
- 条件风险:${\rm R}(c\ |\ x)=1-{\rm P}(c\ |\ x)$
-
贝叶斯最优分类器:$h^*(x)=\arg\max_{c\in\mathcal{Y}}{\rm P}(c\ |\ x)$
- 即,对每个样本$x$,选择能使后验概率${\rm P}(c\ |\ x)$最大的类别标记
-
然而,在现实任务中,后验概率通常难以直接获得,所以机器学习所要实现的就是基于有限的训练样本集尽可能准确地估计出后验概率。主要有两种策略:
-
判别式模型(discriminative models)
- 给定$x$,直接建模${\rm P}(c\ |\ x)$来预测$c$
- 如决策树、BP神经网络、支持向量机等
-
生成式模型(generative models)
- 给定$x$,先对联合概率分布${\rm P}(x,c)$建模,然后再由此得到${\rm P}(c\ |\ x)$
- 如这里的贝叶斯分类器
-
-
生成式模型
- 考虑:${\rm P}(c\ |\ x)=\frac{{\rm P}(c){\rm P}(x\ |\ c)}{{\rm P}(x)}$
-
利用贝叶斯定理:${\rm P}(c\ |\ x)=\frac{{\rm P}(c){\rm P}(x\ |\ c)}{{\rm P}(x)}$
- ${\rm P}(c)$:类先验(prior)概率,表达了样本空间中各类样本所占的比例,根据大数定律,当训练集包含充足的独立同分布样本时,${\rm P}(c)$可通过各类样本出现的频率来估计
- ${\rm P}(x\ |\ c)$:样本$c$相对于类标记$c$的类条件概率,或称之为似然(likelihood)
- ${\rm P}(x)$:用于归一化的证据(evidence)因子
- 对给定样本$x$,证据因子${\rm P}(x)$与类标记无关,因此估计${\rm P}(c\ |\ x)$的问题转化为如何基于训练数据$D$来估计先验${\rm P}(c)$和似然${\rm P}(x\ |\ c)$
【参数估计】
- 由于在实际问题中,可能只有有限的样本数据,因而先验概率${\rm P}(c)$和条件概率${\rm P}(x\ |\ c)$都是未知的,因此首先需要对此进行估计,再套用贝叶斯分类器。
-
估计概率的一种常用策略是先假定其具有某种确定的概率分布形式,再基于训练样本对概率分布的参数进行估计。所以概率模型的训练过程就是参数估计(parameter estimation)过程,对此,统计学界有两种学派,
- 频率主义学派(Frequentist):认为参数虽然未知,但却是客观存在的固定值,因此,可通过优化似然函数等准则来确定参数值,如极大似然估计、矩估计;
-
贝叶斯学派(Bayesian):认为参数是未观察到的随机变量,其本身也有分布,因此,可假设参数服从一个先验分布,然后基于观测到的数据来计算参数的后验分布。(
怎么开始套娃了)
- 详细介绍请参考基础篇-参数估计
2. 朴素贝叶斯分类器
【基本概念】
- 贝叶斯定理:${\rm P}(c\ |\ x)=\frac{{\rm P}(c){\rm P}(x\ |\ c)}{{\rm P}(x)}$
- 估计后验概率${\rm P}(c\ |\ x)$的主要困难在于:很难从有限的训练样本中直接估计类条件概率${\rm P}(x\ |\ c)$。
-
朴素贝叶斯分类器(naïve Bayes classifer)采用了属性条件独立性假设(attribute conditional independence assumption):对已知类别,假设所有属性相互独立
- 可改为:${\rm P}(c\ |\ x)=\frac{{\rm P}(c){\rm P}(x\ |\ c)}{{\rm P}(x)}=\frac{{\rm P}(c)}{{\rm P}(x)}\Pi^d_{i=1}{\rm P}(x_i|c)$
- 对所有类别${\rm P}(x)$相同,朴素贝叶斯可表示为:$h_{nb}(x)={\arg\max}_{c\in\mathcal{Y}}{\rm P}(c)\Pi^d_{i=1}{\rm P(x_i|c)}$
-
朴素贝叶斯分类器的训练过程就是基于训练集来估计类先验概率$\rm P(c)$和为每个属性估计条件概率${\rm P}(x_i|c)$,具体估计方法可以使用极大似然估计、贝叶斯估计等,具体见下一小节
- 类先验概率:${\rm P}(c)=\frac{|D_c|}{|D|}$
-
条件概率:
- 离散属性:${\rm P}(x_i|c)=\frac{|D_{c,x_i}|}{|D_c|}$
-
连续属性:
- 可以把连续的属性离散化,然后再用相应的离散区间替换连续属性值;
- 假设连续变量服从某种概率分布,考虑概率密度函数,然后用训练数据估计分布的参数。高斯分布常被用来表示连续属性的类条件概率分布,假定${\rm P}(x_i|c)~\mathcal{N}(\mu_{c,i},\sigma^2_{c,i})$,$\mu_{c,i}$、$\sigma^2_{c,i}$表示第$c$类样本在第$i$个属性上取值的均值和方差,有:${\rm P}(x_i|c)=\frac{1}{\sqrt{2\pi}\sigma_{c,i}}\exp(-\frac{(x_i-\mu_{c,i})^2}{2\sigma^2_{c,i}})$
- 有了先验概率${\rm P}(x)$和条件概率${\rm P(x_i|c)}$后,就可以计算后验概率的模拟${\rm P}(c){\rm P}(x|c)={\rm P}(c)\Pi^d_{i=1}{\rm P(x_i|c)}$
- 然后根据朴素贝叶斯分类器确定类 $h_{nb}(x)={\arg\max}_{c\in\mathcal{Y}}{\rm P}(c)\Pi^d_{i=1}{\rm P(x_i|c)}$
【概率的估计】
- 先验概率和条件概率估计的数学基础为参数估计,常用的有极大似然估计和贝叶斯估计。
-
极大似然估计
- 类先验概率:${\rm P}(c)=\frac{|D_c|}{|D|}$
-
条件概率:
- 离散属性:${\rm P}(x_i|c)=\frac{|D_{c,x_i}|}{|D_c|}$
-
连续属性:
- 可以把连续的属性离散化,然后再用相应的离散区间替换连续属性值;
- 假设连续变量服从某种概率分布,考虑概率密度函数,然后用训练数据估计分布的参数。高斯分布常被用来表示连续属性的类条件概率分布,假定${\rm P}(x_i|c)~\mathcal{N}(\mu_{c,i},\sigma^2_{c,i})$,$\mu_{c,i}$、$\sigma^2_{c,i}$表示第$c$类样本在第$i$个属性上取值的均值和方差,有:${\rm P}(x_i|c)=\frac{1}{\sqrt{2\pi}\sigma_{c,i}}\exp(-\frac{(x_i-\mu_{c,i})^2}{2\sigma^2_{c,i}})$
- 不足:当某个属性值在训练集中没有与某个类同时出现过,则可能会导致出现概率值为0的情况,尤其当训练样例很少且属性数目很大时。
-
贝叶斯估计
-
条件概率:${\rm P}_\lambda(X^{(j)}=a_{jl}|Y=c_k)=\frac{\sum^N_{i=1}I(x^{(j)}_i=a_{jl},y_i=c_k)+\lambda}{\sum^N_{i=1}I(y_i=c_k)+S_j\lambda}$
- 其中$\lambda\ge0$,等价于在随机变量的各个取值的频数上赋予一个正数$\lambda>0$。
- 当$\lambda=0$时,就是极大似然估计 ${\rm P}(x_i|c)=\frac{|D_{c,x_i}|}{|D_c|}$;
- 当$\lambda=1$时,是拉普拉斯平滑(Laplacian smoothing) ${\rm P}(x_i|c)=\frac{|D_{c,x_i}|+1}{|D_c|+N_i}$,$N_i$表示第$i$个属性的可能取值数
-
先验概率:${\rm P}_\lambda(Y=c_k)=\frac{\sum^N_{i=1}I(y_i=c_k)+\lambda}{N+K\lambda}$
- 当$\lambda=0$时,极大似然估计 ${\rm P}(c)=\frac{|D_c|}{|D|}$
- 当$\lambda=1$时,拉普拉斯平滑 ${\rm P}(c)=\frac{|D_c|+1}{|D|+N}$,$N$表示训练集中可能的类别数
- 拉普拉斯修正避免了因样本不充分而导致概率估值为零的问题,并且在训练集变大的时候,修正过程所引入的先验的影响也会逐渐变得可忽略,使估值渐趋向于实际概率值。
-
【实际使用】
-
在现实中,朴素贝叶斯分类器有多种使用方式,如:
- 若任务对预测速度要求较高,则可将涉及的所有概率估值事先计算好存储起来,预测时只需要“查表”即可进行判别;
- 若任务数据更迭频繁,则可采用“懒惰学习”方式,先不进行训练,待收到预测请求时再根据当前数据集进行概率估值;
- 若任务数据不断增加,则可在现有估值的基础上,仅对新增样本的属性值涉及的概率估值进行技术修正即可实现增量学习。
- 朴素贝叶斯是典型的生成学习方法,由训练数据学习联合概率分布,然后求得后验概率分布,概率估计方法可以是极大似然估计或贝叶斯估计。
-
朴素贝叶斯的基本假设是条件独立性,但是虽然这在现实应用中往往很难成立,但是其在很多情形下都能获得相当好的性能,有以下可能的解释:
- 对分类任务来说,只需要各类别的条件概率排序正确,无需精准概率值即可实现正确分类结果;
- 若属性间依赖对所有类别影响相同,或依赖关系的影响能相互抵消,则属性条件独立性假设在降低计算开销的同时不会对性能产生负面影响。
-
朴素贝叶斯分类器一般具有以下特点:
- 面对孤立的噪声点,朴素贝叶斯分类器是健壮的;
- 面对无关属性,朴素贝叶斯分类器是健壮的;
- 相关属性可能会降低朴素贝叶斯的性能,因为对这些属性,条件独立的假设已不成立。
- 朴素贝叶斯分类器的例子,这里不做给出,可以自行看书本对应章节,或查看对应练习。
3. 半朴素贝叶斯分类器
- 半朴素贝叶斯分类器(semi-naïve Bayes classifeiers):适当考虑一部分属性间的相互依赖信息,既不需进行完全联合概率计算,又不至于忽略了比较强的属性依赖关系。
-
“独依赖估计”(One-Dependent Estimator, ODE)是半朴素贝叶斯分类器常用的一种策略,假设每个属性在类别之外最多仅依赖一个其他属性
- 即${\rm P}(c|x)\propto{\rm P}(c)\Pi^d_{i=1}(x_i|c,pa_i)$
- $pa_i$:属性$x_i$所依赖的属性,称为$x_i$的父属性
-
确定父属性的方法:
- SPODE (Super-Parent ODE) 方法:假设所有属性都依赖于同一个属性,称为“超父”,然后通过交叉验证等模型选择方法来确定超父属性;
- TAN (Tree Augmented naïve Bayes) 方法:在最大权生成树算法的基础上,将属性间依赖关系简约为属性结构;
- AODE (Averaged One-Dependent Estimator):基于集成学习机制、更加强大的独依赖分类器,AODE尝试将每个属性作为超父来构建SPODE,然后将那些具有足够训练数据支撑的SPODE集成起来作为最终结果。
- 详细的内容不做介绍了,这里只做大致了解。
4. 贝叶斯网
【基本概念】
-
贝叶斯信念网络(Bayesuab belief networks, BBN),简称贝叶斯网络,借助有向无环图(Directed Acyclic Graph, DAG)来刻画属性之间的依赖关系,并使用条件概率表(Conditional Probability Table, CPT)来描述属性的联合概率分布。
- 一个贝叶斯网$B$由结构$G$和参数$\Theta$两部分构成,即$B=\langle G,\Theta\rangle$。
- 网络结构图$G$:一个有向无环图,每个结点对应一个属性,若两个属性有直接依赖关系,则它们由一条边连接起来。
- 参数$\Theta$:定量描述这种依赖关系,假设属性$x_i$在$G$中的父结点集为$\pi$,则$\Theta$包含了每个属性的条件概率表$\theta_{x_i|\pi_i}={\rm P}_B(x_i|\pi_i)$
-
网络结构图
-
贝叶斯网中三个变量间的典型依赖关系如下,

- 同父结构:给定父节点$x_1$的值,则$x_3$与$x_4$条件独立
- V型结构/冲撞结构:若给定$x_4$的取值,$x_1$与$x_2$不必独立;若$x_4$的取值完全未知,则$x_1$与$x_2$相互独立
- 顺序结构:给定$x$的值,则$y$与$z$条件独立
- 条件独立:对贝叶斯网络中的一个结点,如果其父母结点已知,则它条件独立于它的所有非后代节点。
-
-
条件独立性
-
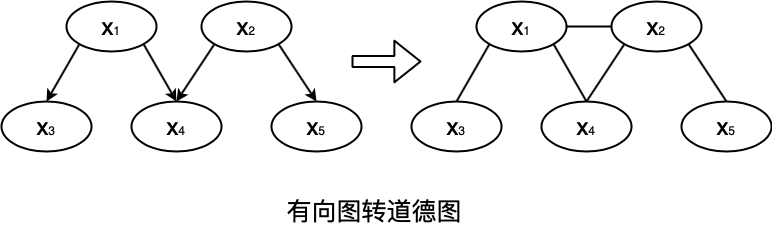
为分析有向图间的条件独立性,可以用有向分离(Dseparation),把有向图转换为无向图:
- 找出有向图中的所有V型结构, 在V型结构的两个父节点之间加上一条无向边;
- 将所有有向边改为无向边。
- 由此产生的无向边称为“道德图”(moral graph),连接父节点的过程称为“道德化“(moralization)
- 道德图能直观、迅速地找出向量间的条件独立性:假定道德图中有变量$x$, $y$和变量集合$z=\{z_i\}$,若$x$和$y$能在图上被$z$分开,则称变量$x$和$y$被$z$有向分离,$x\perp y\ |\ z$成立
- 示例如下,有$x_3\perp x_4\ |\ x_1$, $x_4\perp x_5\ |\ x_2$, $x_3\perp x_2\ |\ x_1$等
-
-
条件概率表
-
有向无环图中每个结点都关联一个概率表:
- 如果结点$x$没有父母节点,则表中只包含先验概率${\rm P}(x)$;
- 如果结点$x$只有一个父母节点$y$,则表中包含条件概率${\rm P}(x|y)$;
- 如果结点$x$由多个父母节点$\{y_1,y_2,...,y_k\}$,则表中包含 条件概率${\rm P}(x|y_1,y_2,...,y_k)$
-
【简单示例】
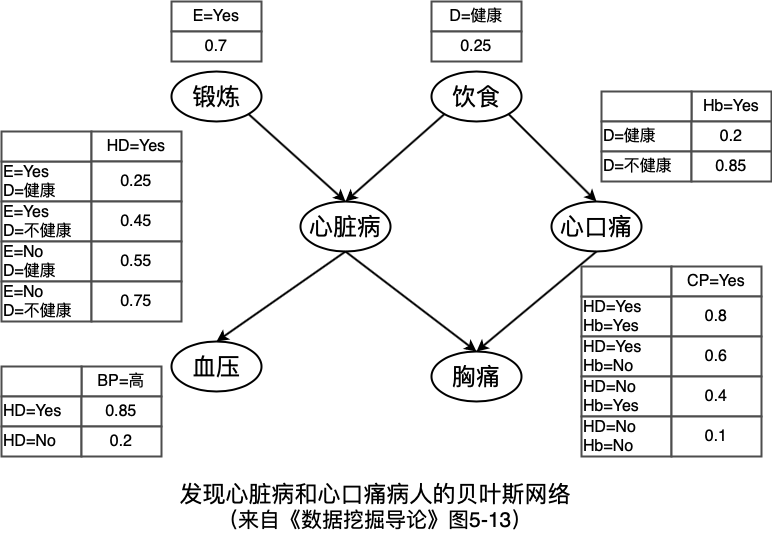
- 以下例子来自于《数据挖掘导论》第5章
-
一些计算示例:
-
不锻炼,健康饮食的人得心脏病的概率:
$$ \begin{aligned}{\rm P}(心脏病={\rm No}|锻炼={\rm No},饮食=健康)&=1-{\rm P}(心脏病={\rm No}|锻炼={\rm Yes},饮食=健康)\\&=1-0.55=0.45\end{aligned} $$
-
没有先验信息的情况下,一个人得心脏病的概率:
$$ \begin{aligned} {\rm P}(HD=Yes) &=\sum_\alpha\sum_\beta{\rm P}(HD=Yes|E=\alpha,D=\beta){\rm P}(E=\alpha,D=\beta)\\ &=\sum_\alpha\sum_\beta{\rm P}(HD=Yes|E=\alpha,D=\beta){\rm P}(E=\alpha){\rm P}(D=\beta)\\ &=0.25\times0.7\times0.25+0.45\times0.7\times0.75+0.55\times0.3\times0.35+0.55\times0.3\times0.75\\ &=0.49 \end{aligned} $$
-
有高血压的情况下,一个人得心脏病的概率:
-
首先需要计算${\rm P}(BP=高)$,
$$ \begin{aligned} {\rm P}(BP=高)&=\sum_\gamma{\rm P}(BP=高|HD=\gamma){\rm P}(HD=\gamma)\\ &=0.85\times0.49+0.2\times0.51=0.5185 \end{aligned} $$
-
然后计算${\rm P}(HD=Yes|BP=高)$
$$ \begin{aligned} {\rm P}(HD=Yes|BP=高)&=\frac{{\rm P}(BP=高|HD=Yes){\rm P}(HD=Yes)}{{\rm P}(BP=高)}\\ &=\frac{0.85\times0.49}{0.5185}=0.8033 \end{aligned} $$
-
-
高血压、饮食健康、经常锻炼的人,得心脏病的概率
$$ \begin{aligned} &{\rm P}(HD=Yes|BP=高,D=健康,E=Yes)\\ =&[\frac{{\rm P}(BP=高|HD=Yes,D=健康,E=Yes)}{{\rm P}(BP=高|D=健康,E=Yes)}]\times{\rm P}(HD=Yes|D=健康,E=Yes)\\ =&\frac{{\rm P}(BP=高|HD=Yes){\rm P}(HD=Yes|D=健康,E=Yes)}{\sum_\gamma{\rm P}(BP=高|HD=\gamma){\rm P}(HD=\gamma|D=健康,E=Yes)}\\ =&\frac{0.85\times0.25}{0.85\times0.25+0.2\times0.75}\\ =&0.5862 \end{aligned} $$
-
【建模与推断】
-
贝叶斯网络的建模包含创建网络结构和估计每一个结点的概率表中的概率值两个部分。
- 网络拓扑结构可以通过对主观的领域专家知识编码获得,另外“评分搜索”是寻找最“恰当”的贝叶斯网的常用方法。
- “评分搜索”,首先定义一个评分函数(score function),以此来评估贝叶斯网与训练数据的契合程度,然后基于这个评分函数来寻找最优的贝叶斯网。
-
贝叶斯网训练好之后,就能通过一些属性变量的观测值来进行预测
- 最理想的状况就如上面的示例那样,根据联合概率分布来精确计算后验概率,但这已被证明是NP难的;
- 现实中,需要借助“近似推断”,通常采用吉布斯采样(Gibbs sampling)来完成,这是一种随机采样方法。
- 对于可能存在的”不完整“的训练样本,即存在未观测的隐变量,则可以采用EM算法来处理。
【BBN的特点】
- BBN提供了一种用图形模型来捕获特定领域的先验知识的方法,网络还可以用来对变量间的因果依赖关系进行编码;
- 构造网络可能费时费力,但一旦网络结构确定,添加新变量就十分容易;
- BBN很适合处理不完整的数据,对有属性遗漏的实例可以通过对该属性的所有可能取值的概率求和或求积分来处理;
- 因为数据和先验知识以概率的方式结合起来了,所以该方法对模型的过拟合问题是非常鲁棒的;
- BBN为不确定学习和推断提供了基本框架,具有强大的表示能力、良好的可解释性;
- 贝叶斯网学习可以分为结构学习和参数学习两部分,其中结构学习是NP难的。
参考资料
- 《数据挖掘导论》第5章
- 《机器学习》第7章
- 《统计学习方法(第2版)》第4章
三本书中关于贝叶斯误差率、EM算法、评分函数等内容,这里没有记录下来,因为内容太多,也相对复杂,这里只对大致概念有个清晰了解。实际遇到时可以再参考相关资料。终于完成了,好多内容啊
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论