Redis (主从同步原理)
文章目录
一、读写分离
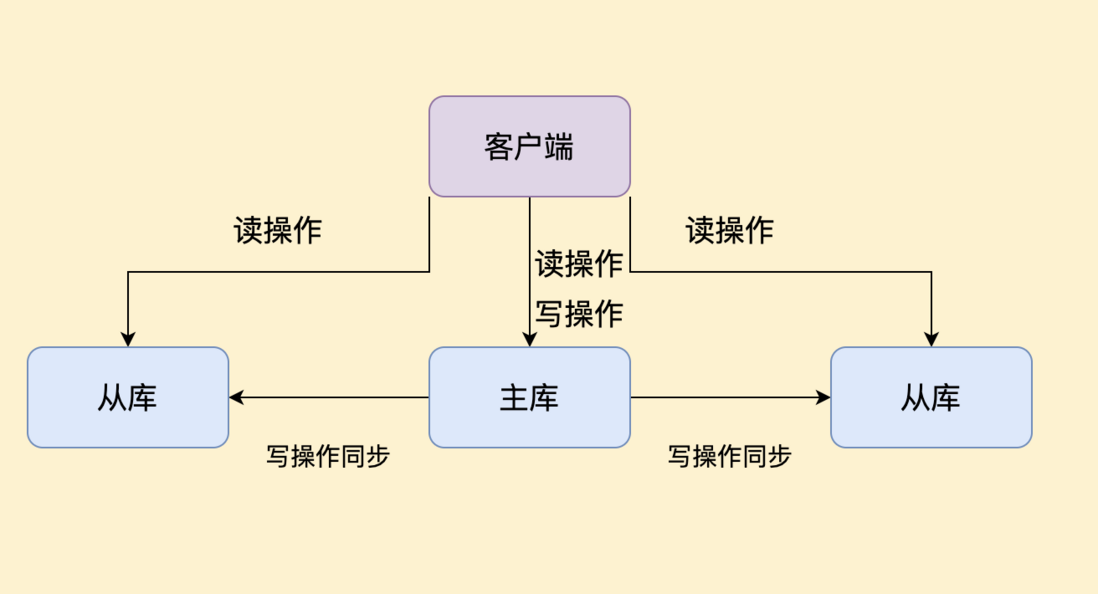
读操作:主库和从库都可以接受。
学操作:主库执行,然后主库同步给从库。
为什么要采用读写分离的操作?
比如修改一个 key 为 k1 的值,这个时候,同时向3个redis服务,那么有可能某一次的操作有可能是 旧的值。并且采用这种模式的话,需要设计同步操作锁等一系列的问题。

所以,如果采用了读写分离的模式,写的数据操作只会在主服务器执行,然后同步给从服务器,这个时候读取的数据就是一致性的。
二、主从库间如何进行第一次同步?

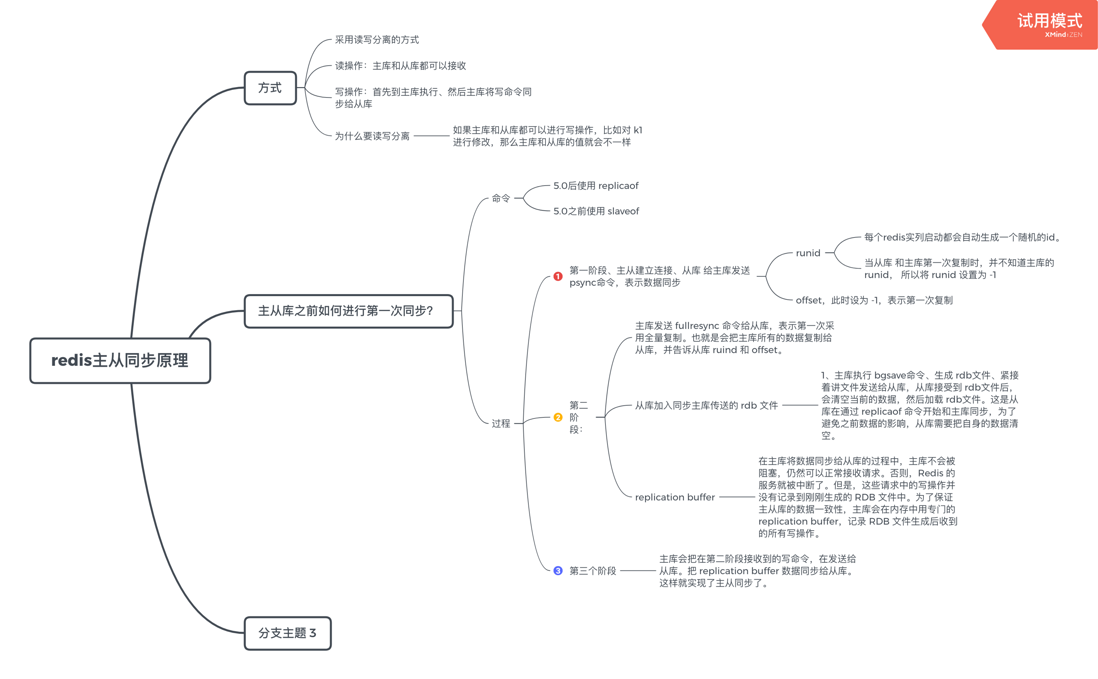
当启动多个redis实列时,我们可以使用 replicaof (5.0 之前使用 slaveof )命令,形成主从关系。
- 第一个阶段:
主从建立连接、从库 给 主库发送 psync命令,表示数据同步。当从库 和主库第一次复制时,并不知道主库的 runid, 所以将 runid 设置为 -1。
参数
 runid : 每个redis实列启动都会自动生成一个随机的id。
 offset: 此时设为 -1,表示第一次复制。
第二阶段:
- 主库发送 fullresync 命令给从库,表示第一次采用全量复制。也就是会把主库所有的数据复制给从库,并告诉从库 ruind 和 offset。
- 从库加载同步主库传送的 rdb 文件,主库执行 bgsave命令、生成 rdb文件、紧接着讲文件发送给从库,从库接受到 rdb文件后,会清空当前的数据,然后加载 rdb文件。这是从库在通过 replicaof 命令开始和主库同步,为了避免之前数据的影响,从库需要把自身的数据清空。
- replication buffer
在主库将数据同步给从库的过程中,主库不会被阻塞,仍然可以正常接收请求。否则,Redis 的服务就被中断了。但是,这些请求中的写操作并没有记录到刚刚生成的 RDB 文件中。为了保证主从库的数据一致性,主库会在内存中用专门的 replication buffer,记录 RDB 文件生成后收到的所有写操作。
第三个阶段:
主库会把在第二阶段接收到的写命令,在发送给从库。把 replication buffer 数据同步给从库。这样就实现了主从同步了。
三、主从级联模式分担全量复制时的主库压力
问题:在主从库之前的第一次进行全量复制中,对于主库来说需要完成两个耗时操作。
- 生成 RDB 文件。
- 传输 RDB 文件。
如果从库数量很多,而且都要和主库进行全量赋值的话,就会导致主库 忙于 fork 子进程生成 rdb文件,进行数据全量同步,fork 这个操作会堵塞主线程处理的请求,从而导致系统的响应变慢,传输rdb文件也会占用主库的带宽。
解决办法:主从从模式。
在刚才介绍的主从库模式中,所有的从库都是和主库连接,所有的全量复制也都是和主库进行的。现在,我们可以通过“主 - 从 - 从”模式将主库生成 RDB 和传输 RDB 的压力,以级联的方式分散到从库上。
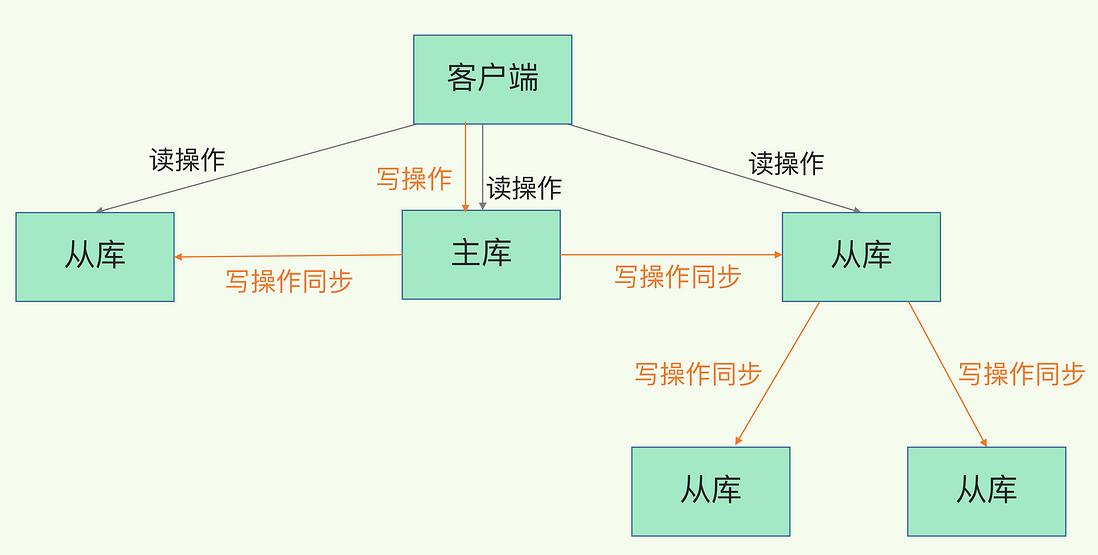
主从完成了全量复制,就会一直保持一个网络连接,主库会通过这个连接将后续的命令同步给主库,这个过程称为 基于长连接的命令传播,可以避免频繁建立连接的开销。
问题:如果连接断开了,主从之前就无法进行传播命令了,从库自然就无法保持新的数据了。
四、主从间网络断开了怎么办?
在redis 2.8 之前,如果主从之前出现了闪断,那么从库和主库之前就会进行一次全量复制,开销会很大。
在 redis 2.8 之后,网络断开了,会使用增量复制的方式同步。
增量复制:增量复制只会把主从期间网络断开的数据同步给从库。
通过 repl_backlog_buffer。
当主从库断连后,主库会把断连期间收到的写操作命令,写入 replication buffer,同时也会把这些操作命令也写入 repl_backlog_buffer 这个缓冲区。
repl_backlog_buffer 是一个环形缓冲区,主库会记录自己写到的位置,从库则会记录自己已经读到的位置。
刚开始的时候,主库和从库的写读位置在一起,这算是它们的起始位置。随着主库不断接收新的写操作,它在缓冲区中的写位置会逐步偏离起始位置,我们通常用偏移量来衡量这个偏移距离的大小,对主库来说,对应的偏移量就是 master_repl_offset。主库接收的新写操作越多,这个值就会越大。同样,从库在复制完写操作命令后,它在缓冲区中的读位置也开始逐步偏移刚才的起始位置,此时,从库已复制的偏移量 slave_repl_offset 也在不断增加。正常情况下,这两个偏移量基本相等。

主从库的连接恢复之后,从库首先会给主库发送 psync 命令,并把自己当前的 slave_repl_offset 发给主库,主库会判断自己的 master_repl_offset 和 slave_repl_offset 之间的差距。在网络断连阶段,主库可能会收到新的写操作命令,所以,一般来说,master_repl_offset 会大于 slave_repl_offset。此时,主库只用把 master_repl_offset 和 slave_repl_offset 之间的命令操作同步给从库就行。就像刚刚示意图的中间部分,主库和从库之间相差了 put d e 和 put d f 两个操作,在增量复制时,主库只需要把它们同步给从库,就行了。
因为 repl_backlog_buffer 是一个环形缓冲区,所以在缓冲区写满后,主库会继续写入,此时,就会覆盖掉之前写入的操作。如果从库的读取速度比较慢,就有可能导致从库还未读取的操作被主库新写的操作覆盖了,这会导致主从库间的数据不一致。
因此,我们要想办法避免这一情况,一般而言,我们可以调整 repl_backlog_size 这个参数。这个参数和所需的缓冲空间大小有关。缓冲空间的计算公式是:缓冲空间大小 = 主库写入命令速度 操作大小 - 主从库间网络传输命令速度 操作大小。在实际应用中,考虑到可能存在一些突发的请求压力,我们通常需要把这个缓冲空间扩大一倍,即 repl_backlog_size = 缓冲空间大小 * 2,这也就是 repl_backlog_size 的最终值。举个例子,如果主库每秒写入 2000 个操作,每个操作的大小为 2KB,网络每秒能传输 1000 个操作,那么,有 1000 个操作需要缓冲起来,这就至少需要 2MB 的缓冲空间。否则,新写的命令就会覆盖掉旧操作了。为了应对可能的突发压力,我们最终把 repl_backlog_size 设为 4MB。
如果在网络断开期间,repl_backlog_size环形缓冲区写满之后,从库是会丢失掉那部分被覆盖掉的数据,还是直接进行全量复制呢?
- 一个从库如果和主库断连时间过长,造成它在主库repl_backlog_buffer的slave_repl_offset位置上的数据已经被覆盖掉了,此时从库和主库间将进行全量复制。
- 每个从库会记录自己的slave_repl_offset,每个从库的复制进度也不一定相同。在和主库重连进行恢复时,从库会通过psync命令把自己记录的slave_repl_offset发给主库,主库会根据从库各自的复制进度,来决定这个从库可以进行增量复制,还是全量复制。
五、主从全量同步使用RDB而不使用AOF的原因:
RDB文件内容是经过压缩的二进制文件,文件很小,而AOF文件是记录每一次记录的命令。写操作越多文件会越大,在进行全量复制时,传送 RDB 文件可以降低对主库网络带宽的消耗。,从库在加载RDB文件时,一是文件小,读取整个文件的速度会很快,二是因为RDB文件存储的都是二进制数据,从库直接按照RDB协议解析还原数据即可,速度会非常快,而AOF需要依次重放每个写命令,这个过程会经历冗长的处理逻辑,恢复速度相比RDB会慢得多,所以使用RDB进行主从全量同步的成本最低。
repl_backlog_buffer 和 replication buffer
1、repl_backlog_buffer:就是上面我解释到的,它是为了从库断开之后,如何找到主从差异数据而设计的环形缓冲区,从而避免全量同步带来的性能开销。如果从库断开时间太久,repl_backlog_buffer环形缓冲区被主库的写命令覆盖了,那么从库连上主库后只能乖乖地进行一次全量同步,所以repl_backlog_buffer配置尽量大一些,可以降低主从断开后全量同步的概率。而在repl_backlog_buffer中找主从差异的数据后,如何发给从库呢?这就用到了replication buffer。
2、replication buffer:Redis和客户端通信也好,和从库通信也好,Redis都需要给分配一个 内存buffer进行数据交互,客户端是一个client,从库也是一个client,我们每个client连上Redis后,Redis都会分配一个client buffer,所有数据交互都是通过这个buffer进行的:Redis先把数据写到这个buffer中,然后再把buffer中的数据发到client socket中再通过网络发送出去,这样就完成了数据交互。所以主从在增量同步时,从库作为一个client,也会分配一个buffer,只不过这个buffer专门用来传播用户的写命令到从库,保证主从数据一致,我们通常把它叫做replication buffer。
3、再延伸一下,既然有这个内存buffer存在,那么这个buffer有没有限制呢?如果主从在传播命令时,因为某些原因从库处理得非常慢,那么主库上的这个buffer就会持续增长,消耗大量的内存资源,甚至OOM。所以Redis提供了client-output-buffer-limit参数限制这个buffer的大小,如果超过限制,主库会强制断开这个client的连接,也就是说从库处理慢导致主库内存buffer的积压达到限制后,主库会强制断开从库的连接,此时主从复制会中断,中断后如果从库再次发起复制请求,那么此时可能会导致恶性循环,引发复制风暴,这种情况需要格外注意。
注意:
一个redis 实列不要过大,尽量在 几个 GB即可,可以减少rdb文件的生成和网络开销。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论