简读笔记_Redis设计与实现_第一章_数据结构与对象
文章目录
第一部分 数据结构与对象
简单动态字符串(SDS simple dynamic string)
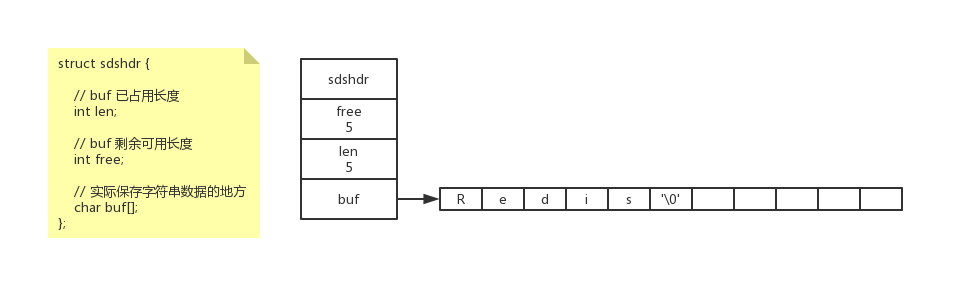
- Redis没有直接使用C语言传统的字符串表示,而是自己构建了SDS这样的抽象数据类型,并
将SDS作为Redis默认字符串表示 - SDS示例
-
SDS与C字符串的区别
-
常数复杂度获取字符串长度
- C字符串需要遍历字符数组并计数,时间复杂度为O(N)
- 而SDS的len属性记录了已占用长度,时间复杂度为O(1)
-
杜绝缓冲区溢出
- 拼接字符串的过程中 ①申请空间 ②扩充字符串 ;对C字符串而言,如果忘记了手动申请空间则会造成空间溢出 . 对sds提供的api而言,会自动进行判断待扩充字符串长度是否大于 free属性. 如果大于就自动进行空间申请,因此不会造成空间溢出
-
减少修改字符串时带来的内存重分配次数
sds通过未使用空间解除了字符串长度与底层数组长度之间的关联 (charLen+1= bufLen)
- 空间预分配
-
惰性空间释放
关于空间预分配和惰性空间释放
- 字符串增长操作时,如果需要修改长度小于1M则分配该字符串长度2倍的内存空间,如果修改后长度大于等于1M则分配该字符串长度+1的内存空间(预分配,避免每次增长操作都需要进行内存重分配执行系统调用)
- 字符串缩短操作时,程序不会立即释放缩短后多出来的字节,而是使用free属性将这些字节的数量记录下来,并等待将来使用(惰性释放,避免以后需要增长操作时分配内存. 并且提供真正释放空间的API,避免造成内存浪费)
- 二进制安全的,不是以空字符
'\0'来判断字符串是否结束,而是以 属性len - 遵循C字符串以空字符结尾的管理,可以兼容部分C字符串函数
-
链表
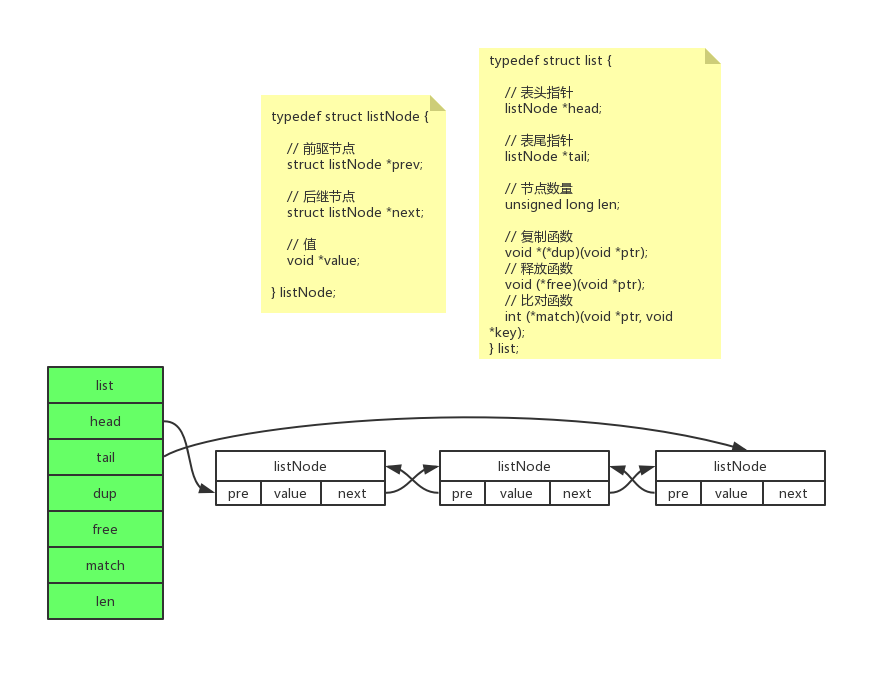
- 双向无环链表
- 记录表头和表尾结点,获取头和尾结点时间复杂度为O(1)
- 记录链表长度,获取链表时间复杂度为O(1)
- 多态 , value能保存任意类型数据
字典
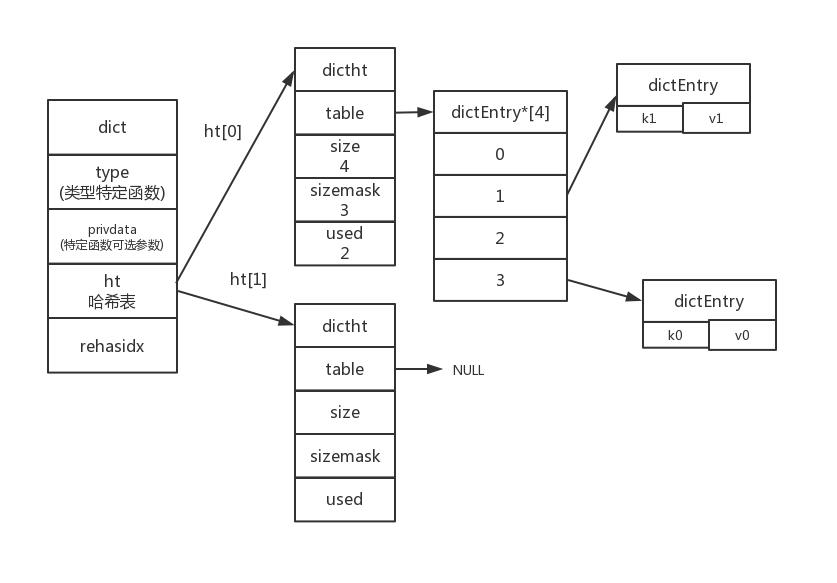
- 字典被广泛用于实现Redis的各种功能,其中包括数据库和哈希键
- 使用链地址法解决冲突,当多个键倍分配到相同哈希索引时将新键添加到节点链表表头
- 字典包含ht[0]和ht[1] (ht[1]仅为rehash时使用)两个哈希表,当哈希表保存的键值对数量太多或太少时使用重新散列rehash 维持哈希表的负载因子在合理的范围内
- Redis使用MurmurHash2算法(让哈希值尽量随机分散)来计算键的哈希值
- 考虑到数据量太大时,rehash过程可能会耗费很多时间而停止服务,因此使用的是渐进式rehash . 将rehash键值对所需的计算工作均摊到对 字典的每个添加,删除,查找,修改操作中, 避免了集中式rehash带来的庞大计算量
渐进式rehash步骤
    1. 为ht[1]分配空间,让字典同时持有ht[0]和ht[1]两个哈希表
    2. 在字典中维持一个索引计数器rehashidx,并将值设为0,表示rehash工作开始
    3. 在rehash期间, 每次对字典执行[添加,删除,查找或者更新]操作时,程序除了执行的操作外,还会顺带将ht[0]哈希表在rehashIdx索引上的键值对rehash到ht[1]中,当本次rehash结束后,rehashidx属性值+1
    4. 随着字典操作的不断执行,在某个时间点上,ht[1]所有键值对都会被rehash到ht[1],此时程序将rehashidx的属性值设为-1,表示操作已完成.
跳跃表
跳跃表是一种有序数据结构,它通过在每个节点中维持多个指向其他节点的指针,从而达到快速访问节点的目的
跳跃表的相关性质介绍: 我就是那个地址
场景
对于一组有序的集合
如果用数组来表示: 查找可以使用二分法,时间复杂度为O(logn),但插入和删除需要O(n)
如果用链表表示: 查找为O(n), 增加删除为O(1) (已知待更改位置的前驱节点).
使用跳跃表来加速链表的查找速度 : 每个节点维持多个指向其他节点的指针
跳跃表的性质:
- 跳跃表的每一层都是一条有序的链表
- 跳跃表的查找次数接近层数, 查找的时间复杂度为O(logn),插入,删除也为O(logn).
- 最底层的链表包含所有元素
- 跳跃表是一种随机化的数据结构( 插入时通过抛硬币决定跨越层数 )
- 跳跃表的空间复杂度为O(n)
下图展示了一次查找9的过程
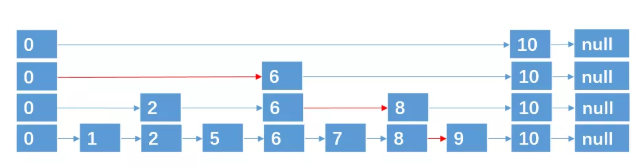
① 在第4层 , 0<9<10 因此跳到第三层,查找(0,10)区间
②在第3层 , 6<9 因此跳到第二层,查找 (6,10)区间
③在第2层 , 8<9 因此跳到第一层,查找(8,10)区间
④在第1层, 9=9 找到目标数字
跳跃表的实现

Redis中的跳跃表
- 跳跃表是有序集合的底层实现之一
- Redis的跳跃表实现由zskiplist 和 zskiplistNode两个结构组成,其中zskiplist用于保存跳跃表信息(比如表头节点 , 表尾节点 , 长度) , 而zskiplistNode用于表示跳跃表节点.
- 每个跳跃表节点的层高都是1至32之间随机数
- 在同一个跳跃表中,多个节点可以包含相同的分数,但每个节点的成员对象必须是唯一的.
- 当分值相同时,节点按成员对象的字典排序大小进行排序
整数集合
整数集合是集合键的底层实现之一,当一个集合只包含整数值元素,并且这个集合的元素数量不多时,Redis就会使用整数集合作为集合键的底层实现

目的: 尽可能的节约内存
- 可以保存 int16_t , int32_t , int64_t 三种类型的整数集
- 整数集合的底层实现为数组,这个数组以有序,无重复的方式保存集合元素
- 为了节约内存, 集合类型使用最小类型保存整数, 仅当新添加的整数大于当前所能容纳的值的范围时进行升级操作
- 添加,删除元素时间复杂度为O(n) , 查找的时间复杂度为log(n)
-
不支持降级操作
升级步骤
    1. 根据新元素的类型扩展底层数组空间,并为新元素分配空间
    2. 转换现有元素至新的类型,保持有序性防止元素
# 压缩列表
- 压缩列表(ziplist)是列表键和哈希键的底层实现之一. **当一个列表键只包含少量列表项,并且每个列表项要么是小整数值,要么是长度比较短的字符串时**,那么Redis会使用压缩列表来做列表项的底层实现
- 列表项是Redis为了节约内存而开发的,是由一系列特殊编码的**连续内存块**组成的顺序性数据结构.
## 压缩列表的构成

压缩列表:
zlbytes: 列表总长 zltail:距离表尾偏移量 zllen:节点个数 zlend:特殊值,用于标记压缩列表末尾
压缩列表节点:
previous_entry_length:前一项节点的长度(用于从尾向头遍历)
encoding:记录节点content的类型和长度(字节or字符)   contents:节点内容
连锁更新现象
previous_entry_length用于保存前一项节点的长度
当前一项长度小于254字节 该属性用1字节表示; 当前一项大于254字节,该属性用5字节表示.
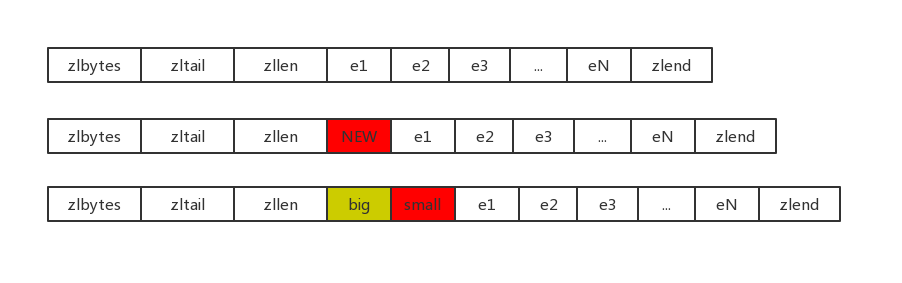
- 插入时连锁更新
当e1为250-253个字节 , 并且previous_entry_length为1个字节时, 插入New大于254字节,因此e1.previous_entry_length需要变为5字节,可能会连锁e2 e3的previous_entry_length属性也跟着变大
- 删除时连锁更新
当e1为250-253个字节 , 并且previous_entry_length为1个字节时, 删除small,因此e1的前一个节点变为较大的big节点. 导致e1.previous_entry_length需要变为5字节,可能会连锁e2 e3的previous_entry_length属性也跟着变大
总结
- 压缩列表是一种为节约内存而开发的顺序型数据结构
- 压缩列表被用作列表键和哈希键的底层实现之一
- 压缩列表可以包含多个节点,每个节点可以保存一个字节数组或整数值
- 添加或删除节点时,可能会引发连锁更新操作, 时间复杂度为O(N^2),但几率不高
对象
对象的结构
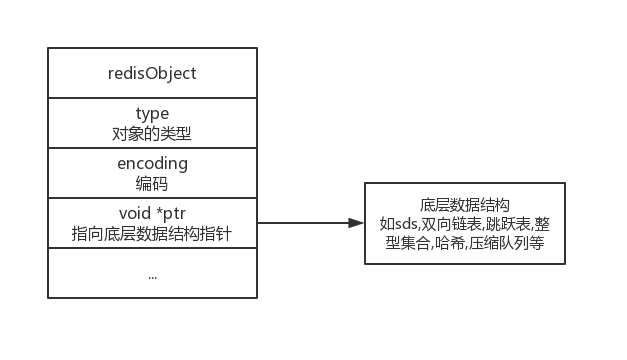
五种对象类型
| 类型常量 | 对象名称 |
|---|---|
| REDIS_STRING | 字符串对象 |
| REDIS_LIST | 列表对象 |
| REDIST_HASH | 哈希对象 |
| REDIS_SET | 集合对象 |
| REDIS_ZSET | 有序集合对象 |
底层数据结构
| 编码常量 | 对应的底层数据结构 |
|---|---|
| REDIS_ENCODING_INT | long类型的整数 |
| REDIS_ENCODING_EMBSTR | embstr编码的简单动态字符串 |
| REDIS_ENCODING_RAW | SDS |
| REDIS_ENCODING_HT | 字典 |
| REDIS_ENCODING_LINKEDLIST | 双向无环链表 |
| REDIS_ENCODING_ZIPLIST | 压缩列表 |
| REDIS_ENCODING_INTSET | 整数集合 |
| REDIS_ENCODING_SKIPLIST | 跳跃表 |
对象的编码转换
主要从内存分配和效率方面进行考虑.
当数据量较小时, 可以使用连续分配+压缩的方式, 提高内存利用率与效率
当数据量较大时, 可以使用离散分配方式 , 能更好的利用空闲的分区
字符串对象 String
字符串对象的编码可以是int , raw(sds) 或者embstr (redisObject和底层数据结构内存连续的sds)
| 值 | 编码 |
|---|---|
| 可以用long类型保存的整数 | int |
| 可以用long double表示的浮点数 | raw或embstr |
| 字符串值,或者因为长度而无法用long类型保存的整数 ,或者因为长度而无法用long double表示的浮点数 |
raw或embstr |
列表对象 List
列表对象的编码可以是ziplist或者linkedList
| 值 | 编码 |
|---|---|
| 列表对象保存的所有字符串长度小于64字节 列表对象元素数量小于512个 |
ziplist |
| 不满足上诉二者条件之一 | linkedList |
哈希对象 Hash
列表对象的编码可以是ziplist或者hashtable
| 值 | 编码 |
|---|---|
| 所有键值对的键和值的字符串长度都小于64字节 键值对数量小于512个 |
ziplist |
| 不满足上诉二者条件之一 | hashtable |
集合对象 Set
集合对象的编码可以是intset或者hashtable(hashtable的值为NULL)
| 值 | 编码 |
|---|---|
| 集合对象保存的元素都是整数值 键值对数量小于512个 |
intset |
| 不满足上诉二者条件之一 | hashtable |
有序集合对象 Sorted Set
有序集合对象的编码可以是ziplist或者skiplist(hashtable的值为NULL)
| 值 | 编码 |
|---|---|
| 有序集合保存的元素数量小于128个 有序集合保存的所有元素成员的长度都小于64字节 |
ziplist |
| 不满足上诉二者条件之一 | skiplist |
总结
- Redis数据库中每个键值对的键和值都是一个对象
- Redis共有字符串, 列表 , 哈希, 集合 , 有序集合五种类型的对象,每种类型的对象至少由两种以上的编码方式,不同的编码可以在不同场景上优化对象使用效率
- 服务器在执行某些命令之前,会先检查给定键的类型能否执行指定的命令, 即检查键的值对象的类型
- Redis的对象系统带有引用计数实现的内存回收机制,当一个对象不再被使用时,该对象所占用的内存会被自动释放
- Redis会共享值为0到9999的字符串对象
- 对象会记录自己的最后一次被访问的时间,这个时间可以用于计算对象的空转时间(LRU)
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论