数据结构-线性表
文章目录
数据结构-线性表线性表这一章比较简单(非算法),总结的套路可能比较少(树的套路比较多),做好王道的习题应该没什么问题。今天我们来总结一下线性表这一章,重点是:
- 顺序表的性质、各种的基础性操作(通过查找/遍历/移动/交换/删除等基础操作、运用)
- 单链表的性质、各种的基础性操作(通过查找/遍历/移动/交换/删除等基础操作、运用)
- 算法设计题(即手写代码。绝大部分的算法设计题是在线性表中出,理由是代码短,方法巧,区分度高。树是次重点,递归代码少好改卷。今天我就先总结基础,这个算法设计题以后出一个专门的专题来详细讲解吧)
下面针对前两点,展开总结
首先,我重提一下 逻辑结构 和 存储结构 的概念:(用我理解的大白话说,有助大家理解)
(1)逻辑结构:把计算机的细节抛掉(其实就是把数据存储结构抛掉),就是脑子希望这个数据结构应该怎么操作的,在你自己脑子(逻辑)里有个动态的过程,想怎么用就怎么用,不要考虑的计算机。 (考研爱考的 线性表、树、图)
(2)存储结构:在你脑子有了这个数据的_逻辑结构_以后,你要考虑怎么样才能要让我的想法存在计算机中,要怎么存,这就是存储结构。(考研爱考的 顺序、链式)
基于以上的讲解,在我们绪论中谈到的_逻辑结构是独立于存储结构的_有更深的理解。
(数据的存储结构是逻辑结构在计算机上的映射,不能独立于逻辑结构)
(逻辑结构 → 存储结构)
回到我们的线性表:
线性表的逻辑结构是什么呢? 就是这幅图:
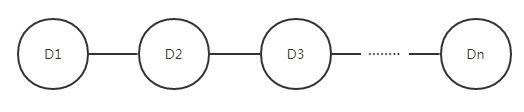
具有相同特性性数据元素的有限序列(分类 1:1的关系)
具有相同特性性数据元素的有限序列(分类1:1的关系)
逻辑结构就是这样的,所以我们要设计一个存储结构来在计算机保存这种逻辑结构。
顺序存储(顺序表—数组)
链式存储(链表—链表)
前置知识理解已经讲完开始笔记模式(尽可能的精要,书上重点的,还会加上一些自己的理解)
一、顺序表(数组)
- 1. 性质:①随机访问(查找快,直接定位) ② 存储密度高,只存储数据元素 ③ 插入、删除操作需要大量移动元素( 插入平均移动
- 2. 顺序表的插入:时间复杂度:O(n) ; 空间复杂度:O(1)
//先判断插入是否合法(省略)
for(int i=L.length; i>=pos; i--)  //pos为插入位置,数组下表从0开始
    L.data[i] = L.data[i-1];
L.data[i-1] = e;                  //e为插入元素
L.length++;                       //线性表长度加1
- 3. 顺序表的删除:时间复杂度:O(n) ; 空间复杂度:O(1)
//先判断删除是否合法(省略)
for(int i=pos; i<L.length; i++)  //pos为删除位置,数组下表从0开始
    L.data[i-1] = L.data[i];
L.length--;                      //线性表长度减1
- 4. 顺序表的访问:时间复杂度:O(1) (基于随机访问)
- 5. 顺序表的遍历和交换太简单了,估计看完一遍书绝大部分的人都会吧
- 6. 算法分析(以后会开一个专题说的,现在这个阶段先把基础打好,有能力的同学可以试试写一写数组逆置; 用O(n)的方法删除数组中不等于5的元素; 归并操作; 二分查找)这些后面都会说的
- *
二、链表
- 1. 单链表
性质: 非随机存储(查找要逐个遍历),所以查找比较慢 、插入删除操作快(已经找到了位置的前提下)
①头指针指向链表的第一个结点,头结点的带头结点链表的第一个结点(通常不存储信息)。
PS:为什么要设立头结点? 可以对链表统一操作,边界操作统一
有头结点:第一个有效数据的地址为 L->next
无头结点:第一个有效数据的地址 L
②建立:头插法、尾插法(设一个指向表尾的结点指针rear)
③插入: O(n) 如下图理解

在第i个位置 插入
p = GetElem(L, i-1);     //时间复杂度O(n)
s->next = p->next;       //①   注意①②顺序不能换,假如交换了就断链了,i-1就找不到原来i了
p->next = s;             //② (注意,单单只是将这个插入操作有时候只强调插入,即后两行代码,为O(1))
注意一个小细节,我的图跟书上的不一样,我的 “→”箭头的起始端是跟“圆圈”连起来的,其实“→”就是next域,“圆圈”就是data域,连起来才是一个结构体。而书上的箭头跟圆圈是分开的,我觉得这样不助于我们学生理解。以后我都用下面的写法来画结点这样才能完整的保留结点的存储特性。
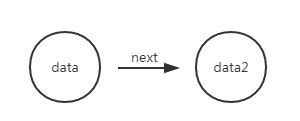
书上的写法

有助于理解的写法
④删除:O(n) 如下图理解
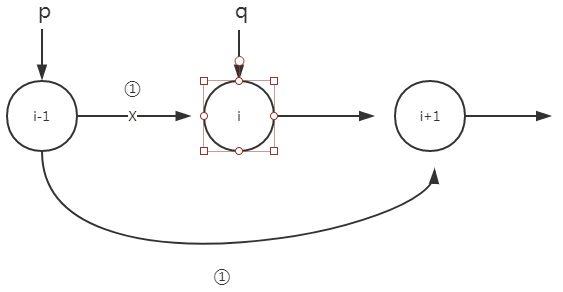
删除 第i个元素
p = GetElem(L, i-1);     //时间复杂度O(n) 后面的操作为O(1)
q = p->next;
p->next = q->next;
free(q);问:带有尾指针的单链表,在表尾插入一个元素的时间复杂度是O(1),但是删除表尾的元素时间复杂度是O(n)。 大家可以思考一下为什么?
答:
不知道大家发现没有,插入(删除)操作,都是要找到插入(删除)元素之前的一个元素,我们上面是用“p”来指向的,都是通过这个“p”来完成后续操作的。
在带有尾指针rear的链表,插入直接用 rear->next = s 就可以了,因为rear正是待插入结点的前驱节点。
而删除表尾元素,就要找到rear的前驱结点,由于单链表所以要进行一次遍历,找到rear的前驱结点,再进行删除操作。
PS:大家知道为什么要设立head头结点这么一说了吧,正是因为有了head结点这一个前驱结点,插入(删除)操作才会统一。(链表为空的插入,链表还剩下一个的时候删除)
总之,在单链表的操作中,大家一定要重视待插入(删除)的前驱结点的学习。上面总结出来的大家一定要好好理解。
- 2. 双链表:在单链表的基础上,结构体增加一个指向前驱结点的prior的指针
- 3. 循环单链表:在单链表的基础上,在表尾的next指向表头 r->next = L;
- 4. 循环双链表:在循环单链表基础上,结构体增加一个指向前驱结点的prior的指针,加上L->prior = r;r->next = L;
- 5. 静态链表:用连续的块内存空间当链表使用(跟操作系统中文件管理中的文件分配方式的显示链接一样)
以上说的都离不开单链表的基本操作,只要把单链表理解透彻,这些都是小Case。
我觉得一个适合自己的笔记,不是什么都写的非常详细,只是让自己有个索引,具体的书都是很清楚的,我就没有必要在做了重复了,免得话就跟抄书没有什么区别了。
三、顺序表与链表的选用:
- 通常比较稳定的线性表,用顺序存储。(静态)
- 频繁做插入、删除操作的线性表,用链式存储(动态)
访问查找比较多的 —— 顺序表
插入、删除比较多的,要求占空间小 —— 链表
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论