并行数据结构详解
文章目录
本文尝试描述如何设计并行数据结构,描述其中的挑战以及对应的解决思路。
看下面两个例子
spin lock
1. _spin_lock.lock();
2. x = new_value;
3. _spin_lock.unlock()
lock-free
auto expected = x.load();
do {
     bool ok = x.compare_exchange_strong(expected, new_value);
} while(!ok)
//compare_exchange_strong 解释。
// if true, 则x和expected相等,使用new_value替换x的值
//if false, 则x和expected不相等,并expected会被修改成x的值
两个例子使用不同的方式修改x的值。首先看第一个例子,使用自旋锁对一个临界区进行了加锁;第二个例子是使用原子变量的cas方式去修改值,直到修改成功。粗看这两个例子,大家肯定觉得这没啥区别啊,都是使用原子变量不断自旋,直到修改成功。
下面是例子1和2的区别:
对于例子1,第二行是临界区,如果执行在第二行的时候,操作系统当前执行的线程切走,切到其他线程来执行这个代码;下一个线程因为没有抢到锁,所以会执行lock(),这个函数内部是原子自旋,所以至少得跑满一个cpu时钟周期才会被切走,再次切走如果没有到持有锁的线程,那么继续自旋至少一个cpu时钟周期被切走,直到切换到持有锁的线程执行完成释放锁。那么我们观察到的现象将会是cpu持续跑着,但是很大多时候都是做无用功,非持有锁线程被block,系统资源利用率低下。
对于第二个例子,没有临界区的概念。compare_exchange_strong是原子操作,是不可分割的指令,所以线程只能在compare_exchange_strong执行前被切走或者执行后切走。加入线程A在compare_exchange_strong执行前被切走,那么必然有其他线程可以exchage成功,等切回来后,A在下一次循环中也会走出循环;如果线程在compare_exchange_strong后被切走,那么说明其实已经exchange成功,没有任何影响,其他线程在下一次的while中也会走出循环继续执行。
1和2最大的区别就是1在某些情况下会一个线程可能会block住其他线程,而2不存在这种情况,任何情况下,至少也能保证一个线程继续往下走。
并行数据结构的几个概念
- Non-blocking
任何一个线程执行被挂起或中断的不会导致其他线程执行被block - lock-free
保证整个系统的执行进度时不断推进的 - wait-free
保证每个线程的执行进度都是不断推进的
通常并行数据结构需要做到lock-free,wait-free通常时比较难实现,设计的时候也不强求一定达到wait-free。wait-free性能也不一定比lock-free高,因为实现wait-free需要更复杂的逻辑控制,对应会带来更多的指令集,所以会影响了执行性能。
并行数据结构
CSDS(Concurrent Search Data Structure)
- 链表,跳表,哈希表
主要实现三个接口 查找,插入,删除
- 查找的核心时搜索数据,比如遍历链表
- 插入和删除可以看着时两个阶段,第一个阶段时遍历找到正确位置,第二阶段时执行插入或者删除
实现高性能的CSDS的关键
- 搜索快,搜索过程要尽量避免耗时操作【写操作,memory barrier,原子操作】,等待和重试
- 细粒度,修改尽量涉及较小的范围;如果才用锁来实现,需要使用细粒度的锁。
非查找数据结构
- 队列 ,栈 【竞争点都在头或尾,头尾竞争激烈】
并行数据结构设计思路
通过把有序单链表改造成一个无锁的并发安全链表,来看看一个并行数据结构应该怎么设计。
先看看单链表的插入操作和删除操作的流程
插入操作
//add Node 伪代码
//cur_node 当前节点
//node 插入到当前节点后的节点
void addNode(ListNode* cur_node, ListNode* node) {
    ListNode* next = cur_node->next;
    node->next = next;
    //exchange cur_node->next
    cur_node->next = node;
    return;
}
删除操作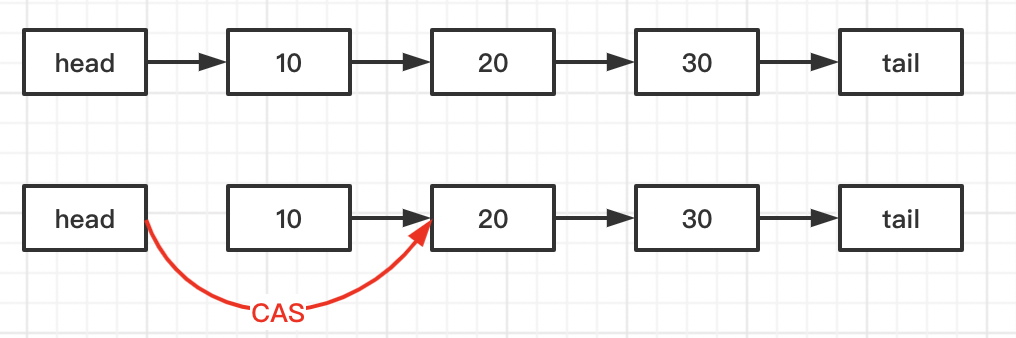
//删除伪代码
//pre_node 删除节点的前驱节点
void delNode(ListNode* pre_node) {
    ListNode* next = pre_node->next->next;
    ListNode* delete_node = pre_node->next;
    //exchange  pre_node next ptr
    pre_node->next = next;
    //free delete_node memory
    delete_node->next = nullptr;
    delete delete_node;
    return;
}
在并发场景下,并发的插入和删除操作会越到哪些问题呢?
并发修改遇到的问题
我们先使用原子变量实现一个并发安全的链表的伪代码,看看在并发修改中会遇到什么问题。
//链表的节点
strcut ListNode {
      int val;
      atomic<ListNode*> next;
};
class List {
     void add(ListNode* pre_node,  ListNode* node) {
             ListNode* next = pre_node->next->next.load();
             node->next.store(next);
             ListNode* pre_node_expected_next = pre_node->next.load();
             //前驱节点CAS 修改next指针指向
             do {
                  bool ok = pre_node->next.compare_exchange_strong(pre_node_expected_next, node);
             } while(!ok);
             return;
     }
     void del(ListNode* pre_node) {
          ListNode* next = pre_node->next->next.load();
          ListNode* deleted_node = pre_node->next.load();
          //前驱节点CAS 修改next指针指向
          do {
             bool ok = pre_node->next.compare_exchange_strong(deleted_node, next);
          } while(!ok)
          //free deleted node
          deleted_node->next.store(nullptr);
          delete deleted_node;
     }
};
插入和删除的冲突
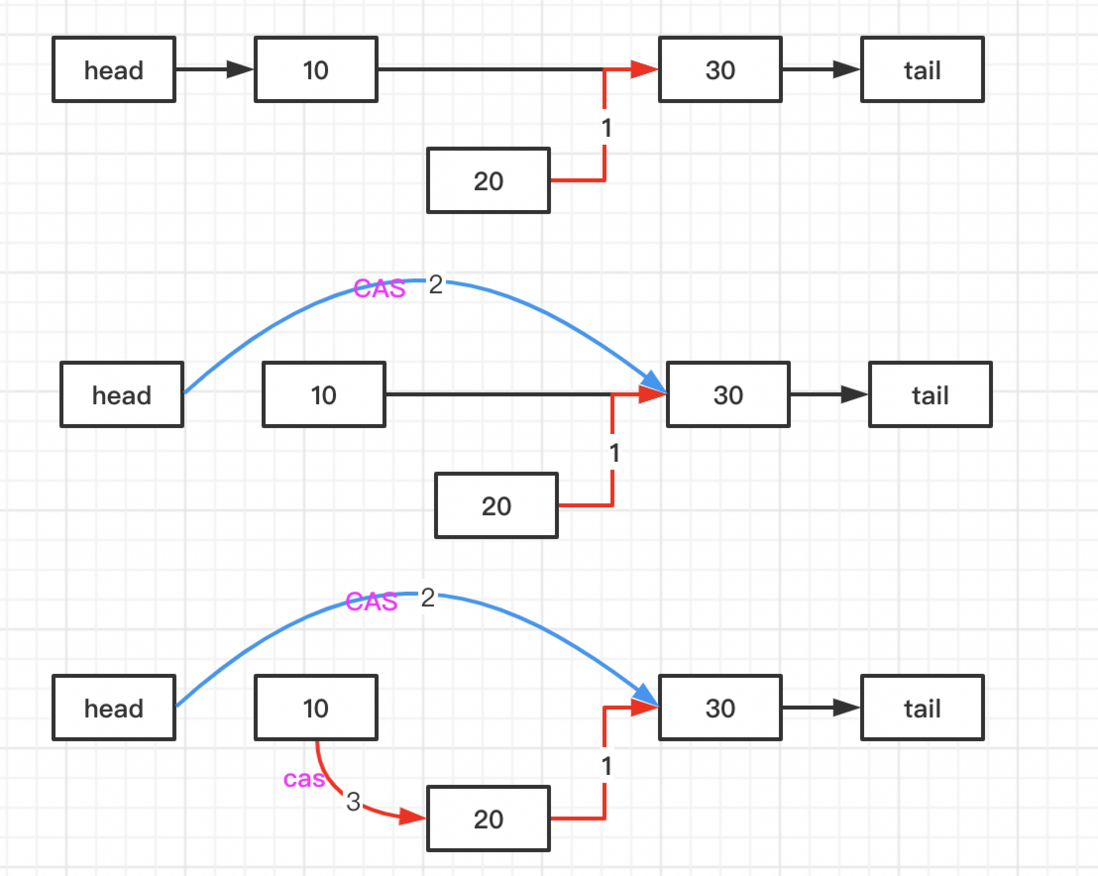
线程1插入正在20的时候,这时候线程2正在删除10。虽然20节点插入动作完成,但实际上20节点并没有真正的插入到链表中。
从上面的代码分析来看,当修改节点10next指向的时候,其实节点10本来可能也被其他线程从链表中删除,当前线程无法感知,cas可以执行成功。所以说插入动作虽然完成,但实际上没有真正插入链表。这就是插入和删除的冲突。
删除和删除的冲突

线程1正在删除节点10,线程2正在删除节点20。线程2删除动作虽然完成,但是节点20并没有从链表中被真正删除。
从上面删除代码可以看出,删除的时候,当前线程并不知道前驱节点是否被其他线程操作,即使被操作了,但是CAS操作还是成功的,只是执行CAS的节点可能不在链表上了。所以会出现这个删除和删除的冲突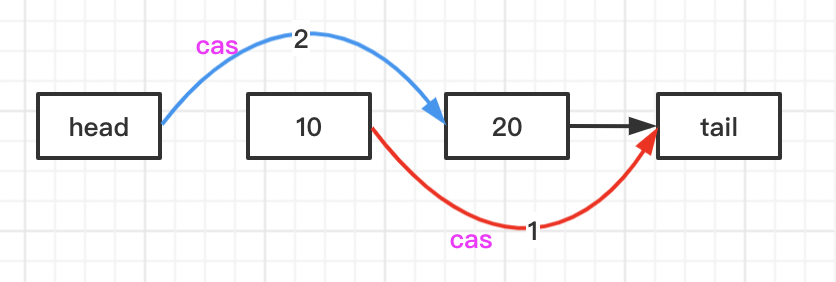
和上面的case类似,节点20在被删除的同时,它的前驱节点10也被删除,等前驱节点删除动作完成后,节点20又回到链表中了。
内存管理问题
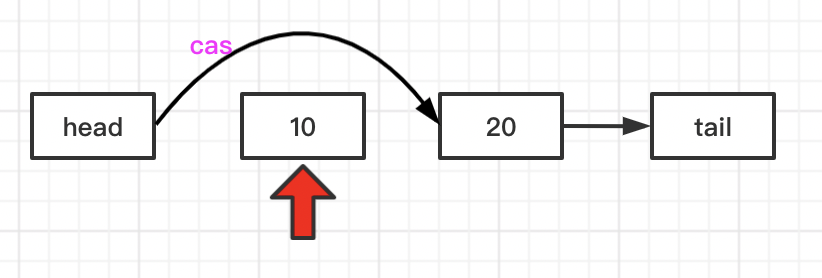
节点10的内存的释放时机是什么时候呢?如果按照上面例子的代码实现,那么在生产环境下一定会崩溃,因为这时候可能有其他线程持有这个节点在操作,所以不能立即释放节点的内存。
这个问题的难点在于怎么知道这个节点没有被其他线程持有,安全是否内存的时机是什么时候?
ABA问题

在线程1执行节点20插入的时候,其他线程对节点10进行删除并释放内存,其他线程插入节点25,恰巧节点25分配的内存和节点10分配的内存一样【在使用内存池的场景下因为内存复用,这个问题还是很常见的】。节点20的前驱节点是之前节点10的内存地址,所以前驱节点执行CAS后,节点25就指向节点20了,导致链表乱序。
线性化问题
线性化问题简单定义:当我们遍历链表时,遍历的结果一定得是历史上存在过的链表版本数据。
举个例子说明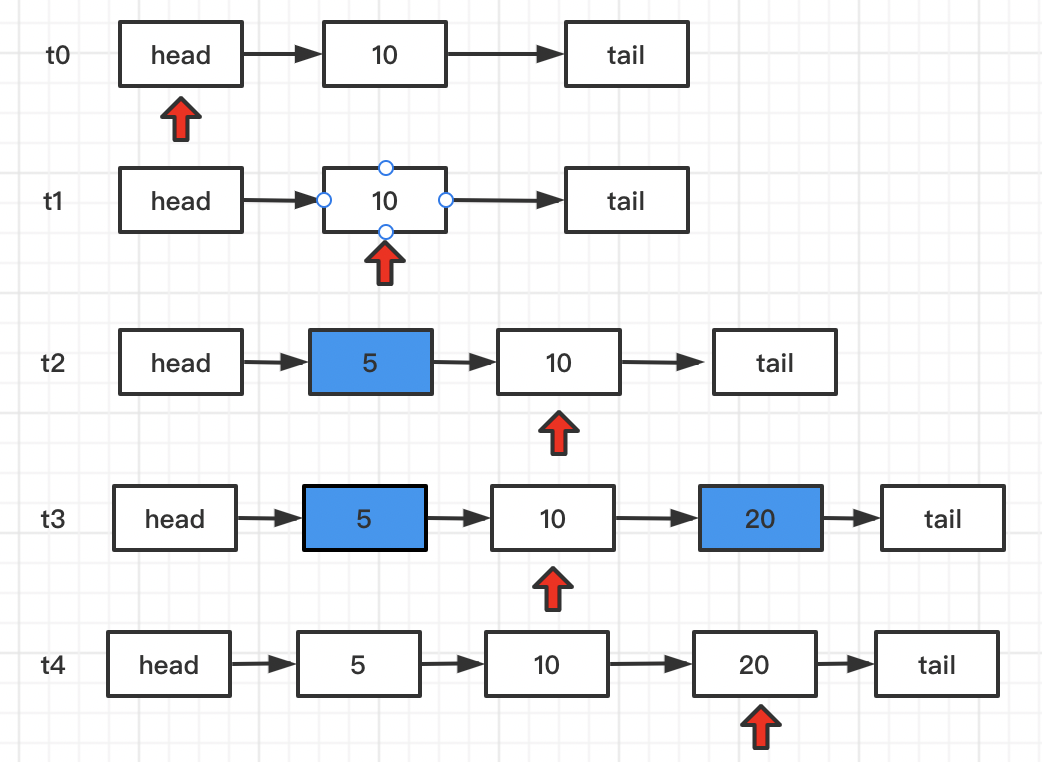
t0时刻我们开始遍历链表
t1时刻 遍历线程(10)
t2时刻其他线程把节点5插入链表,遍历线程(10)
t3时刻其他线程把节点20插入链表,遍历线程(10)
t4时刻 遍历线程(10,20),结束
最终的遍历结果是(10,20),但是(10,20)并没有在链表中真实存在过,是个错误的数据。
这个问题比较好解决,不提供遍历操作即可【按照CSDS的定义,单链表只提供三个操作:任意 位置的插入、任意位置的删除和全链表范围内的查找,并且保 证这三个操作是线性化的】或者提供遍历时候,给使用者返回当前链表的快照即可。
解决方案
基本思路:大部分问题的产生都是因为删除操作导致的,那么对删除操作的优化手段如下:
节点不删除【先标记再集中GC,GC加锁】
- 查找,插入,标记都很快,gc会造成短暂阻塞,会出现长尾
节点删除不释放内存【可重用,比如放到内存池】
- 查找,删除,插入都很快,但是内存会不断增长
节点删除且释放内存
- 通常使用引用计数的方式来管理链表内存释放、每次遍历都需要对节点进行引用计数,对查找、插入、删除的性能都有比较大的影响。
插入删除冲突解决方案
使用指针标记法可以完美解决这个问题。
这个图可以看出,问题的根本原因是决定要删除节点10后,10的next指针出现的变化。如果能在删除节点10前,把节点10的next指针锁定【不允许修改指针指向】,那么是可以解决删除和插入的冲突的。
两阶段方法删除节点,比如删除节点10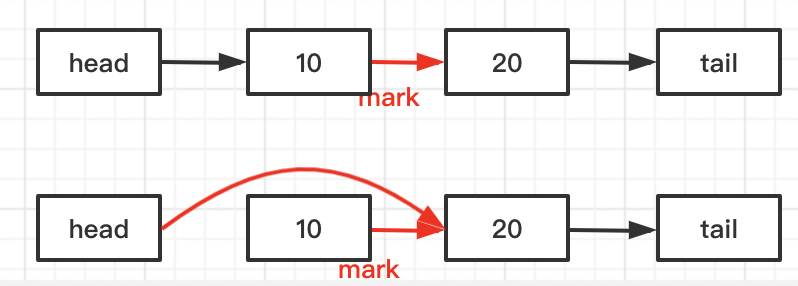
- 标记节点10的next指针【1比特位放入next指针中,读写指针和标记位可以做到原子,一旦标记,指针不可被修改】
- 修改前驱节点的next指针指向节点20.
下面看看这个方法怎么解决删除和删除的问题
伪代码如下
bool del_node(ListNode* pre_del_node) {
        ListNode* del_node = pre_del_node->next.load();
        //1. 标记del_node->next;
        ListNode* excepted_next = del_node->next.load();
        //2. next指针添加标记位
        if (!del_node->next->compare_exchange_strong(excepted_next, excepted_next&1)) {
            return false;
        }
        //3. 修改前驱节点next指针
        if(!pre_del_node->next.compare_exchange_strong(del_node, del_node->next)) {
            return false;
        }
        return true;
}
看下面例子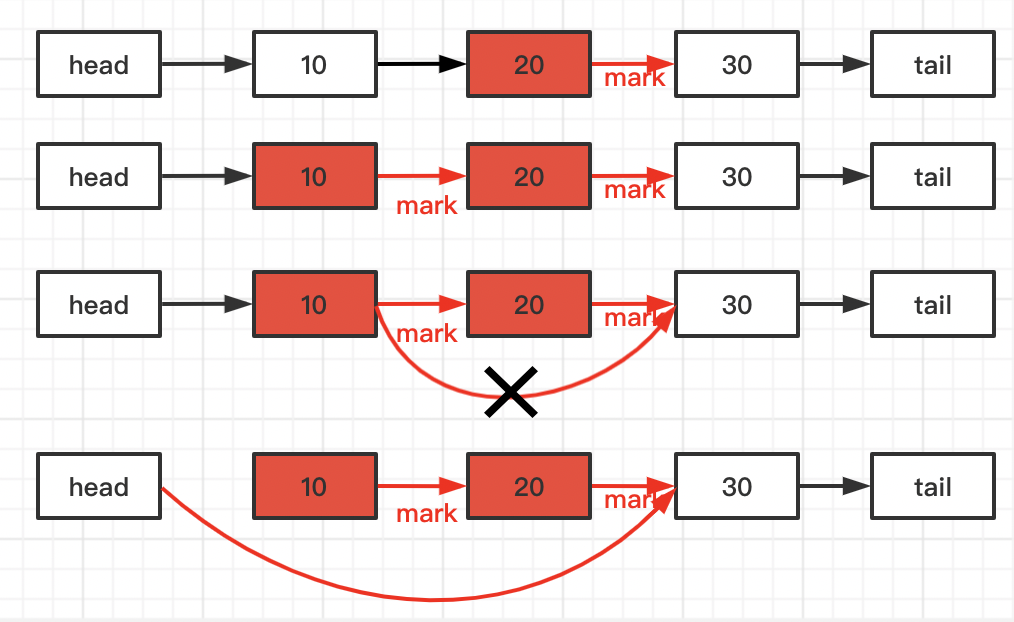
- 线程1删除节点20,线程2删除节点10
- 根据上面的代码可以看到冲突点。假如线程1执行到代码序号3的位置,线程2执行到代码序号2的位置。这时候,如果线程1先执行,那么节点10的next指到节点30,线程2去标记节点的10的next会失败;如果线程2先执行,给节点10的next打好标记,那么线程1修改前驱节点的next会失败。
这样就很好的解决了删除和删除的冲突了
删除和插入的冲突解决
继续先看伪代码
bool insert(ListNode* pre_node, ListNode* add_node) {
      //1. 获取前驱节点的next
      ListNode* next = pre_node->next.load();
      add_node->next = next;
      //2. CAS ,修改前驱节点指向
      return pre_node->next.compare_exchange_strong(next, add_node);
}
结合上面的删除代码,我们可以看到,比如线程1执行删除节点,线程2执行添加节点,在删除节点的代码2处和添加节点的代码2处,只会有一个是成功的。
假如线程1先执行到删除代码2处,那么前驱的next已经被标记,那么插入线程代码执行到2处CAS就会失败;如果先执行插入代码2处,那么前驱节点next以及被修改,那么对原前驱节点的next指针打标记的cas操作就会失败。
ABA问题
使用tagged pointer来解决ABA问题。即在指针身上带上版本号来进行管理。
原理是使用指针的最高16位来存指针的版本信息,每次指针内容发生变化版本号。能这么使用是因为通常cpu寻址用不了64位,毕竟现实内存没那么大,即使留48位,寻址空间也能有256T,完全是够用的。所以针对ABA问题,使用tagged pointer是一个比较好的选择。
boost上提供具体实现,参考:https://www.boost.org/doc/lib...
内存管理问题
风险指针Hazard Pointers
原理如下:
- 每个线程把自己访问的节点的地址放到全局可见的地方。比如线程A正在访问两个节点,它们的地址是P1和P2,这些全局可见的指针称为风险指针。线程在访问完这些节点之 后,清除自己的风险指针。
每个线程有一个free list,当节点A从链表摘除后,被放到当前线程的free list。然后检查所有其它线程的风险指针,看有没有和节点A的地址相同的,如果没有,说明没有其它人正在访问节点A,节点A可以从内存释放。
伪代码如下
遍历链表for (p = head; p != tail; p = p->next) { //当前指针赋值给风险指针,放入freelisy hazard_ptr = p; //通过memory_barrier保证上面代码一定生效,保证全局可见。memory_barrier操作对性能有些开销 memory_barrier(); //再次检查 p还在链表中。 check_in_list(p); //访问p access(p); } //遍历很慢,性能不好删除节点
del_node(ListNode* p) {
     //先从链表中删除p
     delete_node_in_list(p);
     //检查其他线程的风险指针list是否还存在p
     if (!check_other_thread_hazard_list()) {
           //如果不存在,那么是否p
           free(p);
     }
}
这个方式总得来说可以达到安全释放的目标,但是真实实现起来还是比较复杂的。有很多点需要优化才能工程上使用。比如存放全局可见的风险指针自身也得保证线程安全,怎么高效实现?
Shared_ptr List
使用智能指针来组织链表,每个ListNode* 都是shared_ptr。
这个的问题在于:- 在遍历链表时,每走过一个节点,都需要引用计数加1,离开时需要引用 计数减1,而原子操作比较慢,违反了CSDS要求搜索快的原则
- 采用递归方式释放整个链表,或者链表中的一段,有可能导致栈溢出
- 如果一个线程获得一个节点的引用计数,但是被卡住,等了好久才释放这个引用计数,那么该节点的所有后继节点都会被延迟释放。
总结
对于删除、插入冲突其实还是比较好解决的;但是内存管理这块没有太好的解决方案,需要根据自己的一些场景,来容忍内存管理带来的对于遍历性能下降的容忍或者内存上涨的一些容忍。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论