我所知道数据结构之哈希表
文章目录
作者前言
大家好,我是阿濠,今篇内容跟大家分享的是数据结构之哈希表,很高兴分享到segmentfault与大家一起学习交流,初次见面请大家多多关照,一起学习进步.
前言介绍
在前面的文章中,先后学习了线性表、数组、字符串和树,并着分析它们对于数据的增删改查操作对于数据处理他们彼此各有千秋,例如
- 线性表中的
栈和队列对增删有严格要求,它们会更关注数据的顺序 -
数组和字符串需要保持数据类型的统一,并且在基于索引查找上会更有优势 -
树的优势则体现在数据的层次上
但是它们也存在一些缺陷:数据条件的查找,都需要对全部数据或者部分数据进行遍历
有没有一种方法可以省去数据比较的过程,从而进一步提升数值条件查找的效率呢?
那么接下来将介绍一种高效率的查找神器:哈希表
一、什么是哈希表?
基本介绍
哈希表名字源于Hash,也可以叫作散列表。哈希表是一种特殊的数据结构,是根据关键码值(Key value)而直接进行访问的数据结构。它与数组、链表以及树等数据结构相比,有明显的区别。
哈希表的核心思想
在之前的数据结构里,数据的存储位置和数据的具体数值之间不存在任何关系,因此在查找问题时,这些有些数据结构必须采取逐一比较的方法实现。
而哈希表的设计采用了函数映射的思想,将记录存储位置和记录关键字关联起来,可以快速定位到需要查找的记录以及不需要与表中的记录进行比较后再查找
也就是说,它通过把关键码值映射到表中一个位置来访问记录,以加快查找的速度。这个映射函数叫做散列函数,存放记录的数据叫做散列表。
示例认识哈希表
假如对一个手机通讯录进行存储,并且根据姓名找出一个人的手机,如下所示
- 张一 : 13212345678
- 张二 : 13112345678
- 张三 : 18112345678
- 张思 : 18012345678
方法一:定义包含姓名、手机号码的结构体、再通过链表把四个联系人的存储起来当要判断'张四'是否在链表中,或者通过'手机号'查找时,需要从链表头结点开始遍历,依次将节点中的姓名字段与'张四'比较。
直到查找成功或者全部遍历一遍为止,这种做法的时间复杂度为O(n);
方法二:借助哈希表的思路,降低时间复杂度构建姓名到地址的映射函数,这样可以在O(1)的时间复杂度完成数据的查找,即"地址 = F(姓名)"
哈希函数
假如对上面的例子采用的Hash函数为:姓名的每个字的拼音开头大写字母的ASSII码之和,那么上面的手机通讯录例子如下所示
- address(张一) = ASCII(Z) + ASCII(Y) = 90 +89 =179
- address(张二) = ASCII(Z) + ASCII(E) = 90 +69 =159
- address(张三) = ASCII(Z) + ASCII(S) = 90 +83 =173
- address(张四) = ASCII(Z) + ASCII(S) = 90 +83 =173
那么就会出现一个问题:'张三'与'张四'哈希函数值一致,这就造成哈希冲突了!
从本质上来说,哈希冲突只能尽可能的减少,不能完全避免,因为输入的数据是开放集合
这样就说明哈希表需要设计合理的哈希函数,并且对冲突有一套处理的机制解决
如何设计哈希函数
对于哈希冲突问题,那么我们如何设计呢?先来看看常用的哈希函数方法
一、直接定制法
哈希函数为关键字到地址的线性函数,即 H(key) =a * key + b,这里a 和 b 是常数
二、数字分析法
假设关键字集合中每个关键字key 都由 s 位数字组成(k1,k2,k3,...,ks),则从提取分布均匀的若干位组成哈希地址
三、平方取中法
如果关键字的每一位都有某些数字重复出现,并且频率很高,可以先求关键字的平方值,并且通过平方扩大差异,并取中间几位作为最终存储地址
四、折叠法
如果关键字的位数很多,可以将关键字分割为几个等长的部分,取它们的叠加和的值(舍去进位)作为哈希地址
五、除留余数法
预先设置一个数,对关键字进行取余(%)运算。即地址为 key mod p
如何解决哈希冲突
常用的哈希函数方法一旦发生哈希冲突,我们该怎么解决?常用方法解决介绍
一、线性探测法
当一个关键字和另一个关键字发生冲突时,使用某种探测技术在哈希表中形成一个探测序列,然后沿着探测序列依次查找下去,一旦碰到一个空的单元时,则插入其中。
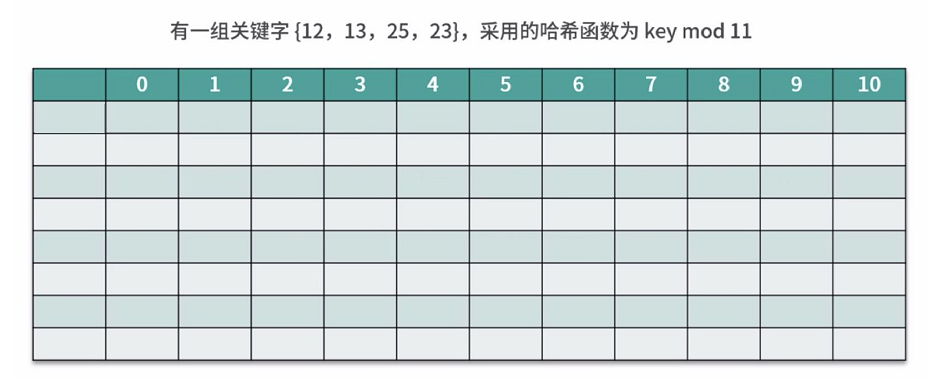

依次插入12,13,25 则无问题,当插入23 时(23 % 11)= 1 造成冲突,地址一 已被占用,因此沿着地址一探测,直至地址四为空,则将插入其中。

二、链地址法
将哈希地址相同的记录存储在一张线性链表中
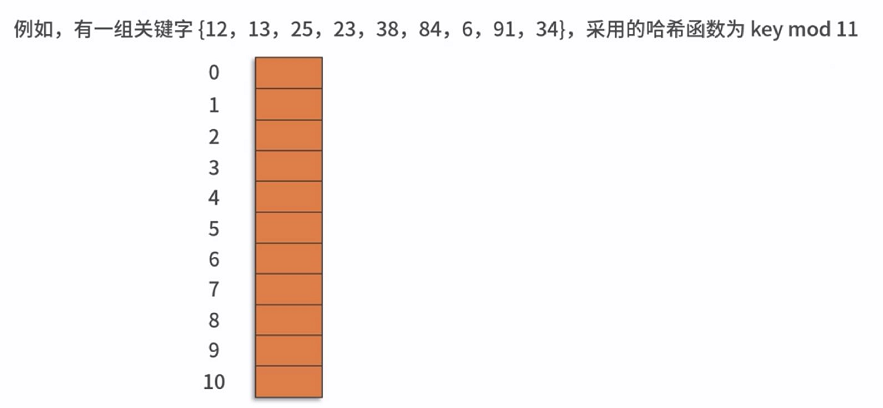
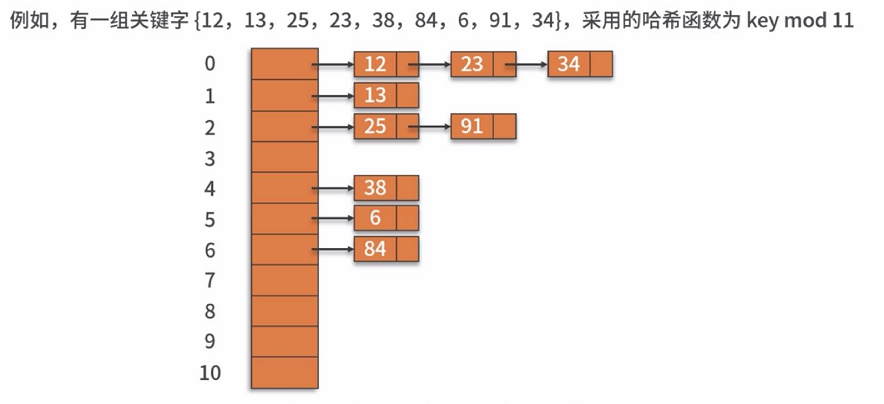
哈希表的优势:
它以提供非常快的 插入 - 删除 - 查找操作 ,无论多少数据,插入和删除只需要接近常量的时间,在查找方面,有时候比树还快,基本可以一下定位到查找的元素
哈希表的不足:
哈希表中的数据时没有顺序概念的,所以不能以一种固定的方式(比如从小到大)来遍历其中的元素,并且哈希表中key是不允许重复的。
二、通过应用实例认识哈希表
先来看一个实际需求,有一个上机题:
有一个公司,当有新的员工来报道时要求将该员工的信息加入(id、性别、年龄、住址...)
问题:当输入该员工的id时,要求查找到该员工的所有信息.
要求:不使用数据库,尽量节省内存,速度越快越好,添加时保证id从低到高插入
这个时候就可以使用链表哈希表(Hash table),处理冲突采用链地址法

思路图解分析
哈希表里每个元素都是一个链表,指向雇员信息而雇员信息又可以指向下一个雇员信息,链表管理雇员,而哈希表管理链表.....
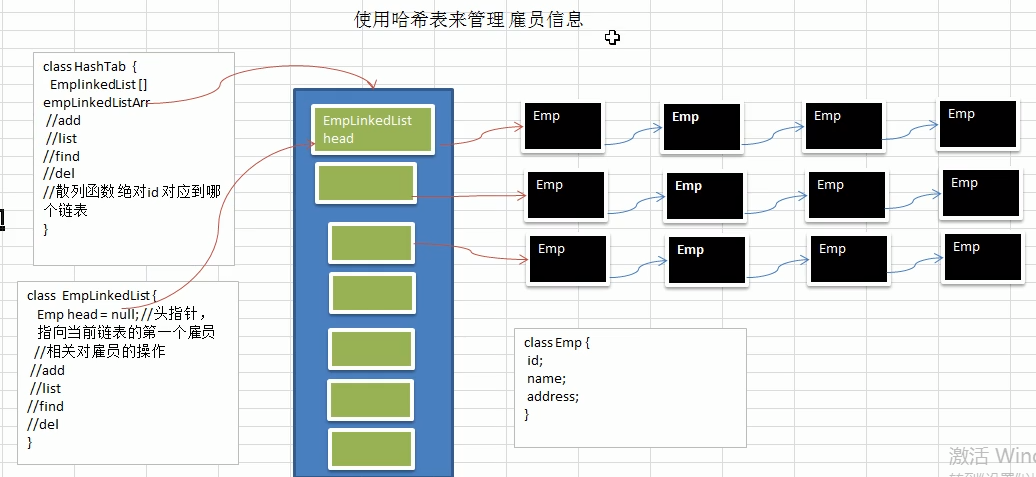
//表示雇员类
class Emp{

    public  int id;     //雇员Id

    public String name; //雇员名称

    public Emp next;    //下一位雇员


    public Emp(int id, String name) {
            this.id = id;
            this.name = name;
    }

}

//EmpLinkedList 雇员链表
class EmpLinkedList{

    //头指针 指向第一个雇员 链表头指针直接指向第一个Emp
    private Emp headEmp;

    //添加雇员到链表
    //1.假设添加雇员时 id是自增长 即id总是从小到大的
    // 因此我们可以假设添加雇员到链表的最后
    public void add(Emp emp){

        //如果添加的是第一个雇员
        if(headEmp == null){
            headEmp = emp;
            return;
        }

        //如果不是第一个雇员则使用指针指向帮忙定位到最后
        Emp curEmp = headEmp;
        while (true){
            //说明已到链表最后了
            if (curEmp.next == null){
                break;
            }
            curEmp = curEmp.next;
        }
        //退出时将当前emp 加入链表
        curEmp.next = emp;
    }

    //根据id 找到对应雇员所在的链表位置
    //若没有则返回为空
    public Emp findEmpById(int id){

        //若链表当前头指针为空则代表链表里没有数据
        if(headEmp == null ){
            System.out.println("当前链表为空");
        }

        Emp curEmp = headEmp;
        while (true){

            //若链表里的id == 要找的id 则代表找到了
            if(curEmp.id == id){
                break;
            }
            //链表最后元素也不满足 则链表里没有要找的id
            if(curEmp.next ==null){
                curEmp = null;
                break;
            }
            //进行后移查找
            curEmp = curEmp.next;
        }

        return curEmp;
    }


    //遍历当前链表的所有雇员信息
    public void list(int no){

        //判断当前链表是否有数据
        if(headEmp == null){
            System.out.println("当前"+(no+1)+"链表为空!");
            return;
        }
        System.out.println("当前"+(no+1)+"链表信息为");
        Emp curEmp = headEmp;
        while (true){
            //输出信息
            System.out.printf("=> id=%d name=%s \t ",curEmp.id,curEmp.name);

            //如果是最后一个则结束
            if (curEmp.next == null){
                break;
            }
            //往后移动
            curEmp=curEmp.next;
        }
    }
}

//hasTab 管理多条链表
class HashTab{

    private EmpLinkedList[] linkedListArray;

    private int size;//表示有多少条链表

    public HashTab(int size){

        this.size = size;

        linkedListArray = new EmpLinkedList[size];

        //哈希表里的每个链表都初始化创建,否则为链表为空
        for (int i =0; i<size; i++){
            linkedListArray[i] = new EmpLinkedList();
        }
    }

    //链表添加雇员
    public void add(Emp emp){
        //根据当前员工的id 找到合适添加的链表
        int emplikedListNo = hashFun(emp.id);
        linkedListArray[emplikedListNo].add(emp);
    }

    //遍历linkedListArray里的所有的链表
    public void list(){
        for (int i = 0 ;i< linkedListArray.length; i++){
            linkedListArray[i].list(i);
        }
    }

    //根据输入的id 找到合适的链表进行查找信息
    public void findEmpById(int id){

        //确定查找的id 在那个链表里
        int emplinkedNo = hashFun(id);
        Emp emp = linkedListArray[emplinkedNo].findEmpById(id);
        if (emp!=null){
            System.out.printf("在 %d 该链表中找到该 id = %d 雇员\n ",(emplinkedNo+1),id);
        }else {
            System.out.println("在哈希表中没有找到输入的id雇员");
        }
    }


    //编写散列函数 使用取模法
    public int hashFun(int id){
        return id % size;
    }

}
接下来添加数据测试一下把
public static void main(String[] args) {

    //创建长度为 7 的哈希表
    HashTab hash =new HashTab(7);
    //初始化雇员数据
    Emp emp1 =new Emp(1,"张三");
    Emp emp2 =new Emp(2,"李四");
    Emp emp3 =new Emp(3,"王五");
    Emp emp4 =new Emp(8,"王五");

    //根据当前雇员id找到合适的链表位置
    hash.add(emp1);
    hash.add(emp2);
    hash.add(emp3);
    hash.add(emp4);

    //查看当前哈希表里的链表数据
    hash.list();

    //查找id = 9 的雇员
    hash.findEmpById(9);

    //查找id = 3 的雇员
    hash.findEmpById(3);

}

输出结果为:
当前1链表为空!
当前2链表信息为=> id=1 name=张三      => id=8 name=王五
当前3链表信息为=> id=2 name=李四
当前4链表信息为=> id=3 name=王五
当前5链表为空!
当前6链表为空!
当前7链表为空!
在哈希表中没有找到输入的id雇员
在 4 该链表中找到该 id = 3 雇员
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论