OCRunner 第一篇:实现一个简单版热修复功能

文章目录
作者: SilverFruity, https://github.com/SilverFruity
小编寄语:
上一周我们发布了《OCRunner 第零篇:从零教你写一个 iOS 热修复框架》。很多读者对这个方案是否能上架特别感兴趣。在这里统一做一下回复:
根据作者描述,这个框架没有调用任何私有 API,目前是可以上架的。
当然,我们也觉得做技术的要对一些新鲜事物带有一棵好奇之心,搞清楚其中原理比这个东西是否能上线比更重要。
至于怎么上线以及是否符合苹果规范就看各家产品决策了。审核本身是一个博弈的过程,毕竟像 RN、Weex 这类的都是可以动态下发代码的,现在有很多产品可以上线。但是像 JSPatch 却又被定义成有安全风险不让上线。
相信看完今天这篇文章的朋友,应该能理解为什么这个方案可以上线。尤其是误以为 OCRunner 是基于 JSCore 一定要花时间好好了解一下哦。
在正文开始前,我们先看看给出的语法树解释执行.gif,OCRunner的核心解释执行部分也是如此。
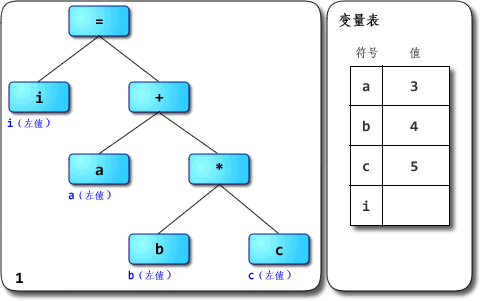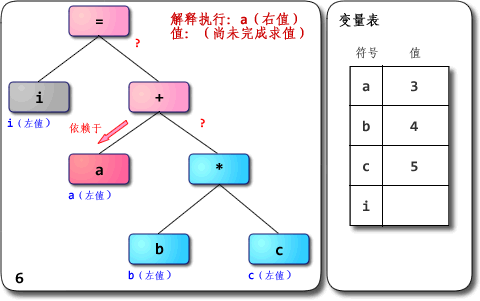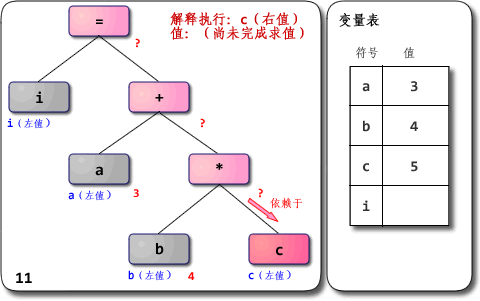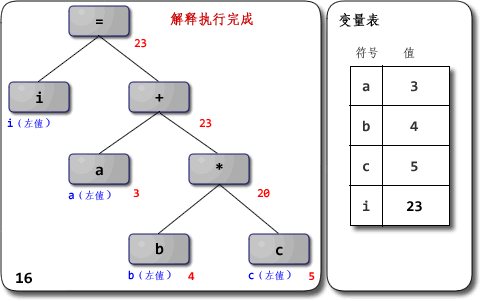
本图出自: 虚拟机随谈(一):解释器,树遍历解释器,基于栈与基于寄存器,大杂烩
如果你让我仅仅只靠文字就能给你解释清楚 OCRunner 是怎么运行起来的,你们可能是在为难我小蒋,肚子里墨水真的没那么多啊,太难了😂。所以在这一小节,我给大家准备了一个简单版 OCRunner,希望大家能从这个例子中,真正知道它是如何运行的。
希望你们看见项目中的 SingleEngine 类不要笑(哈哈哈),我只是想表达 单缸发动机 的意思 - _ -,我心爱的小摩托就是单缸拖拉机。
本节假设读者并不具备编译相关的知识。
本文对 lex 和 yacc 介绍有限,关于 flex 和 bison 的详细使用可以参照《flex与bison中文版》或者 《flex&bison》。
SimpleOCRunnerDemo[1],建议使用 git clone 的形式下载源码,每个小节的相应源码都对应在各自的 commit 里。通过边看文章边阅读源码的形式食用,更香哟。
我们将通过以下这个例子,来说明 OCRunner 执行的主要实现,将省略补丁文件的序列化和加载过程。
现在,我们的目标是让这段文本像 C 一样执行,并且最终变量 c 的值为 5 。
int d = 2; int add(int arg0, double arg1){ return arg0 + arg1 + d; } int a = 1; double b = 2.0; int c = add(a, b);
词法分析器
通俗来说,词法分析就是将符合相应规则的字符串转换为一个 Token(可以将它看为一个由类型和值两个属性组成的类)。
比如当匹配到 'int' 时,'int' 将会被转换为 INT_TYPE ,也是就是 Token 的类型,它的值可以是我们后续的值类型(一个枚举)。
再比如当匹配到 '1.0' 字符串时,'1.0' 被转换为 DOUBLE_LITERAL 类型并且 Token 此时的值为浮点数 1.0。
针对这里例子,我们现在有如下几个规则:
关键词: int、double、return
标识符(可以是变量名、类型等): 以字母、_ 、$ 开头的字符串
数值: 整数、浮点数
符号: ( ) ; { } , = +
上述都是我们接下来需要识别的,我们将直接使用 flex 完成词法分析器。
词法分析器 lexer.l 中的代码:
%option noyywrap %{ #import <Foundation/Foundation.h> #include "y.tab.h" %} %% "," { return ',';} ";" { return ';'; } "(" { return '('; } ")" { return ')'; } "{" { return '{'; } "}" { return '}'; } "=" { return '='; } "+" { return '+'; } "-" { return '-'; } "int" { return INT_TYPE; } "double" { return DOUBLE_TYPE; } "return" { return RETURN; } // 浮点数 [0-9]+\.[0-9]+ { yylval.doubleValue = atof(yytext); return DOUBLE_LITERAL; } // 整数 [1-9][0-9]* { yylval.intValue = (int)strtol(yytext, NULL, 10); return INTETER_LITERAL; } // 标识符 [A-Za-z_$][A-Za-z_$0-9]* { yylval.stringValue = yytext; return IDENTIFIER; } %%
Flex语法简单简介
上半部分的
%{ %}主要用于书写 C 代码,引入头文件,自定义函数等等,最终会以文本的形式被添加到 lexer.yy.c 中( Demo 中你可以在编译缓存中找到该文件)。下半部分的
%% %%就是关键了,通过使用正则表达式,将符合规则的字符流转换为相应的 token 。yylval这则是 Token 的值,默认情况下它一个 int 类型,但是在 bison 中可以使用 %union 声明来重新定义它的类型。
当我们调用词法分析器后,上述文本将会做出如下转换,如何对它进行语法匹配,这就是接下来的内容了。
`int d = 2 ;
INT_TYPE IDENTIFIER = INTETER_LITERAL ;
int add ( int arg0 , double arg1 ) {
INT_TYPE IDENTIFIER ( INT_TYPE IDENTIFIER , DOUBLE_TYPE IDENTIFIER ) {
return arg0 + arg1 + d ;
RETURN IDENTIFIER + IDENTIFIER + IDENTIFIER ;
}
}
int a = 1 ;
INT_TYPE IDENTIFIER = INTETER_LITERAL ;
double b = 2.0 ;
DOUBLE_TYPE IDENTIFIER = INTETER_LITERAL ;
int c = add ( a , b ) ;
INT_TYPE IDENTIFIER = IDENTIFIER ( IDENTIFIER , IDENTIFIER ) ;`
语法分析器
语法分析器 parser.y 中的代码,目前还没有任何语法相关的逻辑。
`%{
#import <Foundation/Foundation.h>
#define YYDEBUG 1
#define YYERROR_VERBOSE
extern int yylex (void);
extern void yyerror(const char *s);
%}
%union{
uint64_t intValue;
double doubleValue;
char *stringValue;
__unsafe_unretained id object;
}
%token IDENTIFIER
%token DOUBLE_LITERAL
%token INTETER_LITERAL
%token INT_TYPE
%token DOUBLE_TYPE
%token RETURN
%start door
%type
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论