深入学习Redis之特性及命令
文章目录
什么是 Redis
Redis 是完全开源的,遵守 BSD 协议,是一个高性能的 key-value 数据库。
Redis 与其他 key - value 缓存产品有以下三个特点:
- Redis 支持数据的持久化,可以将内存中的数据保存在磁盘中,重启的时候可以再次加载进行使用。
- Redis 不仅仅支持简单的 key-value 类型的数据,同时还提供 list,set,zset,hash 等数据结构的存储。
- Redis 支持数据的备份,即 master-slave 模式的数据备份。
Redis 的特性
特性一:速度快
官网声称可以达到:10 万 QPS
- 数据是存在内存中的。
- 使用 C 语言编写。
- 单线程模型。
Redis 速度快的主要原因就是内存

从快到慢依次是:
- Register 寄存器
- L1 Cache 一级缓存
- L2 Cache 二级缓存
- Main Memory 主存
- Local Disk 本地磁盘
- Remote Disk 远程磁盘
| 类型 | 每秒读写次数 | 随机读写延迟 | 访问带宽 |
|---|---|---|---|
| 内存 | 千万级 | 80ns | 5GB |
| SSD 盘 | 35000 | 0.1-02ms | 100~300MB |
| 机械盘 | 100 左右 | 10ms | 100MB 左右 |
特性二:持久化
Redis 所有数据保存在内存当中,对数据的更新将以异步方式保存到磁盘上。
Redis 支持两种持久化方式:
- RDB
- AOF
特性三:多种数据结构

另外在 Redis 从 2.2.0 版本开始新增了三种数据结构:
Bitmaps 和 HyperLogLog 其实本质上是字符串,并不算是真实的数据结构,而 GEO 本质上有序集合实现的。
• BitMaps:可以实现对位的操作。可以把 Bitmaps 想象成一个以位为单位数组,数组中的每个单元只能存 0 或者 1,数组的下标在 bitmaps 中叫做偏移量。单个 bitmaps 的最大长度是 512MB,即 2^32 个比特位。
• HyperLogLog:超小内存唯一值计数。特点是速度快,占用空间小。
• GEO:地理信息定位。
特性四:支持多种客户端语言
- Java
- PHP
- Python
- Ruby
- Lua
- Node
- ...
特性五:功能丰富
- 提供发布订阅功能。
- 支持事务。
- 支持 Lua 脚本。
- Pipeline。
特性六:"简单"
- Redis 的单机核心代码只有 23.000 行左右。
- Redis 不依赖外部库。
- Redis 是单线程模型。
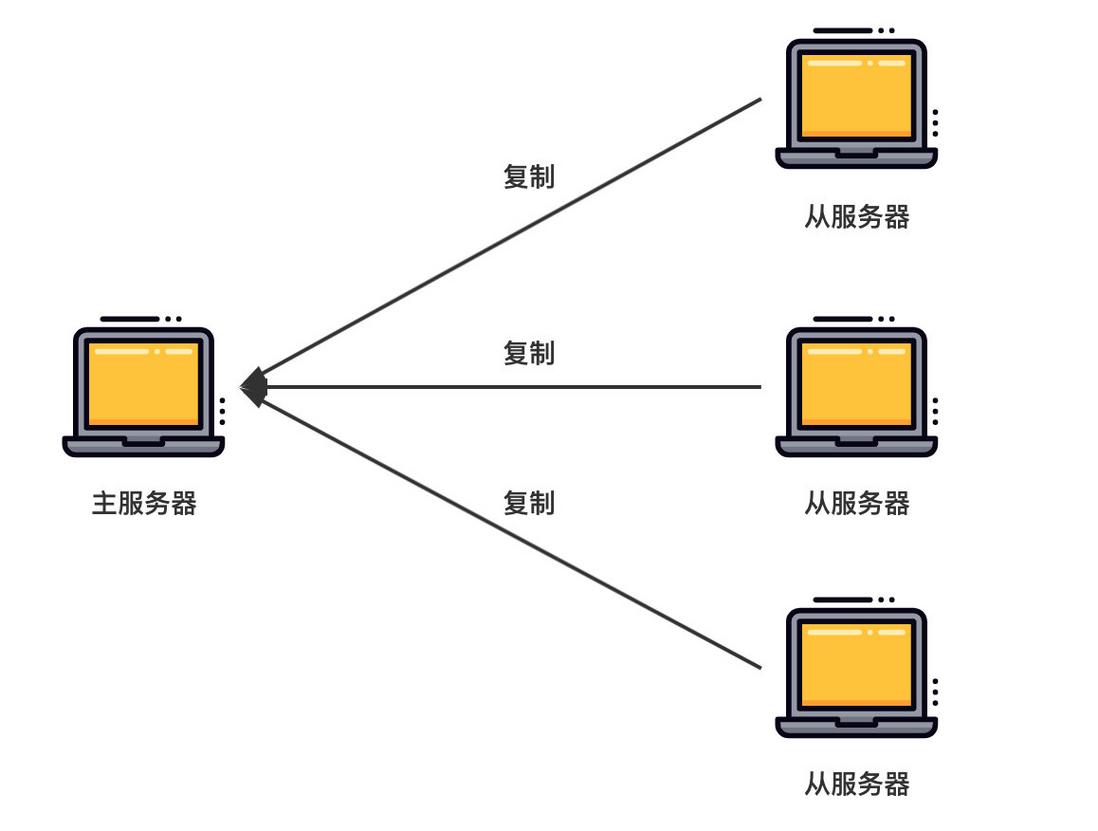
特性七:主从复制
主从复制是 Redis 保证高可用的基础
Redis 提供了复制功能,实现了多个相同数据的 Redis 副本。
特性八:高可用、分布式
Redis 从 2.8 版本正式提供了高可用实现 Redis Sentinel,它能够保证 Redis 节点的故障发现和故障自动转移。
Redis 从 3.0 版本正式提供了分布式实现 Redis Cluster,它是 Redis 真正的分布式实现,提供了高可用、读写和容量的扩展性。
Redis 典型应用场景
- 缓存系统
- 计数器
- 消息队列
- 排行榜
- 社交网络,例如:粉丝数、关注数、共同关注、时间轴列表
- 实时系统,Redis 使用 Bitmap 位图来实现布隆过滤功能,例如:垃圾邮件过滤实时处理
安装 Redis(Linux)
wget http://download.redis.io/releases/redis-3.0.7.tar.gz

tar -xzf redis-3.0.7.tar.gz

ln -s redis-3.0.7 redis

cd redis

make && make install
Redis 可执行文件说明
进入 src 目录下:
- redis-server :Redis 服务器
- redis-cli :Redis 命令行客户端
- redis-benchmark :Redis 基准测试工具
- redis-check-aof :AOF 文件修复工具
- redis-check-dump:RDB 文件检查工具
- redis-sentinel :Sentinel 服务器
三种启动方式
- 最简启动:可以直接使用
redis-server命令以默认参数进行启动。 - 动态启动:
redis-server –port 6380 - 配置文件启动:
redis-server configPath
验证:
ps -ef | grep redis:(检查 redis 进程是否启动)netstat -antpl | grep redis:(检查 redis 服务端口是否存在)redis-cli -h ip -p port ping:(检查 redis 客户端到 redis 服务端连通性)
三种启动方式比较
生产环境选择配置启动。
单机多实例配置文件可以用端口区分。
启动 Redis
使用下面命令进行启动:
redis-server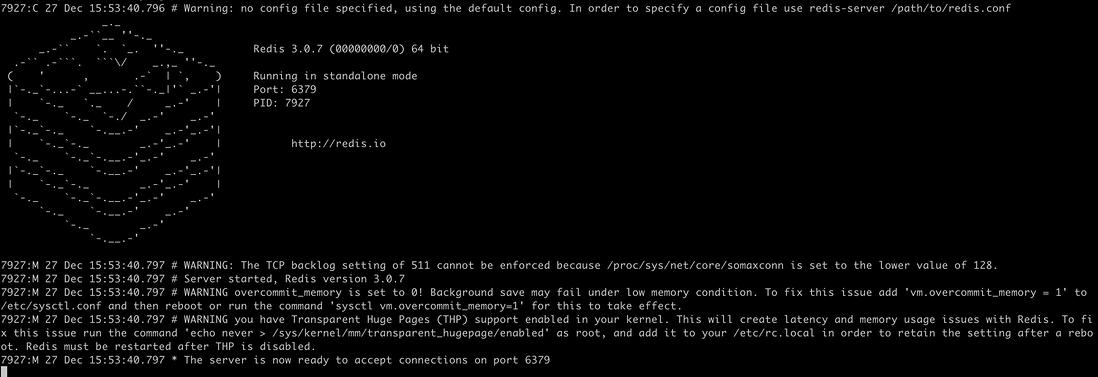
连接 Redis
redis-cli -h 127.0.0.1 -p 6379连接成功后我们就可以做一些操作。
127.0.0.1:6379> set hello world
OK
127.0.0.1:6379> get hello
"world"
127.0.0.1:6379> ping
PONG
127.0.0.1:6379>exit
Redis API 使用和理解
通用命令
KEYS
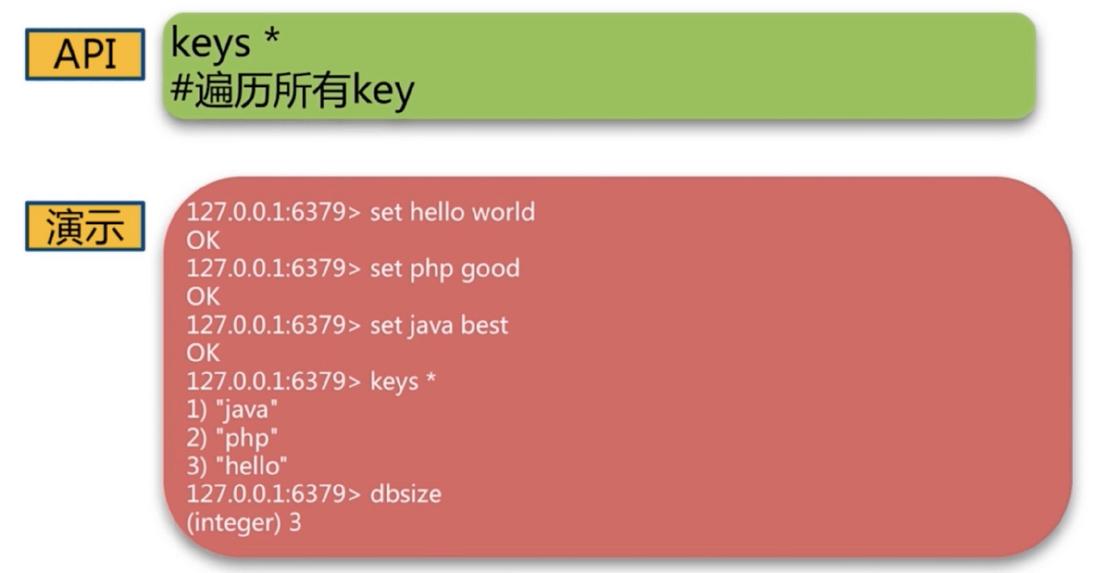
KEYS [pattern]
查找所有符合给定模式 pattern 的 key , 比如说:
KEYS *匹配数据库中所有key。KEYS h?llo匹配hello,hallo和hxllo等。KEYS h*llo匹配hllo和heeeeello等。KEYS h[ae]llo匹配hello和hallo,但不匹配hillo。
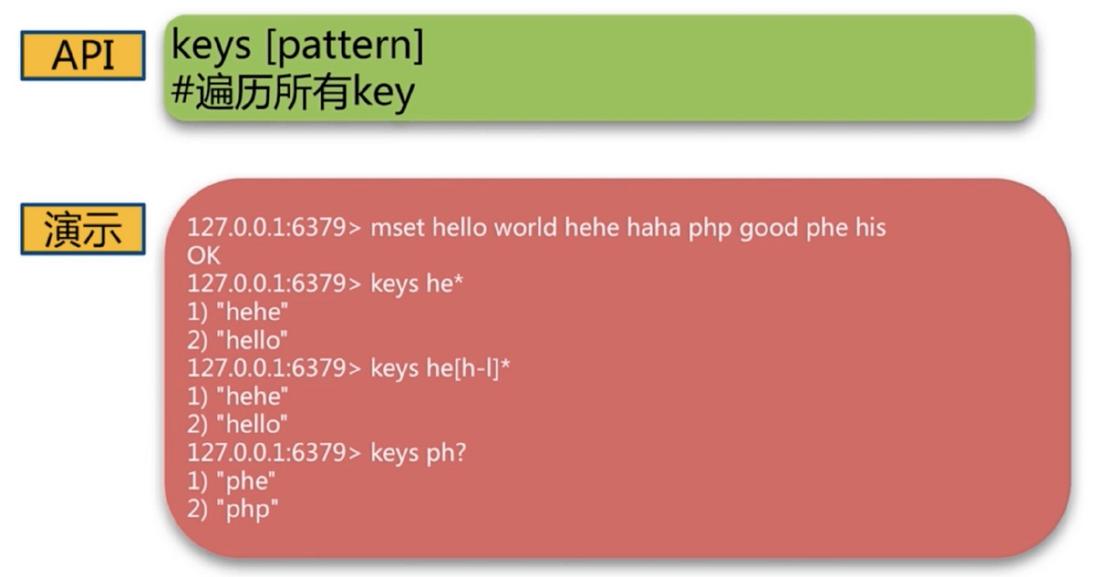
keys 是 O(n)复杂度所以一般不在生产环境使用,因为 Redis 是单线程架构,使用不当会导致 Redis 阻塞。
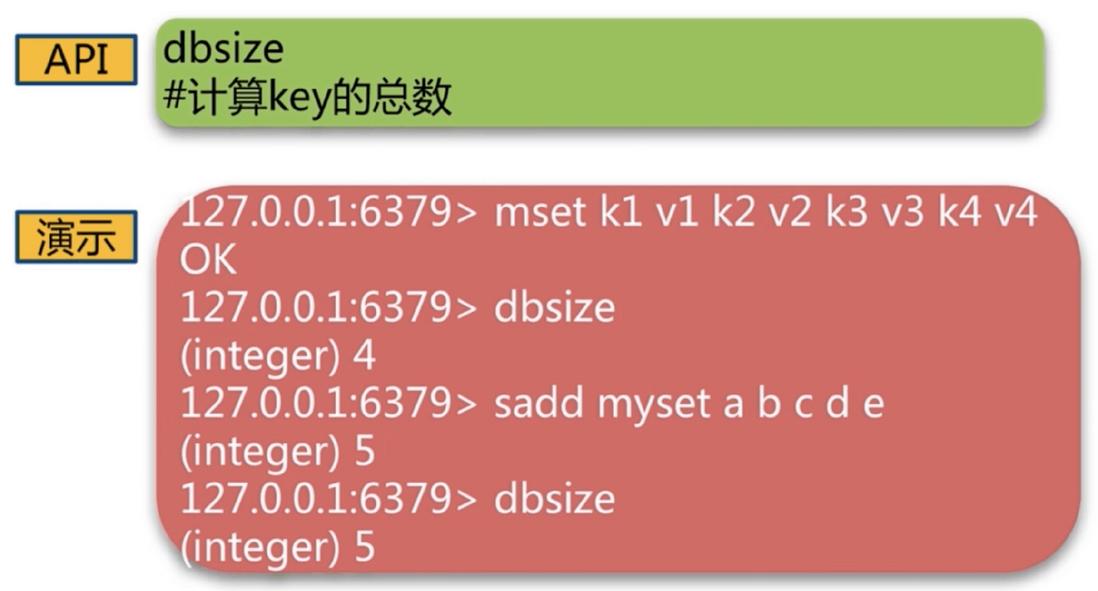
DBSIZE
返回当前数据库的 key 的数量。在 Redis 内部有一个计数器来维护 Key 的数量,所以它的复杂度是 O(1)。
EXISTS
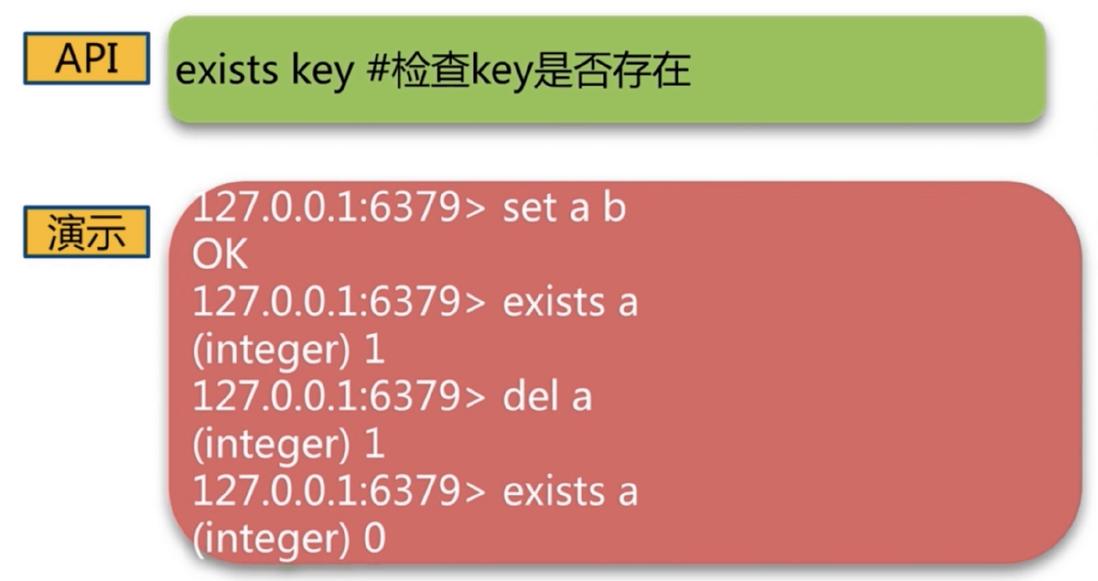
检查给定 key 是否存在。
若 key 存在,返回 1 ,否则返回 0 。
DEL
删除给定的一个或多个 key 。
返回被删除 key 的数量。

EXPIRE
为给定 key 设置生存时间,当 key 过期时(生存时间为 0 ),它会被自动删除。
设置成功返回 1 。 当 key 不存在或者不能为 key 设置生存时间时,返回 0 。

TTL
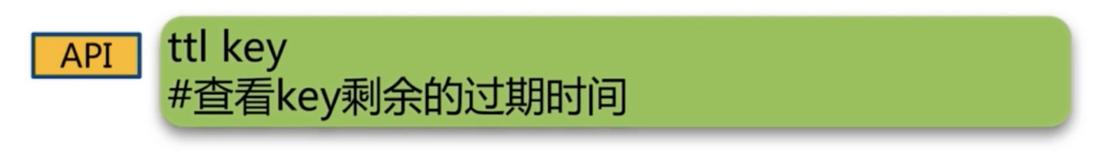
以秒为单位,返回给定 key 的剩余生存时间(TTL, time to live)。
当 key 不存在时,返回 -2 。 当 key 存在但没有设置剩余生存时间时,返回 -1 。 否则,以秒为单位,返回 key 的剩余生存时间。
PERSIST
移除给定 key 的生存时间,并变为永不过期的key。
当生存时间移除成功时,返回 1 . 如果 key 不存在或 key 没有设置生存时间,返回 0 。
TYPE
返回 key 所储存的值的类型。
返回值
none(key 不存在)string(字符串)list(列表)set(集合)zset(有序集)hash(哈希表)stream(流)

数据结构和内部编码
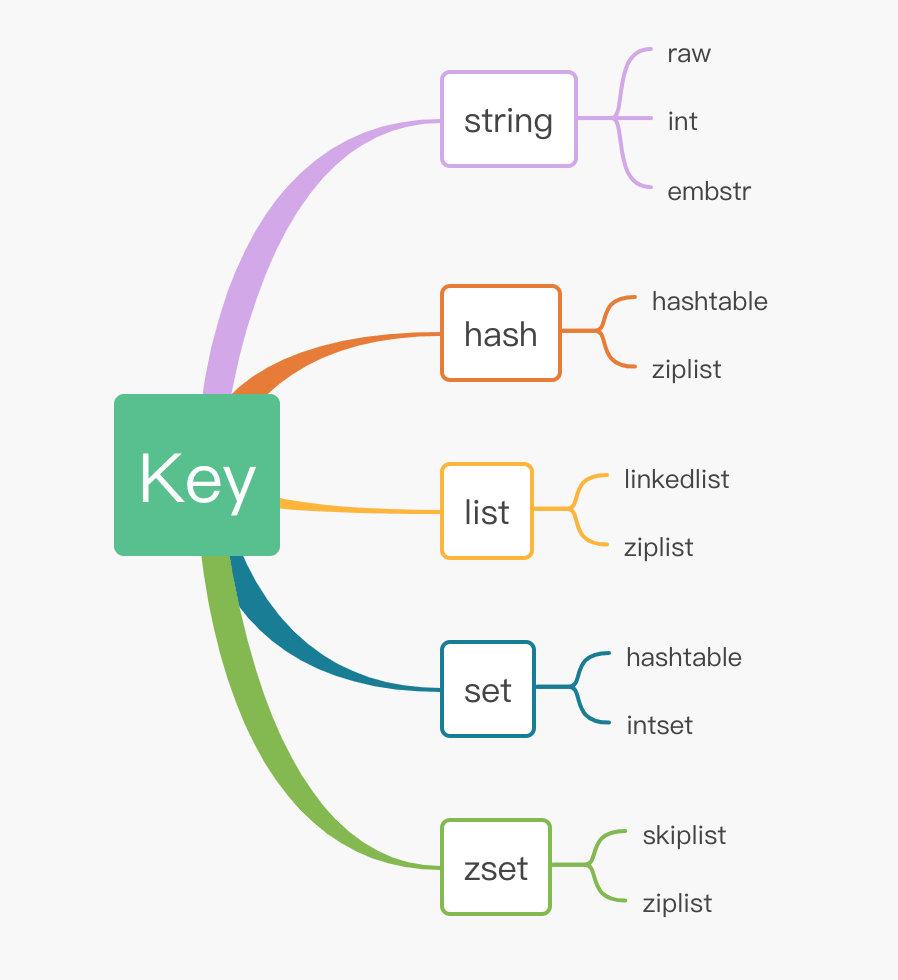
redis 对外展现五种数据类型:
- string
- hash
- set
- zset
- list
每种数据结构,redis 都提供了不同的内部编码实现方式(内部编码可以通过object encoding key查看),以便使用不同的场景。
127.0.0.1:6379> object encoding hello
"embstr"
string
- raw:大于 39 个字节的字符串,用简单动态字符串(SDS)来保存,将这个字符串的对象编码设置为 raw。
- int:8 个字节的长整型,如果一个字符串保存的类型是整数值,并且这个值可以用 long 类型来表示,name 字符串对象会将整数值保存在字符串对象结构的 ptr 属性里面,并将字符串对象的编码设置为 int。
- embstr:小于等于 39 个字节的字符串,embstr 编码是专门用于保存短字符串的优化编码方式。
embstr 相较于 raw 有以下好处:
- embstr 编码将创建字符串对象所需的空间分配的次数从 raw 编码的两次降低为一次。
- 释放 embstr 编码的字符串对象只需要调用一次内存释放函数,而释放 raw 编码对象的字符串对象需要调用两次内存释放函数
- 因为 embstr 编码的字符串对象的所有数据都保存在一块连续的内存里面,所以这种编码的字符串对象比起 raw 编码的字符串对象能更好地利用缓存带来的优势。
hash
- ziplist(压缩列表):当哈希类型元素小于
has-max-ziplist-entries配置(默认 512 个),同时所有值都小于hash-max-ziplist-value配置(默认 64 个字节)时,redis 会使用 ziplist 作为哈希的内部实现。ziplist 使用更加紧凑的结构实现多个元素的连续存储,所以在节省内存方面比 hashtable 更加优秀。 - hashtable(哈希表):当哈希类型无法满足 ziplist 的条件时,redis 会使用 hashtable 作为哈希的内部实现。因为 ziplist 的读写效率会下降,而 hashtable 的读写时间复杂度为 O(1)。
list
- ziplist(压缩列表):当列表类型元素个数小于 hash-max-ziplist-entries 配置(默认 512 个)同时所有值都小于 hash-max-ziplist-value 配置(默认 64 个字节)时,Redis 会使用 ziplist 作为列表的内部实现。
- linkedlist(链表):当列表类型无法满足条件的时候,redis 会使用 linkedlist 作为列表的内部实现。
set
- intset(整数集合):当集合中的元素都是整数且元素个数小于
set-max-intset-entries配置(默认 512 个)是,redis 会选 intset 作为集合的内部实现,从而减少内存使用。 - hashtable(哈希表):当集合元素无法满足 intset 的条件时,redis 会使用 hashtable 作为集合的内部实现。
zset
- ziplist:当有序集合的元素个数小于
zset-max-ziplist-entries配置(默认 128 个)同时每个元素的值小于zset-max-ziplist-value配置(默认 64 个字节)时,Redis 会用 ziplist 来作为有序集合的内部实现,ziplist 可以有效减少内存使用。 - skiplist(跳跃表):当 ziplist 条件不满足的时候,有序集合会使用 skiplist 作为内部 实现,因为 ziplist 的读写效率会下降
字符串类型
特点
- key 是唯一的,不能重复。
- value 数据类型可以是多种,比如:字符串、数字、二进制,只是内部把数字、二进制数据转化为字符串。
- value 也可以是一个 JSON 字符串。
- value 还可以是序列化对象。
- value 可以存储最大的数据大小为:512MB。
常用的字符串场景
- 缓存
- 计数器
- 分布式锁
GET
返回与键 key 相关联的字符串值。
如果键 key 不存在, 那么返回特殊值 nil ; 否则, 返回键 key 的值。
如果键 key 的值并非字符串类型, 那么返回一个错误, 因为 GET 命令只能用于字符串值。
SET
将字符串值 value 关联到 key 。
如果 key 已经持有其他值, SET 就覆写旧值, 无视类型。
当 SET 命令对一个带有生存时间(TTL)的键进行设置之后, 该键原有的 TTL 将被清除。
DEL
删除给定的一个或多个 key 。
返回被删除 key 的数量。
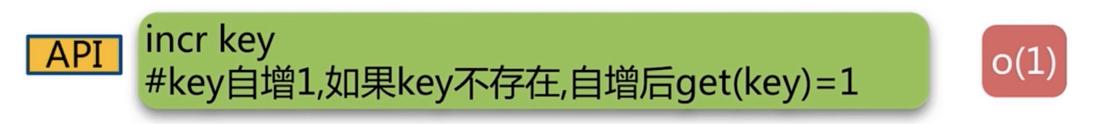
INCR
为键 key 储存的数字值加上一。
如果键 key 不存在, 那么它的值会先被初始化为 0 , 然后再执行 INCR 命令。
如果键 key 储存的值不能被解释为数字, 那么 INCR 命令将返回一个错误。
本操作的值限制在 64 位(bit)有符号数字表示之内。
INCR 命令会返回键 key 在执行加一操作之后的值。
DECR
为键 key 储存的数字值减去一。
如果键 key 不存在, 那么键 key 的值会先被初始化为 0 , 然后再执行 DECR 操作。
如果键 key 储存的值不能被解释为数字, 那么 DECR 命令将返回一个错误。
本操作的值限制在 64 位(bit)有符号数字表示之内。
DECR 命令会返回键 key 在执行减一操作之后的值。

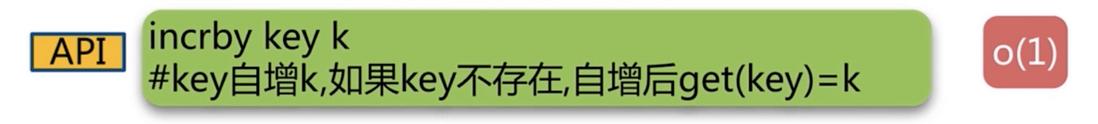
INCRBY
为键 key 储存的数字值加上增量 increment 。
如果键 key 不存在, 那么键 key 的值会先被初始化为 0 , 然后再执行 INCRBY 命令。
如果键 key 储存的值不能被解释为数字, 那么 INCRBY 命令将返回一个错误。
本操作的值限制在 64 位(bit)有符号数字表示之内。
在加上增量 increment 之后, 返回键 key 当前的值。
DECRBY
将键 key 储存的整数值减去减量 decrement 。
如果键 key 不存在, 那么键 key 的值会先被初始化为 0 , 然后再执行 DECRBY 命令。
如果键 key 储存的值不能被解释为数字, 那么 DECRBY 命令将返回一个错误。
本操作的值限制在 64 位(bit)有符号数字表示之内。
DECRBY 命令会返回键在执行减法操作之后的值。

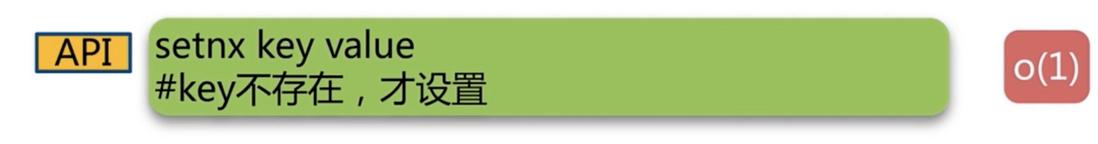
SETNX
只在键 key 不存在的情况下, 将键 key 的值设置为 value 。
若键 key 已经存在, 则 SETNX 命令不做任何动作。
SETNX 是『SET if Not eXists』(如果不存在,则 SET)的简写。
命令在设置成功时返回 1 , 设置失败时返回 0 。
SETEX
将键 key 的值设置为 value , 并将键 key 的生存时间设置为 seconds 秒钟。
如果键 key 已经存在, 那么 SETEX 命令将覆盖已有的值。
SETEX 命令的效果和以下两个命令的效果类似:
SET key value
EXPIRE key seconds  # 设置生存时间
SETEX 和这两个命令的不同之处在于 SETEX 是一个原子性(atomic)操作, 它可以在同一时间内完成设置值和设置过期时间这两个操作, 因此 SETEX 命令在储存缓存的时候非常实用。
命令在设置成功时返回 OK 。 当 seconds 参数不合法时, 命令将返回一个错误。
API:SETEX key seconds value
127.0.0.1:6379> setex jack 60 nihao
OK
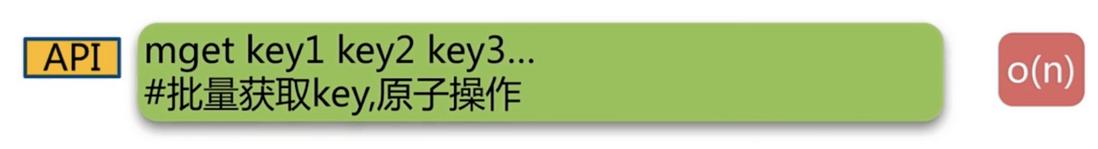
MGET
返回给定的一个或多个字符串键的值。
如果给定的字符串键里面, 有某个键不存在, 那么这个键的值将以特殊值 nil 表示。
MGET 命令将返回一个列表, 列表中包含了所有给定键的值。
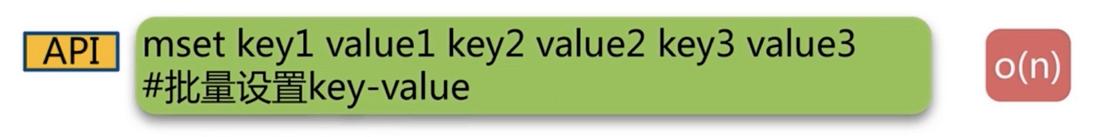
MSET
同时为多个键设置值。
如果某个给定键已经存在, 那么 MSET 将使用新值去覆盖旧值。
MSET 是一个原子性(atomic)操作, 所有给定键都会在同一时间内被设置, 不会出现某些键被设置了但是另一些键没有被设置的情况。
MSET 命令总是返回 OK 。
MSETNX
当且仅当所有给定键都不存在时, 为所有给定键设置值。
即使只有一个给定键已经存在, MSETNX 命令也会拒绝执行对所有键的设置操作。
MSETNX 是一个原子性(atomic)操作, 所有给定键要么就全部都被设置, 要么就全部都不设置, 不可能出现第三种状态。
当所有给定键都设置成功时, 命令返回 1 ; 如果因为某个给定键已经存在而导致设置未能成功执行, 那么命令返回 0 。
API:MSETNX key value [key value …]
127.0.0.1:6379> msetnx jack1 h jack2 e jack3 l  #对不存在的key设置value
(integer) 1
127.0.0.1:6379> msetnx jack1 h jack2 e jack3 l #对存在的key设置value
(integer) 0
127.0.0.1:6379> mget jack1 jack2 jack3  #批量获取key
1) "h"
2) "e"
3) "l"
127.0.0.1:6379>
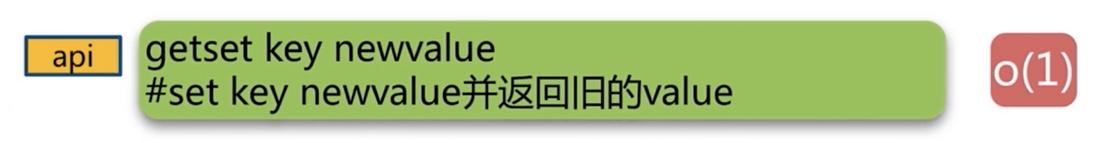
GETSET
将键 key 的值设为 value , 并返回键 key 在被设置之前的旧值。
如果键 key 没有旧值, 也即是说, 键 key 在被设置之前并不存在, 那么命令返回 nil 。
当键 key 存在但不是字符串类型时, 命令返回一个错误。
APPEND
如果键 key 已经存在并且它的值是一个字符串, APPEND 命令将把 value 追加到键 key 现有值的末尾。
如果 key 不存在, APPEND 就简单地将键 key 的值设为 value , 就像执行 SET key value 一样。
追加 value 之后, 返回键 key 的值的长度。

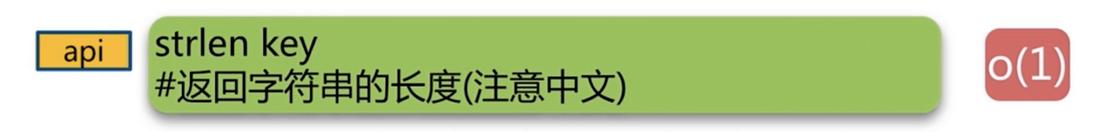
STRLEN
返回键 key 储存的字符串值的长度。
STRLEN 命令返回字符串值的长度。
当键 key 不存在时, 命令返回 0 。
当 key 储存的不是字符串值时, 返回一个错误。
INCRBYFLOAT
为键 key 储存的值加上浮点数增量 increment 。
如果键 key 不存在, 那么 INCRBYFLOAT 会先将键 key 的值设为 0 , 然后再执行加法操作。
如果命令执行成功, 那么键 key 的值会被更新为执行加法计算之后的新值, 并且新值会以字符串的形式返回给调用者。
当以下任意一个条件发生时, 命令返回一个错误:
- 键
key的值不是字符串类型(因为 Redis 中的数字和浮点数都以字符串的形式保存,所以它们都属于字符串类型); - 键
key当前的值或者给定的增量increment不能被解释(parse)为双精度浮点数。
在加上增量 increment 之后, 返回键 key 的值。

GETRANGE
返回键 key 储存的字符串值的指定部分, 字符串的截取范围由 start 和 end 两个偏移量决定 (包括 start 和 end 在内)。
负数偏移量表示从字符串的末尾开始计数, -1 表示最后一个字符, -2 表示倒数第二个字符, 以此类推。
GETRANGE 命令会返回字符串值的指定部分。

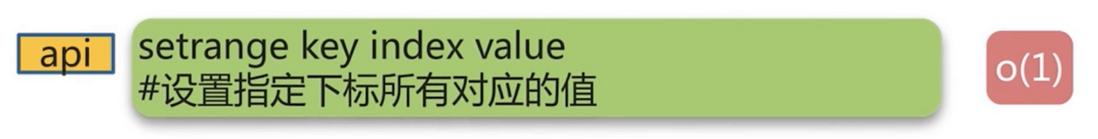
SETRANGE
从偏移量 offset 开始, 用 value 参数覆写键 key 储存的字符串值。
SETRANGE 命令会返回被修改之后, 字符串值的长度。
Hash 类型
- 哈希类型也是 key-value 结构,key 是字符串类型,其 value 分为两个部分:field 和 value。
- 其中 field 部分代表属性,value 代表属性对应的值。
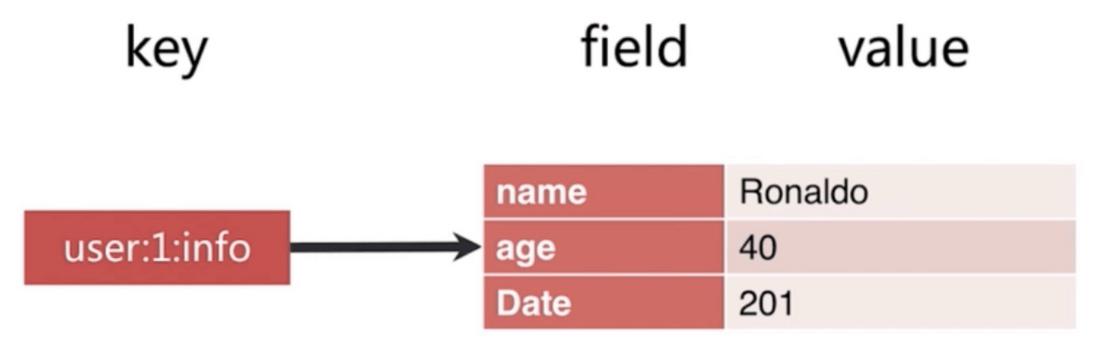
例如上图中,user:1:info为 key,name,age,Date为 user 这个 key 的一些属性,value 是属性对应的值。
在 hash 中,可以为 key 添加一个新的属性和新的值。
比如使用下面的命令向user:1:info这个 key 添加一个新属性 viewCounter,属性对应的值为 100。
hset user:1:info viewCounter 100
特点:
- 适合存储对象,并且可以像数据库中 update 一个属性一样只修改某一项属性值。
- field 不能相同,value 可以相同。
适用场景:
hash 变更的数据 user name age,尤其是是用户信息之类的,经常变动的信息。hash 更适合于对象的 存储,String 更加适合字符串存储!
HGET
HGET 命令在默认情况下返回给定域的值。
如果给定域不存在于哈希表中, 又或者给定的哈希表并不存在, 那么命令返回 nil 。

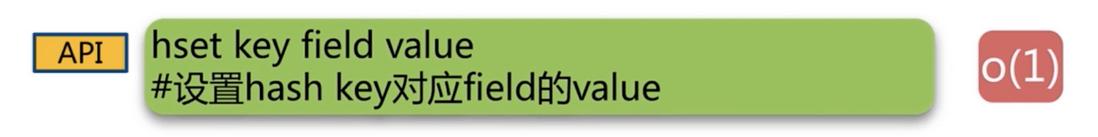
HSET
将哈希表 hash 中域 field 的值设置为 value 。
如果给定的哈希表并不存在, 那么一个新的哈希表将被创建并执行 HSET 操作。
如果域 field 已经存在于哈希表中, 那么它的旧值将被新值 value 覆盖。
当 HSET 命令在哈希表中新创建 field 域并成功为它设置值时, 命令返回 1 ; 如果域 field 已经存在于哈希表, 并且 HSET 命令成功使用新值覆盖了它的旧值, 那么命令返回 0 。
HSETNX
当且仅当域 field 尚未存在于哈希表的情况下, 将它的值设置为 value 。
如果给定field已经存在于哈希表当中, 那么命令将放弃执行设置操作。
如果哈希表 hash 不存在, 那么一个新的哈希表将被创建并执行 HSETNX 命令。
HSETNX 命令在设置成功时返回 1 , 在给定域已经存在而放弃执行设置操作时返回 0 。

HDEL
删除哈希表 key 中的一个或多个指定域,不存在的域将被忽略。
返回被成功移除的域的数量,不包括被忽略的域。

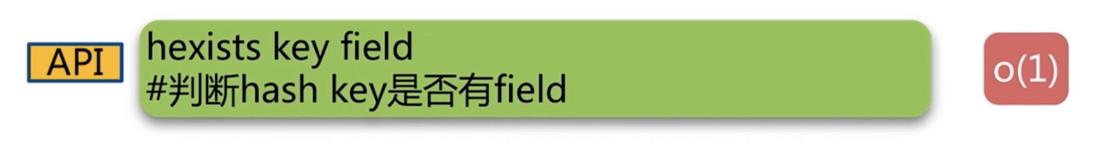
HEXISTS
检查给定域 field 是否存在于哈希表 hash 当中。
HEXISTS 命令在给定域存在时返回 1 , 在给定域不存在时返回 0 。
HLEN
返回哈希表 key 中field的数量。
返回哈希表中field的数量。当 key 不存在时,返回 0 。

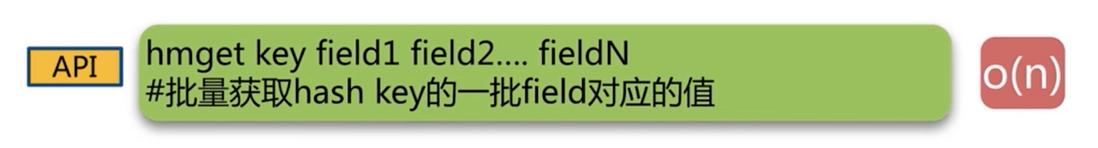
HMGET
返回哈希表 key 中,一个或多个给定域的值。
如果给定的域不存在于哈希表,那么返回一个 nil 值。
因为不存在的 key 被当作一个空哈希表来处理,所以对一个不存在的 key 进行 HMGET 操作将返回一个只带有 nil 值的表。
HMSET
同时将多个 field-value (域-值)对设置到哈希表 key 中。
此命令会覆盖哈希表中已存在的域。
如果 key 不存在,一个空哈希表被创建并执行 HMSET 操作。
如果命令执行成功,返回 OK 。
当 key 不是哈希表(hash)类型时,返回一个错误。

HGETALL
返回哈希表 key 中,所有的域和值。
在返回值里,紧跟每个域(field)之后是域的值(value),所以返回值的长度是哈希表大小的两倍。
HVALS
返回哈希表 key 中所有field的值。
当 key 不存在时,返回一个空表。
HKEYS
返回哈希表 key 中的所有field。
当 key 不存在时,返回一个空表。
HINCRBY
为哈希表 key 中的域 field 的值加上增量 increment 。
增量也可以为负数,相当于对给定域进行减法操作。
如果 key 不存在,一个新的哈希表被创建并执行 HINCRBY 命令。
如果域 field 不存在,那么在执行命令前,域的值被初始化为 0 。
对一个储存字符串值的域 field 执行 HINCRBY 命令将造成一个错误。
本操作的值被限制在 64 位(bit)有符号数字表示之内。
最终返回哈希表 key 中域 field 的新值。
List 类型
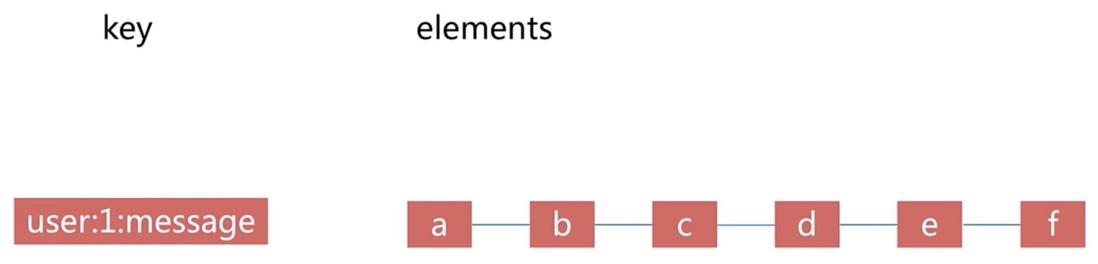
特点:
- 链表(双向链表)可演化成栈,队列,在两边插入或者改动值,效率高。
- 有序。
- 可以重复。
- 左右两边插入弹出。
适用场景:
- 最新消息排行等功能(比如朋友圈的时间线)。
- 消息队列。
RPUSH
将一个或多个值 value 插入到列表 key 的表尾(最右边)。
如果有多个 value 值,那么各个 value 值按从左到右的顺序依次插入到表尾。
如果 key 不存在,一个空列表会被创建并执行 RPUSH 操作。
当 key 存在但不是列表类型时,返回一个错误。
执行 RPUSH 操作后,返回列表的长度。
LPUSH
将一个或多个值 value 插入到列表 key 的表头
如果有多个 value 值,那么各个 value 值按从左到右的顺序依次插入到表头。
如果 key 不存在,一个空列表会被创建并执行 LPUSH 操作。
当 key 存在但不是列表类型时,返回一个错误。
执行 LPUSH 操作后,返回列表的长度。
LINSERT
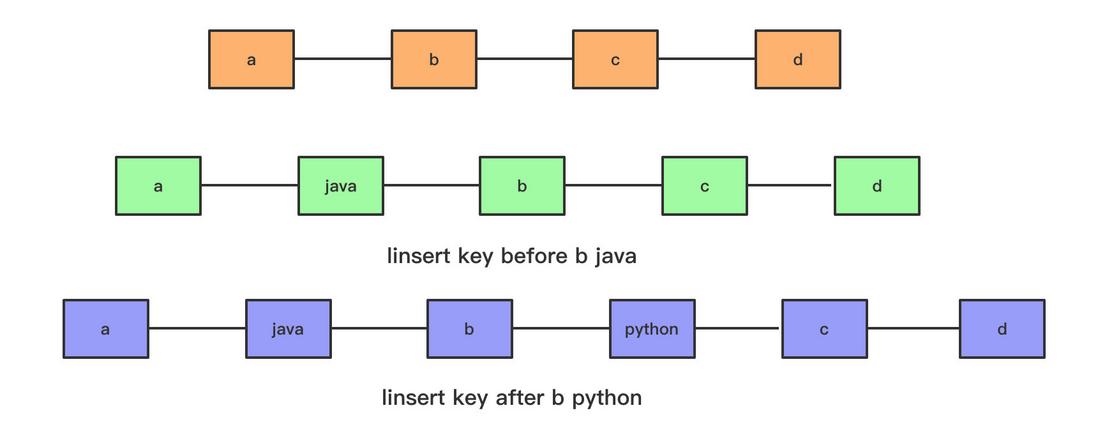
将值 value 插入到列表 key 当中,位于值 pivot 之前或之后。
当 pivot 不存在于列表 key 时,不执行任何操作。
当 key 不存在时, key 被视为空列表,不执行任何操作。
如果 key 不是列表类型,返回一个错误。
如果命令执行成功,返回插入操作完成之后,列表的长度。
如果没有找到 pivot ,返回 -1 。 如果 key 不存在或为空列表,返回 0 。

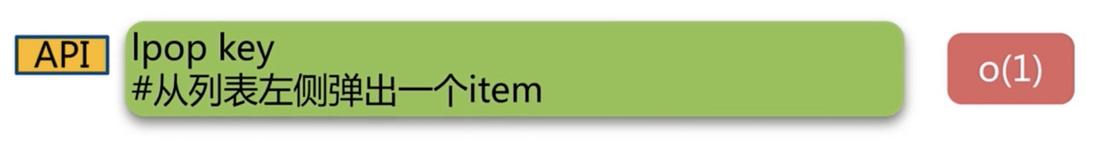
LPOP
移除并返回列表 key 的头元素。
执行成功返回列表的头元素。 当 key 不存在时,返回 nil 。
RPOP
移除并返回列表 key 的尾元素。
执行成功返回列表的尾元素。 当 key 不存在时,返回 nil 。

LREM
根据参数 count 的值,移除列表中与参数 value 相等的元素。
count 的值可以是以下几种:
count > 0: 从表头开始向表尾搜索,移除与value相等的元素,数量为count。count < 0: 从表尾开始向表头搜索,移除与value相等的元素,数量为count。count = 0: 移除表中所有与value相等的值。
返回被移除元素的数量。 因为不存在的 key 被视作空表(empty list),所以当 key 不存在时,返回 0 。

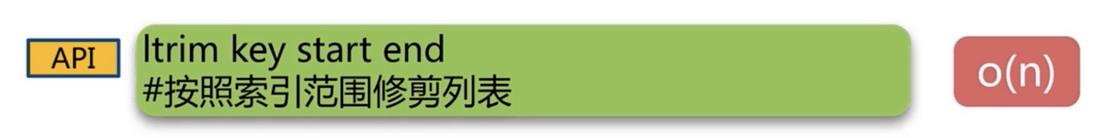
LTRIM
对一个列表进行修剪,也就是说,让列表只保留指定区间内的元素,不在指定区间之内的元素都将被删除。
当 key 不是列表类型时,返回一个错误。
需要注意的是:
- 如果
stop下标比end下标还要大,Redis 将stop的值设置为end。 - 下标从 0 开始。
命令执行成功时,返回 ok 。
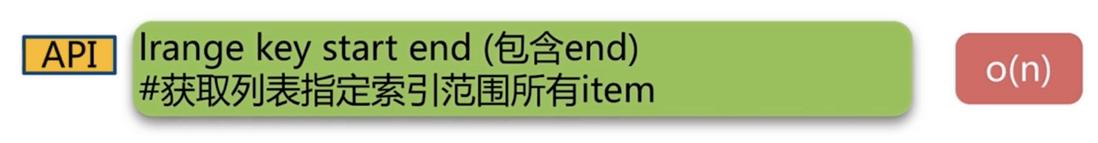
LRANGE
返回列表 key 中指定区间内的元素,区间以偏移量 start 和 stop 指定。
需要注意的是:
- 如果
stop下标比end下标还要大,Redis 将stop的值设置为end。 - 下标从 0 开始。
- 包含
start和stop。
命令执行成功时,返回指定区间内的元素。
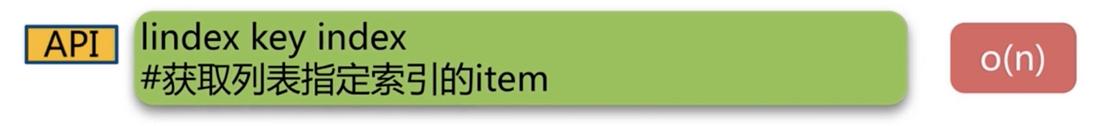
LINDEX
返回列表 key 中,下标为 index 的元素。
以 0 表示列表的第一个元素,以 1 表示列表的第二个元素,以此类推。
也可以使用负数下标,以 -1 表示列表的最后一个元素, -2 表示列表的倒数第二个元素,以此类推。
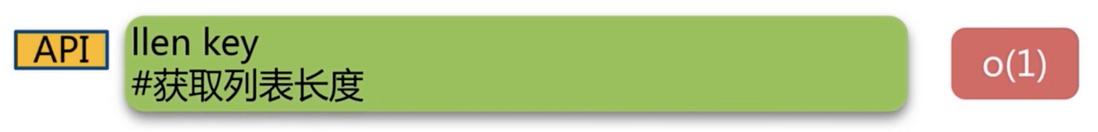
LLEN
返回列表 key 的长度。
如果 key 不存在,则 key 被解释为一个空列表,返回 0 .
如果 key 不是列表类型,返回一个错误。
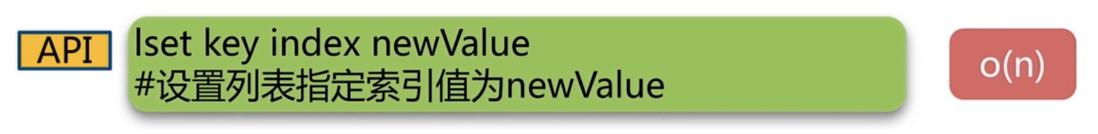
LSET
将列表 key 下标为 index 的元素的值设置为 value 。
当 index 参数超出范围,或对一个空列表( key 不存在)进行 LSET 时,返回一个错误。
操作成功返回 ok ,否则返回错误。
BLPOP
BLPOP 是列表的阻塞式(blocking)弹出。
当给定列表内没有任何元素可供弹出的时候,连接将被阻塞,直到等待超时或发现可弹出元素为止。
当存在多个给定 key 时,按给定 key 参数排列的先后顺序,依次检查各个列表。
超时参数 timeout 接受一个以秒为单位的数字作为值。超时参数设为 0 表示阻塞时间可以无限期延长(block indefinitely) 。
API:BLPOP key [key …] timeout
127.0.0.1:6379> blpop list1 list2 0  # 无限期阻塞
1) "list1"                           # 用另一个连接 lpush list1 a
2) "a"                                                   # 被弹出的值
(30.31s)
BLPOP 保证返回的元素来自第一个非空的列表 ,因为它是按”查找 list1 -> 查找 list2 这样的顺序,第一个找到的非空列表。
如果列表为空,返回一个 nil 。 否则,返回一个含有两个元素的列表,第一个元素是被弹出元素所属的 key ,第二个元素是被弹出元素的值。
BRPOP 和 BLPOP 命令正好相反,就不演示了。
List 的小技巧
- LPUSH + LPOP = Stack
- LPUSH + RPOP = Queue
- LPUSH +BRPOP = Message Queue
Set 类型
左边为 key 是字符串类型,右边为 values,可以将一些字符串进行一些组合,可以向 value 中添加或者删除一个元素。
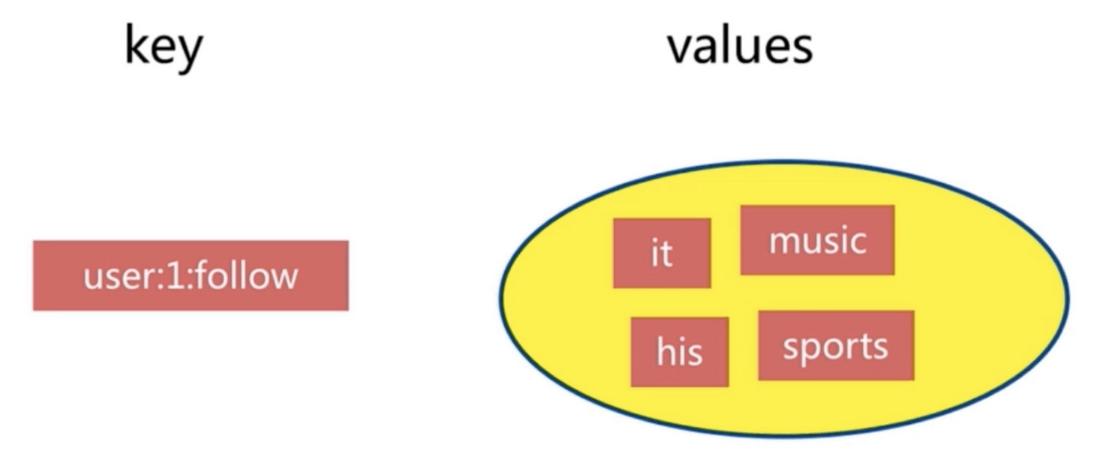
特点:
- 哈希表实现,元素不重复。
- 添加、删除,查找的复杂度都是 O(1)。
- 为集合提供了求交集、并集、差集等操作。
- 无序。
适用场景:
- 共同好友。
- 利用唯一性,统计访问网站的所有独立 ip。
- 好友推荐时,根据 tag 求交集,大于某个阈值就可以推荐。
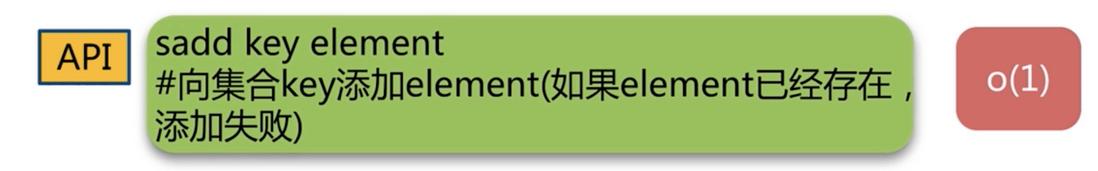
SADD
将一个或多个 member 元素加入到集合 key 当中,已经存在于集合的 member 元素将被忽略。
假如 key 不存在,则创建一个只包含 member 元素作成员的集合。
当 key 不是集合类型时,返回一个错误。
返回被添加到集合中的新元素的数量,不包括被忽略的元素。
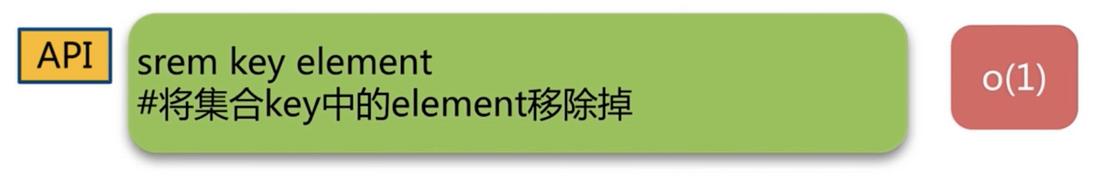
SREM
移除集合 key 中的一个或多个 member 元素,不存在的 member 元素会被忽略。
当 key 不是集合类型,返回一个错误。
返回被成功移除的元素的数量,不包括被忽略的元素。
SCARD
返回集合 key 的基数(集合中元素的数量)。
集合的基数。 当 key 不存在时,返回 0 。
API:SCARD key
127.0.0.1:6379> sadd myset a b c d e f
(integer) 6
127.0.0.1:6379> scard myset
(integer) 6
SISMEMBER
判断 member 元素是否集合 key 的成员。
如果 member 元素是集合的成员,返回 1 。 如果 member 元素不是集合的成员,或 key 不存在,返回 0 。
API:SISMEMBER key member
127.0.0.1:6379> sismember myset a  #存在
(integer) 1
127.0.0.1:6379> sismember myset z #不存在
(integer) 0
SRANDMEMBER
如果命令执行时,只提供了 key 参数,那么返回集合中的一个随机元素。
从 Redis 2.6 版本开始, 接受可选的 count 参数:
- 如果
count为正数,且小于集合基数,那么命令返回一个包含count个元素的数组,数组中的元素各不相同。如果count大于等于集合基数,那么返回整个集合。 - 如果
count为负数,那么命令返回一个数组,数组中的元素可能会重复出现多次,而数组的长度为count的绝对值。
只提供 key 参数时,返回一个元素;如果集合为空,返回 nil 。 如果提供了 count 参数,那么返回一个数组;如果集合为空,返回空数组。
API:SRANDMEMBER key [count]
127.0.0.1:6379> srandmember myset #不填count 随机返回一个
"b"
127.0.0.1:6379> srandmember myset 2 # count为正数
1) "e"
2) "f"
127.0.0.1:6379> srandmember myset -2 # count为负数
1) "e"
2) "a"
127.0.0.1:6379> srandmember myset -2 # count为负数
1) "f"
2) "f"
SMEMBERS
返回集合 key 中的所有成员。
不存在的 key 被视为空集合。
API:SMEMBERS key
127.0.0.1:6379> smembers myset
1) "a"
2) "e"
3) "d"
4) "f"
5) "c"
6) "b"
SPOP
移除并返回集合中的一个随机元素。
返回被移除的随机元素。 当 key 不存在或 key 是空集时,返回 nil 。
API:SPOP key
127.0.0.1:6379> spop myset
"d"
SINTER
返回一个集合的全部成员,该集合是所有给定集合的交集。
不存在的 key 被视为空集。
当给定集合当中有一个空集时,结果也为空集(根据集合运算定律)。
API:SINTER key [key …]
127.0.0.1:6379> smembers set1
1) "a"
2) "c"
3) "d"
4) "b"
5) "e"
127.0.0.1:6379> smembers set2
1) "d"
2) "b"
3) "e"
127.0.0.1:6379> sinter set1 set2  #获取两遍都存在的数据
1) "d"
2) "b"
3) "e"
SUNION
返回一个集合的全部成员,该集合是所有给定集合的并集。
不存在的 key 被视为空集。
API:SUNION key [key …]
127.0.0.1:6379> sunion set1 set2 #获取并集
1) "a"
2) "e"
3) "d"
4) "c"
5) "b"
SDIFF
返回一个集合的全部成员,该集合是所有给定集合之间的差集。
不存在的 key 被视为空集。
API:SDIFF key [key …]
127.0.0.1:6379> sdiff set1 set2 #获取差集
1) "a"
2) "c"
ZSet 类型
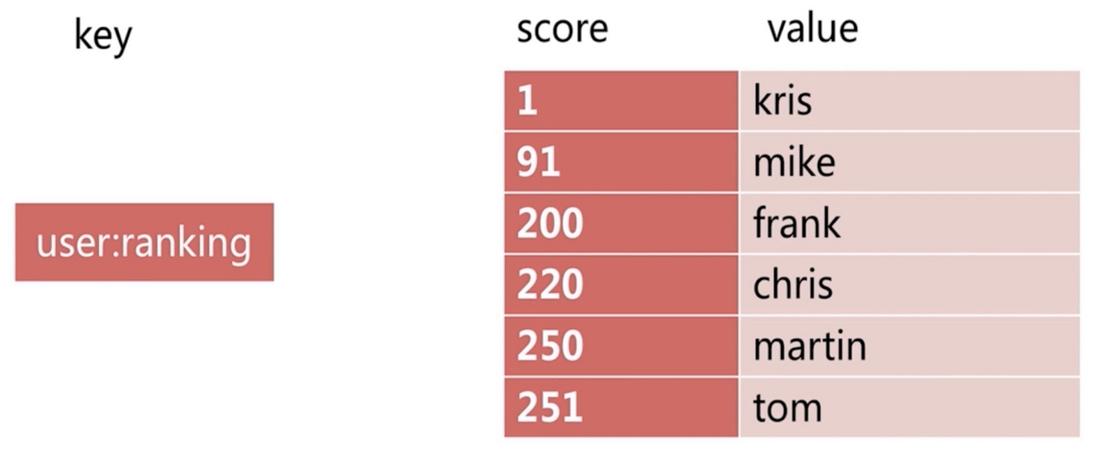
左边为 key,是字符串类型。右边为 value,由两部分组成:score 和 value score 表示分值,表示 value 在有序集合中的位置。
集合与有序集合的区别
- 都没有重复元素。
- 集合无序,有序集合是有序的。
- 集合中只有 member,有序集合中有 member+score。
列表与有序集合的区别
- 列表可以有重复元素,有序集合没有重复元素。
- 列表有序,有序集合有序。
- 列表中只有 member,有序集合中有 member+score。
特点:
将 Set 中的元素增加一个权重参数 score,元素按 score 有序排列,天然排序。
适用场景:
- 1、排行榜。
- 2、带权重的消息队列。
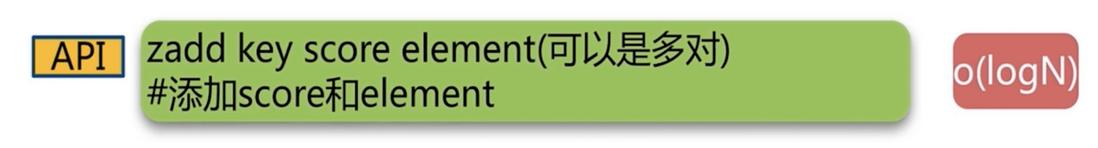
ZADD
将一个或多个 member 元素及其 score 值加入到有序集 key 当中。
如果某个 member 已经是有序集的成员,那么更新这个 member 的 score 值,并通过重新插入这个 member 元素,来保证该 member 在正确的位置上。
score 值可以是整数值或双精度浮点数。
如果 key 不存在,则创建一个空的有序集并执行 ZADD 操作。
当 key 存在但不是有序集类型时,返回一个错误。
返回被成功添加的新成员的数量,不包括那些被更新的、已经存在的成员。
ZREM
移除有序集 key 中的一个或多个成员,不存在的成员将被忽略。
当 key 存在但不是有序集类型时,返回一个错误。
返回被成功移除的成员的数量,不包括被忽略的成员。

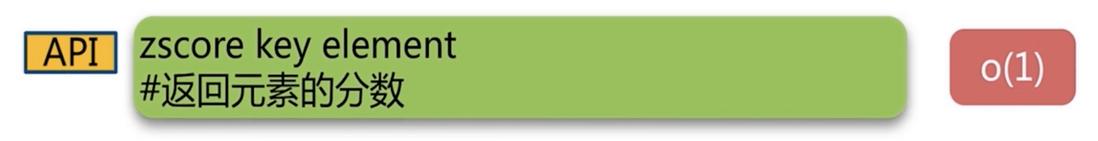
ZSCORE
返回有序集 key 中,成员 member 的 score 值。
如果 member 元素不是有序集 key 的成员,或 key 不存在,返回 nil 。
ZINCRBY
为有序集 key 的成员 member 的 score 值加上增量 increment 。
可以通过传递一个负数值 increment ,让 score 减去相应的值。
当 key 不存在,或 member 不是 key 的成员时, ZINCRBY key increment member 等同于 ZADD key increment member 。
当 key 不是有序集类型时,返回一个错误。
score 值可以是整数值或双精度浮点数。
member 成员的新 score 值,以字符串形式表示。

ZCARD
当 key 存在且是有序集类型时,返回有序集的基数。 当 key 不存在时,返回 0 。

ZRANGE
返回有序集 key 中,指定区间内的成员。
其中成员的位置按 score 值递增(从小到大)来排序。
如果需要从大到小可以使用ZREVRANGE命令。
下标从 0 开始,stop 参数的值比有序集的最大下标还要大,那么 Redis 将 stop 当作最大下标来处理。
可以通过使用 WITHSCORES 选项,来让成员和它的 score 值一并返回。
API:ZRANGE key start stop [WITHSCORES]
127.0.0.1:6379> zadd zset 10 a 20 b 30 c 40 d 50 e
(integer) 5
127.0.0.1:6379> zrange zset  0 2
1) "a"
2) "b"
3) "c"
127.0.0.1:6379> zrange zset  0 2 withscores
1) "a"
2) "10"
3) "b"
4) "20"
5) "c"
6) "30"
ZRANGEBYSCORE
返回有序集 key 中,所有 score 值介于 min 和 max 之间(包括等于 min 或 max )的成员。有序集成员按 score 值递增(从小到大)次序排列。
可选的 LIMIT 参数指定返回结果的数量及区间(就像 SQL 中的 SELECT LIMIT offset, count ),注意当 offset 很大时,定位 offset 的操作可能需要遍历整个有序集,此过程最坏复杂度为 O(N) 时间。
可以通过使用 WITHSCORES 选项,来让成员和它的 score 值一并返回。
min 和 max 可以是 -inf 和 +inf ,这样一来,你就可以在不知道有序集的最低和最高 score 值的情况下,使用这类命令。
API:ZRANGEBYSCORE key min max [WITHSCORES] [LIMIT offset count]
127.0.0.1:6379> ZRANGEBYSCORE zset 10 50 withscores
 1) "a"
 2) "10"
 3) "b"
 4) "20"
 5) "c"
 6) "30"
 7) "d"
 8) "40"
 9) "e"
10) "50"
127.0.0.1:6379> ZRANGEBYSCORE zset -inf +inf
1) "a"
2) "b"
3) "c"
4) "d"
5) "e"
ZCOUNT
返回有序集 key 中, score 值在 min 和 max 之间(默认包括 score 值等于 min 或 max )的成员的数量。
返回score 值在 min 和 max 之间的成员的数量。
API:ZCOUNT key min max
127.0.0.1:6379> zcount zset 10 30
(integer) 3
ZREMRANGEBYRANK
移除有序集 key 中,指定排名(rank)区间内的所有成员。
区间分别以下标参数 start 和 stop 指出,包含 start 和 stop 在内。
下标参数 start 和 stop 都以 0 为底,也就是说,以 0 表示有序集第一个成员,以 1 表示有序集第二个成员,以此类推。 你也可以使用负数下标,以 -1 表示最后一个成员, -2 表示倒数第二个成员,以此类推。
返回被移除成员的数量。
API:ZREMRANGEBYRANK key start stop
127.0.0.1:6379> zrange zset 0 100 withscores
 1) "a"
 2) "10"
 3) "b"
 4) "20"
 5) "c"
 6) "30"
 7) "d"
 8) "40"
 9) "e"
10) "50"
127.0.0.1:6379> ZREMRANGEBYRANK zset 0 1
(integer) 2
127.0.0.1:6379> zrange zset 0 100 withscores
1) "c"
2) "30"
3) "d"
4) "40"
5) "e"
6) "50"
ZREMRANGEBYSCORE
移除有序集 key 中,所有 score 值介于 min 和 max 之间(包括等于 min 或 max )的成员。
返回被移除成员的数量。
API:ZREMRANGEBYSCORE key min max
127.0.0.1:6379> zremrangebyscore zset 40 50
(integer) 2
ZINTERSTORE
计算给定的一个或多个有序集的交集,其中给定 key 的数量必须以 numkeys 参数指定,并将该交集(结果集)储存到 destination 。
默认情况下,结果集中某个成员的 score 值是所有给定集下该成员 score 值之和。
返回保存到 destination 的结果集的基数。
API:ZINTERSTORE destination numkeys key [key …] [WEIGHTS weight [weight …]] [AGGREGATE SUM|MIN|MAX]
127.0.0.1:6379> zadd test1 10 a 20 b 30 c 40 d 50 e
(integer) 5
127.0.0.1:6379> zadd test2 10 a 20 b 30 c 40 d 50 e
(integer) 5
127.0.0.1:6379> ZINTERSTORE sum_point 2 test1 test2
(integer) 5
127.0.0.1:6379> zrange sum_point  0 -1 withscores
 1) "a"
 2) "20"
 3) "b"
 4) "40"
 5) "c"
 6) "60"
 7) "d"
 8) "80"
 9) "e"
10) "100"
ZUNIONSTORE
计算给定的一个或多个有序集的并集,其中给定 key 的数量必须以 numkeys 参数指定,并将该并集(结果集)储存到 destination 。
默认情况下,结果集中某个成员的 score 值是所有给定集下该成员 score 值之 和 。
WEIGHTS
使用 WEIGHTS 选项,你可以为 每个 给定有序集 分别 指定一个乘法因子(multiplication factor),每个给定有序集的所有成员的 score 值在传递给聚合函数(aggregation function)之前都要先乘以该有序集的因子。
如果没有指定 WEIGHTS 选项,乘法因子默认设置为 1 。
AGGREGATE
使用 AGGREGATE 选项,你可以指定并集的结果集的聚合方式。
默认使用的参数 SUM ,可以将所有集合中某个成员的 score 值之 和 作为结果集中该成员的 score 值;使用参数 MIN ,可以将所有集合中某个成员的 最小 score 值作为结果集中该成员的 score 值;而参数 MAX 则是将所有集合中某个成员的 最大 score 值作为结果集中该成员的 score 值。
返回保存到 destination 的结果集的基数。
127.0.0.1:6379> zrange test3 0 -1 withscores
1) "a"
2) "10"
3) "b"
4) "20"
127.0.0.1:6379> zrange test4 0 -1 withscores
1) "a"
2) "10"
3) "b"
4) "20"
5) "c"
6) "30"
7) "d"
8) "40"
127.0.0.1:6379> zunionstore test5 2 test4 test5 weights 1 3
(integer) 4
127.0.0.1:6379> zrange test5 0 -1 withscores
1) "a"
2) "10"
3) "b"
4) "20"
5) "c"
6) "30"
7) "d"
8) "40"
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论