Python3网络爬虫开发实践读书笔记 --- 第七章 动态渲染页面爬取
文章目录
这一系列文章是我在阅读“Python3网络爬虫开发实践”一书以及其他线上资料学习爬虫过程中的一些笔记和心得,希望能分享给大家。
章节概述:如何运用模拟浏览器运行的库爬取动态渲染页面的内容。
章节结构:
- Selenium
- Splash
具体内容:
- Selenium
1.定义:Selenium是一个自动化测试工具,利用它可以驱动浏览器执行特定动作,且获取当前源代码。
2.使用Selenium爬取JS动态渲染的页面
2.1 selenium.webdriver
common, support, Chrome,FireFox等浏览器库,Chrome实例可以打开浏览器,并且跳传至指定网页,通过定义输入input和浏览器实例的find_element_by_id函数锁定搜索框,并且输入搜索关键字,还可以获取cookie,url,page_source等信息。具体步骤如下:
a.声明一个浏览器对象browser = webdriver.Chrome()
或者browser = webdriver.Firefox()
b.访问页面browser.get("http://www.somewhere.com")
c.查找节点
browser.find_element_by_name('q')
browser.find_element_by_id('q')
除去以上常见的两种,还可以通过css selector,xpath等等来find。这些方法会返回一个WebElement的实例
或者直接通过find_element方法node = browser.find_element(By.ID, 'q')
如果要获取多个节点,可以用find_elements方法
d.节点交互
让浏览器模拟一些动作,比如搜索框搜索一个词:input_node.send_keys("Question")
e.动作链:没有对应节点的一系列动作
actions = ActionChains(browser)
actions.drag_and_drop(source, target)f.执行JavaScriptbrowser.execute_script()
g.获取节点信息
可以通过get_attributs(),get_text(), 或者直接读取node.id, node.localtion, node.tage_name等
h.延时等待:隐式等待&显式等待
隐式等待是在没有找到节点时继续等待,如果超出设定延时就报找不到节点异常,implicitly_wait(10)
显式等待是指定节点,如果再超时,就抛出超时异常,通过引入WebDriverWait对象,指定时间,调用until传入expected_conditions,如果找到就返回节点,没有就抛出异常。等待条件也有很多种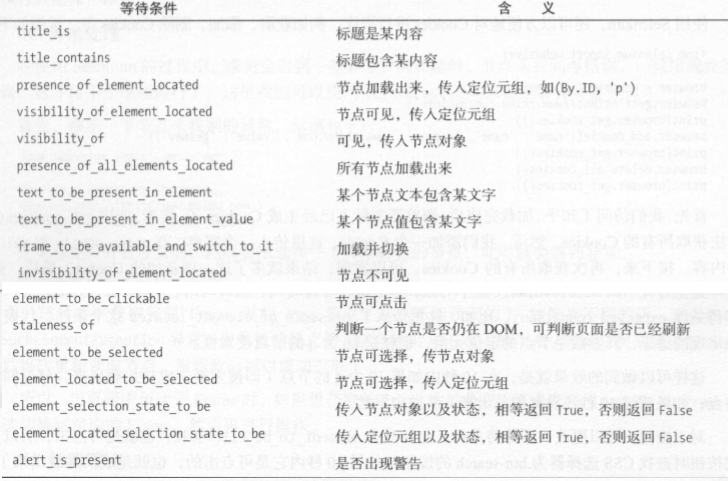
i.前进后退:back & forward
j.Cookies:browser.get_cookies & delete_all_cookies
k.选项卡管理:browser.window_handles & switch_to_window
l.异常处理:selenium.common.exceptions
m.
n.
o.
p.
q.
r.
s.
t.
u.
v.
w.
x.
y.
z.
- Splash
1.定义:Splash是一个JS渲染服务,是一个带有HTTP_API的轻量级浏览器,同时他对接了Python中的Twisted和QT库
2.功能:
可以异步处理多个玩个渲染过程,获取渲染后的页面源代码和截图。也可以关闭图片渲染,运用AdBlock等加速获取文字内容,执行JS脚本等。
3.使用方法:Splash提供web界面显示渲染结果,可以通过输入框选择百度测试。也可以通过Splash Lua脚本,执行一系列的渲染动作,比如splash提供go,wait,evaljs等函数
4.Splash对象的属性
args:获取加载时配置的参数,比如URL,GET请求参数,POST请求表单等
js_enable:表示JS是否执行
resource_timeout:加载超时设置
images_enable:图片是否加载
plugins_enable:浏览器插件控制,比如flash插件
scroll_position:控制页面滚动
5.Splash对象动作
go:跳转至某个页面
wait:等待加载时间
jsfunc:
evaljs:执行js代码,并返回最后一条的执行结果
runjs:执行js脚本
autoload:自动加载对象
call_later:延时调用
http_get:http的get请求
http_post:http的post请求
set_content:设置页面内容
html:获取网页源代码
png:获取png格式的网页截图
har:获取页面加载过程的描述
url:获取当前url
除去以上的函数,还有get_cookie,add_cookie,clear_cookie,get_viewport_size,select_all,mouse_click,jpeg等方法
6.Splash负载均衡
因为爬取任务有时候很多,可以起多个Splash服务,搭配Nginx,以轮询模式实现负载均衡那个,共通爬取数据。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论