Java函数式编程Stream.collect()为什么这么受欢迎?

文章目录
前几天更新的文章内容相信前面繁琐的内容已彻底打消了你学习Java函数式编程的热情,不过很遗憾,下面的内容更繁琐。但这不能怪Stream类库,因为要实现的功能本身很复杂。
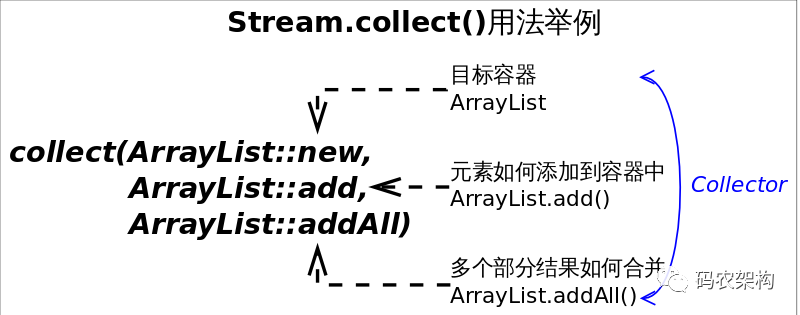
收集器(Collector)是为Stream.collect()方法量身打造的工具接口(类)。考虑一下将一个Stream转换成一个容器(或者Map)需要做哪些工作?我们至少需要两样东西:
目标容器是什么?是ArrayList还是HashSet,或者是个TreeMap。
新元素如何添加到容器中?是List.add()还是Map.put()。如果并行的进行规约,还需要告诉collect()
多个部分结果如何合并成一个。
结合以上分析,collect()方法定义为 R collect(Supplier supplier, BiConsumer<R,? super T> accumulator, BiConsumer<R,R> combiner),三个参数依次对应上述三条分析。不过每次调用collect()都要传入这三个参数太麻烦,收集器Collector就是对这三个参数的简单封装,所以collect()的另一定义为<R,A> R collect(Collector<? super T,A,R> collector)。Collectors工具类可通过静态方法生成各种常用的Collector。举例来说,如果要将Stream规约成List可以通过如下两种方式实现:
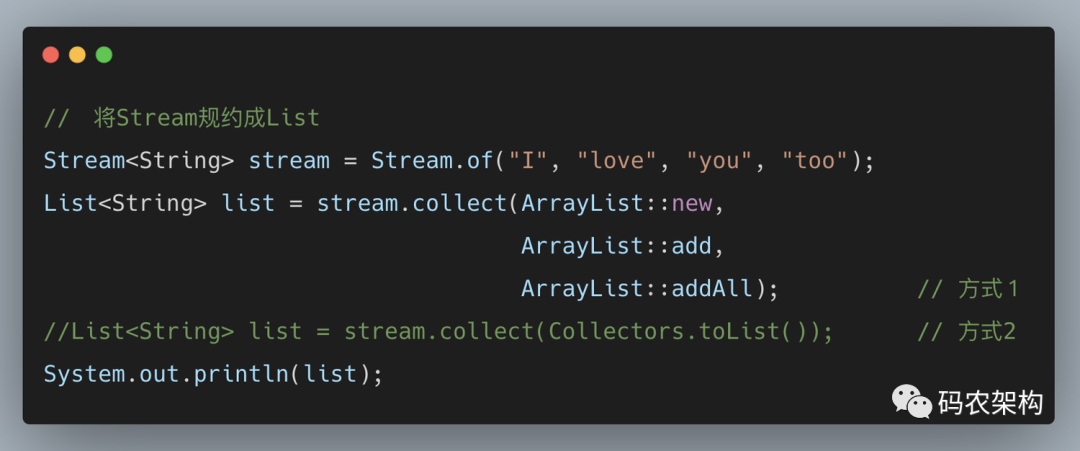
通常情况下我们不需要手动指定collect()的三个参数,而是调用collect(Collector<? super T,A,R> collector)方法,并且参数中的Collector对象大都是直接通过Collectors工具类获得。实际上传入的收集器的行为决定了collect()的行为。
使用collect()生成Collection
前面已经提到通过collect()方法将_Stream_转换成容器的方法,这里再汇总一下。将_Stream_转换成_List_或_Set_是比较常见的操作,所以Collectors工具已经为我们提供了对应的收集器,通过如下代码即可完成:
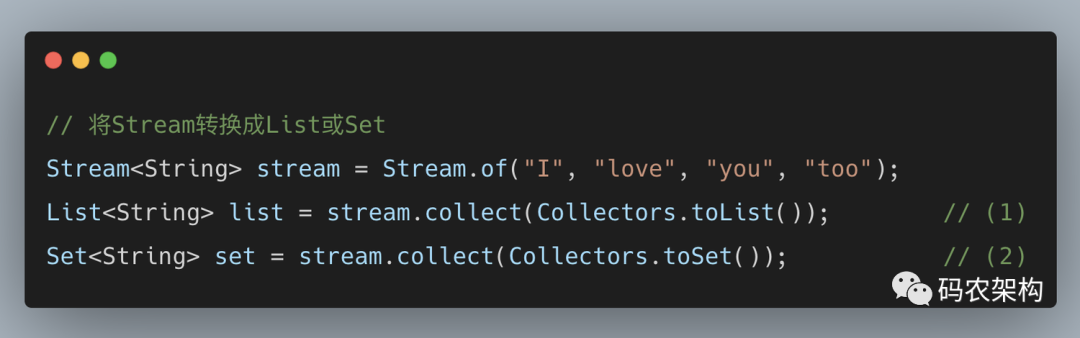
上述代码能够满足大部分需求,但由于返回结果是接口类型,我们并不知道类库实际选择的容器类型是什么,有时候我们可能会想要人为指定容器的实际类型,这个需求可通过Collectors.toCollection(Supplier collectionFactory)方法完成。
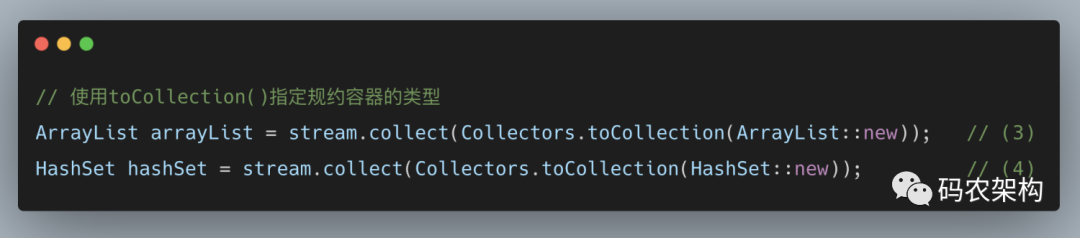
上述代码(3)处指定规约结果是_ArrayList_,而(4)处指定规约结果为_HashSet_。一切如你所愿。
使用collect()生成Map
前面已经说过Stream背后依赖于某种数据源,数据源可以是数组、容器等,但不能是Map。反过来从Stream生成Map是可以的,但我们要想清楚Map的key和value分别代表什么,根本原因是我们要想清楚要干什么。通常在三种情况下collect()的结果会是Map:
使用
Collectors.toMap()生成的收集器,用户需要指定如何生成Map的key和value。使用
Collectors.partitioningBy()生成的收集器,对元素进行二分区操作时用到。使用
Collectors.groupingBy()生成的收集器,对元素做group操作时用到。
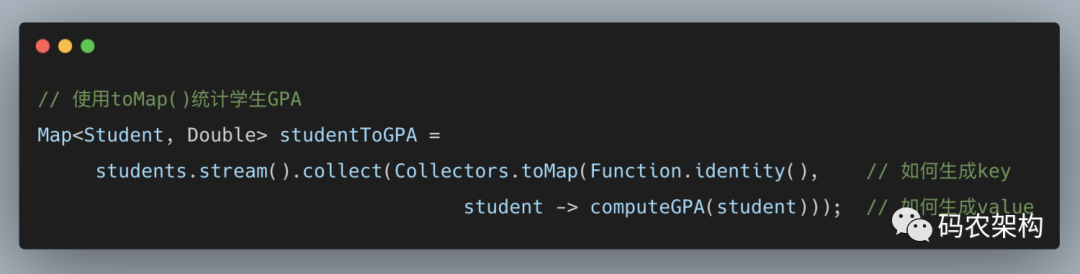
情况1:使用toMap()生成的收集器,这种情况是最直接的,前面例子中已提到,这是和Collectors.toCollection()并列的方法。如下代码展示将学生列表转换成由<学生,GPA>组成的Map。非常直观,无需多言。
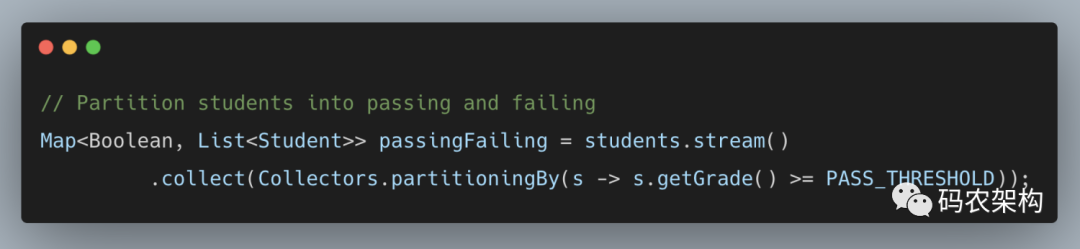
情况2:使用partitioningBy()生成的收集器,这种情况适用于将Stream中的元素依据某个二值逻辑(满足条件,或不满足)分成互补相交的两部分,比如男女性别、成绩及格与否等。下列代码展示将学生分成成绩及格或不及格的两部分。
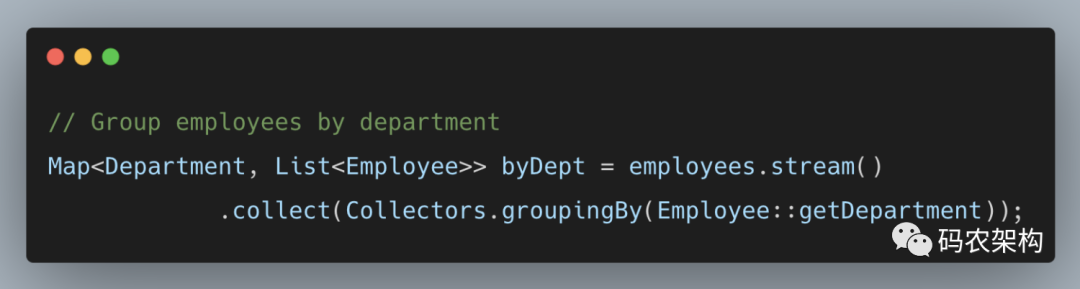
情况3:使用groupingBy()生成的收集器,这是比较灵活的一种情况。跟SQL中的_group by_语句类似,这里的_groupingBy()_也是按照某个属性对数据进行分组,属性相同的元素会被对应到_Map_的同一个_key_上。下列代码展示将员工按照部门进行分组:
以上只是分组的最基本用法,有些时候仅仅分组是不够的。在SQL中使用_group by_是为了协助其他查询,比如
先将员工按照部门分组
然后统计每个部门员工的人数。
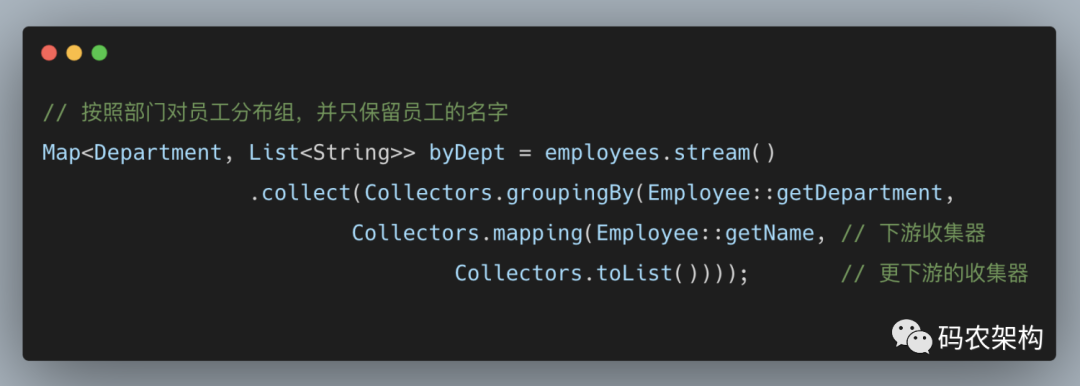
Java类库设计者也考虑到了这种情况,增强版的groupingBy()能够满足这种需求。增强版的groupingBy()允许我们对元素分组之后再执行某种运算,比如求和、计数、平均值、类型转换等。这种先将元素分组的收集器叫做上游收集器,之后执行其他运算的收集器叫做下游收集器(downstream Collector)。
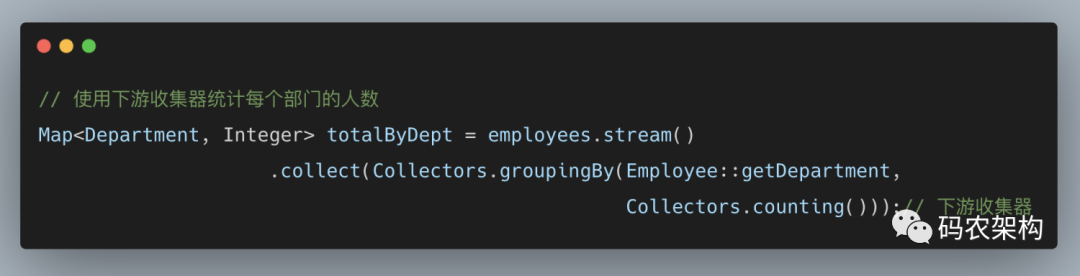
上面代码的逻辑是不是越看越像SQL?高度非结构化。还有更狠的,下游收集器还可以包含更下游的收集器,这绝不是为了炫技而增加的把戏,而是实际场景需要。考虑将员工按照部门分组的场景,如果我们想得到每个员工的名字(字符串),而不是一个个Employee对象,可通过如下方式做到:
使用collect()做字符串join
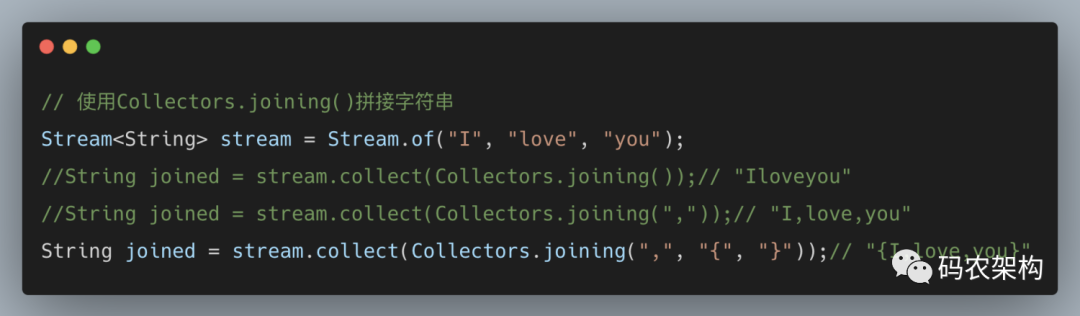
这个肯定是大家喜闻乐见的功能,字符串拼接时使用Collectors.joining()生成的收集器,从此告别_for_循环。Collectors.joining()方法有三种重写形式,分别对应三种不同的拼接方式。无需多言,代码过目难忘。
collect()还可以做更多
除了可以使用Collectors工具类已经封装好的收集器,我们还可以自定义收集器,或者直接调用collect(Supplier supplier, BiConsumer<R,? super T> accumulator, BiConsumer<R,R> combiner)方法,收集任何形式你想要的信息。不过Collectors工具类应该能满足我们的绝大部分需求,手动实现之间请先看看文档。
- END -
往期推荐
[
JDK1.8升级这么久!Stream流的规约操作有哪些?
[
函数式编程Stream接口真的有那么好用吗?
[
Kafka在哪些场景下会造成重复消费或消息丢失?
[
Map在Java 8中增加非常实用哪些函数接口?
[
Kafka消费者提交消费位移时提交的是当前消费到的最新消息的 offset 还是 offset+1?
本文分享自微信公众号 - 码农架构(iByteCoding)。
如有侵权,请联系 support@oschina.cn 删除。
本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论