《图解 Google V8》编译流水篇——学习笔记(二)
文章目录
这是《图解 Google V8》第二篇/共三篇:编译流水线
学习下来最大的收获有两点:
V8如何提升JavaScript执行速度- 早期缓存机器码,之后重构为缓存字节码
在
JavaScript中访问一个属性时,V8做了哪些优化- 隐藏类
- 内联缓存
特别是第二点,让我看到了使用 TypeScript 的好处,动态语言存在的问题,静态语言都可以解决
09 | 运行时环境:运行 JavaScript 代码的基石
运行时环境包括:堆空间和栈空间、全局执行上下文、全局作用域、内置的内建函数、宿主环境提供的扩展函数和对象,还有消息循环系统
宿主
浏览器为 V8 提供基础的消息循环系统、全局变量、Web API
V8 的核心是实现 ECMAScript 标准,比如:Object、Function、String,还提供垃圾回收、协程等
构造数据存储空间:堆空间和栈空间
在 Chrome 中,只要打开一个渲染进程,渲染进程便会初始化 V8,同时初始化堆空间和栈空间。
栈是内存中连续的一块空间,采用“先进后出”的策略。
在函数调用过程中,涉及到上下文相关的内容都会存放在栈上,比如原生类型、引用的对象的地址、函数的执行状态、this 值等都会存在栈上
当一个函数执行结束,那么该函数的执行上下文便会被销毁掉。
堆空间是一种树形的存储结构,用来存储对象类型的离散的数据,比如:函数、数组,在浏览器中还有 window、document 等
全局执行上下文和全局作用域
执行上下文中主要包含三部分,变量环境、词法环境和 this 关键字
全局执行上下文在 V8 的生存周期内是不会被销毁的,它会一直保存在堆中
在 ES6 中,同一个全局执行上下文中,都能存在多个作用域:
var x = 5;
{
  let y = 2;
  const z = 3;
}
构造事件循环系统
V8 需要一个主线程,用来执行 JavaScript 和执行垃圾回收等工作
V8 是寄生在宿主环境中的,V8 所执行的代码都是在宿主的主线程上执行的
如果主线程正在执行一个任务,这时候又来了一个新任务,把新任务放到消息队列中,等待当前任务执行结束后,再从消息队列中取出正在排列的任务,执行完这个任务之后,再重复这个过程
10 | 机器代码:二进制机器码究竟是如何被 CPU 执行的?
将汇编语言转换为机器语言的过程称为“汇编”;反之,机器语言转化为汇编语言的过程称为“反汇编”
在程序执行之前,需要将程序装进内存中(内存中的每个存储空间都有独一无二的地址)
二进制代码被装载进内存后,CPU 便可以从内存中取出一条指令,然后分析该指令,最后执行该指令。
把取出指令、分析指令、执行指令这三个过程称为一个 CPU 时钟周期
CPU 中有一个 PC 寄存器,它保存了将要执行的指令地址,到下一个时钟周期时,CPU 便会根据 PC 寄存器中的地址,从内存中取出指令。
PC 寄存器中的指令取出来之后,系统要做两件事:
- 将下一条指令的地址更新到
PC寄存器中 - 分析该指令,识别出不同类型的指令,以及各种获取操作数的方法
因为 CPU 访问内存的速度很慢,所以需要通用寄存器,用来存放 CPU 中数据的(通用寄存器容量小,读写速度快,内存容量大,读写速度慢。)
通用寄存器通常用来存放数据或者内存中某块数据的地址,我们把这个地址又称为指针
ebp寄存器通常是用来存放栈帧指针esp寄存器用来存放栈顶指针PC寄存器用来存放下一条要执行的指令
常用的指令类型:
- 加载指令:从内存中复制指定长度的内容到通用寄存器中,并覆盖寄存器中原来的内容
- 存储指令:和加载类型的指令相反,作用是将寄存器中的内容复制到内存中的某个位置,并覆盖掉内存中的这个位置上原来的内容
- 更新指令:作用是复制两个寄存器中的内容到
ALU中 - 跳转指令:从指令本身抽取出一个字,这个字是下一条要执行的指令地址,并将该字复制到
PC寄存器中,并覆盖掉PC寄存器中原来的值
11 | 堆和栈:函数调用是如何影响到内存布局的?
函数有两个主要的特性:
- 可以被调用
- 具有作用域机制
所以:
- 函数调用者的生命周期比被调用者的长(后进),被调用者的生命周期先结束 (先出)
从函数资源分配和回收角度来看,
- 被调用函数的资源分配晚于调用函数 (后进),
- 被调用函数资源的释放先于调用函数 (先出)
栈的状态从 add 中恢复到 main 函数的上次执行时的状态,这个过程称为恢复现场
function main() {
  add();
}
function add(num1, num2) {
  return num1 + num2;
}
怎么恢复 main 函数的执行现场呢:
在
esp寄存器中保存一个永远指向当前栈顶的指针- 告诉你往哪个位置添加新元素
ebp寄存器,保存当前函数的起始位置(也叫栈帧指针)- 告诉
CPU移动到这个地址
- 告诉
栈帧:每个栈帧对应着一个未运行完的函数,栈帧中保存了该函数的返回地址和局部变量。
12 | 延迟解析:V8 是如何实现闭包的?
在编译阶段,V8 不会对所有代码进行编译,采用一种“惰性编译”或者“惰性解析”,也就是说 V8 默认不会对函数内部的代码进行编译,只有当函数被执行前,才会进行编译。
闭包的问题指的是:由于子函数使用到了父函数的变量,导致父函数在执行完成以后,它内部被子函数引用的变量无法及时在内存中被释放。
而闭包问题产生的根本原因是 JavaScript 中本身的特性:
- 可以在函数内部定义新的函数
- 内部函数可以访问父函数的变量
- 函数是一等公民,所以函数可以作为返回值
既然由于 JavaScript 的这种特性就会出现闭包的问题,那么就需要解决闭包问题,“预编译“ 或者 “预解析” 就出现了
预编译具体方案: 在编译阶段,V8 会对函数函数进行预解析
- 判断函数内语法是否正确
子函数是否引用父函数中的变量,如果有的话,将这个变量复制一份到堆中,同时子函数本身也是一个对象,也会被放到堆中
- 父函数执行完成后,内存会被释放
- 子函数在执行时,依然可以从堆内存中访问复制过来的变量
13 | 字节码(一):V8 为什么又重新引入字节码?
在 V8 中,字节码有两个作用:
- 解释器可以直接执行字节码
- 优化编译器可以将字节码编译为机器码,然后再执行机器码
早期的 V8
V8 团队认为“先生成字节码再执行字节码”,会牺牲代码的执行速度,便直接将 JavaScript 代码编译成机器码
使用了两个编译器:
- 基线编译器:将
JavaScript代码编译为没有优化过的机器码 - 优化编译器:将一些热点代码(执行频繁的代码)优化为执行效率更高的机器码
执行 JavaScript:
- 将
JavaScript代码转换为抽象语法树(AST) - 基线编译器将
AST编译为未优化过的机器码,然后V8执行这些未优化过的机器代码 - 在执行未优化的机器代码时,将一些热点代码优化为执行效率更高的机器代码,然后执行优化过的机器码
- 如果优化过的机器码不满足当前代码的执行,
V8会进行反优化操作
问题
1. 机器码缓存
V8 执行一段 JavaScript 代码,编译时间和执行时间差不多
如果再 JavaScript 没有改变的情况下,每次都编译这段代码,就会浪费 CPU 资源
所以 V8 引入机器码缓存:
- 将源代码编译成机器码后,放在内存中(内存缓存)
- 下次再执行这段代码,就先去内存中查找是否存在这段代码的机器码,有的话就执行这段机器码
- 将编译后的机器码存入硬盘中,关闭浏览器后,下次重新打开,可以直接用编译好的机器码
时间缩短了 20% ~ 40%
这是用空间换时间的策略,在移动端非常吃内存
2. 惰性编译
V8 采用惰性编译,只会编译全局执行上下文的代码
由于 ES6 之前,没有块级作用域,为了实现各模块之间的隔离,会采用立即执行函数
这会产生很多闭包,闭包模块中的代码不会被缓存,所以只缓存顶层代码是不完美的
所以 V8 就进行了大重构
现在的 V8
字节码 + 解释器 + 编译器
5K的源代码JavaScript->40K字节码 ->10M的机器码
字节码的体积远小于机器码,浏览器就可以实现缓存所有的字节码,而不仅仅是全局执行上下文的字节码
优点:
- 降低了内存
- 提升代码启动速度
- 降低了代码的复杂度
缺点:
- 执行效率下降
解释器的作用是将源代码转换成字节码
V8 的解释器是:lgnition;V8 的编译器是:TurboFan
如何降低代码复杂度
机器码在不同 CPU 中是不一样的,直接将 AST 转换成不同的机器码,就需要基线编译器和优化编译器编写大量适配各 CPU 的代码
先将 AST 转换成字节码,再将字节码转换成机器码,由于字节码(消除了平台的差异性)和 CPU 执行机器码过程类似,将字节码转换成机器码就会容易很多
14 |字节码(二):解释器是如何解释执行字节码的?
生成字节码
function add(x, y) {
  var z = x + y;
  return z;
}
console.log(add(1, 2));
生成 AST
[generating bytecode for function: add]
--- AST ---
FUNC at 12
  KIND 0
  LITERAL ID 1
  SUSPEND COUNT 0
  NAME "add"
  PARAMS
    VAR (0x7fa7bf8048e8) (mode = VAR, assigned = false) "x"
    VAR (0x7fa7bf804990) (mode = VAR, assigned = false) "y"
  DECLS
    VARIABLE (0x7fa7bf8048e8) (mode = VAR, assigned = false) "x"
    VARIABLE (0x7fa7bf804990) (mode = VAR, assigned = false) "y"
    VARIABLE (0x7fa7bf804a38) (mode = VAR, assigned = false) "z"
  BLOCK NOCOMPLETIONS at -1
    EXPRESSION STATEMENT at 31
      INIT at 31
        VAR PROXY local[0] (0x7fa7bf804a38) (mode = VAR, assigned = false) "z"
        ADD at 32
          VAR PROXY parameter[0] (0x7fa7bf8048e8) (mode = VAR, assigned = false) "x"
          VAR PROXY parameter[1] (0x7fa7bf804990) (mode = VAR, assigned = false) "y"
  RETURN at 37
    VAR PROXY local[0] (0x7fa7bf804a38) (mode = VAR, assigned = false) "z"
将 AST 图形化
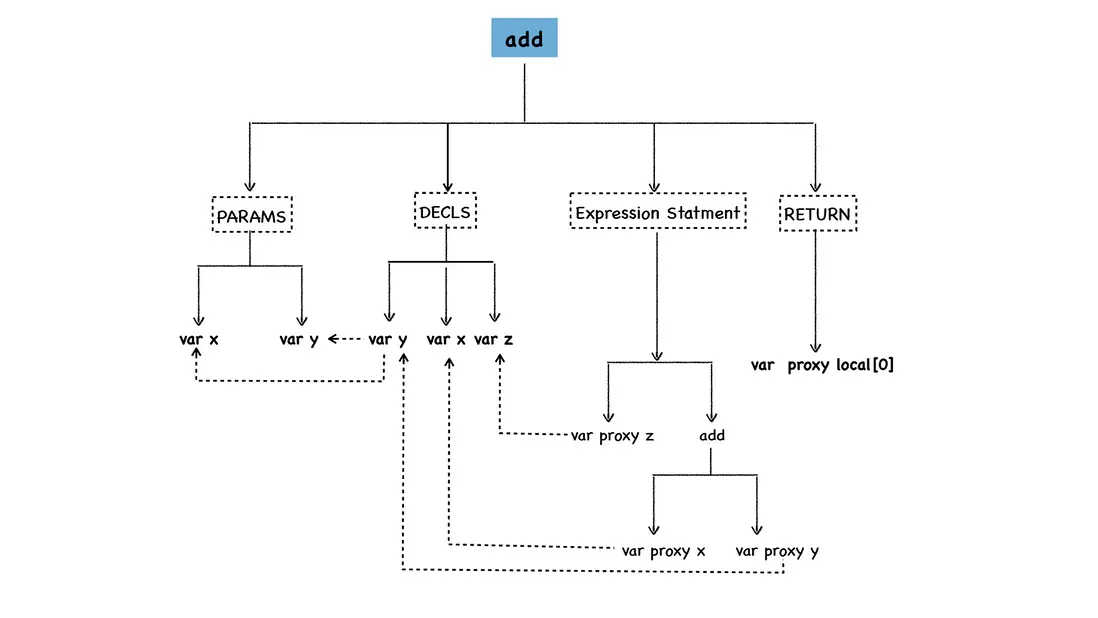
将函数拆成了 4 部分
- 参数声明(
PARAMS):包括声明中的所有参数,这里是x和y,也可以使用arguments - 变量声明节点(
DECLS):出现了3个变量:x、y、z,你会发现x和y的地址和PARAMS中是相同的,说明他们是同一块数据 - 表达式节点:
ADD节点下有VAR PROXY parameter[0]和VAR PROXY parameter[1] RETURN节点:指向了z的值,这里是local[0]
生成 AST 的同时,还生成了 add 函数的作用域
Global scope:
function add (x, y) { // (0x7f9ed7849468) (12, 47)
  // will be compiled
  // 1 stack slots
  // local vars:
  VAR y;  // (0x7f9ed7849790) parameter[1], never assigned
  VAR z;  // (0x7f9ed7849838) local[0], never assigned
  VAR x;  // (0x7f9ed78496e8) parameter[0], never assigned
}
在解析阶段,普通变量默认值是 undefined,函数声明指向实际的函数对象;执行阶段,变量会指向栈和堆相应的数据
AST 作为输入传到自己字节码生成器中(BytecodeGenerator),它是 lgnition 的一部分,生成以函数为单位的字节码
[generated bytecode for function: add (0x079e0824fdc1 <SharedFunctionInfo add>)]
Parameter count 3
Register count 2
Frame size 16
         0x79e0824ff7a @    0 : a7                StackCheck
         0x79e0824ff7b @    1 : 25 02             Ldar a1
         0x79e0824ff7d @    3 : 34 03 00          Add a0, [0]
         0x79e0824ff80 @    6 : 26 fb             Star r0
         0x79e0824ff82 @    8 : 0c 02             LdaSmi [2]
         0x79e0824ff84 @   10 : 26 fa             Star r1
         0x79e0824ff86 @   12 : 25 fb             Ldar r0
         0x79e0824ff88 @   14 : ab                Return
Constant pool (size = 0)
Handler Table (size = 0)
Source Position Table (size = 0)
这里 Parameter count 3 表示显示的参数 x 和 y,及隐式参数 this
最终的字节码
StackCheck
Ldar a1
Add a0, [0]
Star r0
LdaSmi [2]
Star r1
Ldar r0
Return
理解字节码
有两种解释器:
基于栈(
State-based)- 使用栈来保存函数参数、中间运算结果、变量
基于寄存器(
Register-based)- 支持寄存器的指令操作,使用寄存器保存参数、中间计算结果
基于栈的解释器:Java 虚拟机、.Net 虚拟机,早期的 V8 虚拟机;优点:在处理函数调用、解决递归问题和切换上下文时简单快速
现在的 V8 采用了基于寄存器的设计
Ladr a1指令:将a1寄存器中的值加载到累加器中Star r0指令:把累加器中的值保存到r0寄存器中Add a0, [0]指令:- 从
a0寄存器加载值并与累加器中的值相加,再将结果放入累加器中 [0]:成为反馈向量槽(feedback vector slot),- 目的是了给优化编译器(
TurboFan)提供优化信息,它是一个数组,解释器将解释执行过程中的一些数据类型的分析信息保存在反馈向量槽中
- 目的是了给优化编译器(
- 从
LadSmi [2]指令:将小整数(Smi)2加载到累加器中Return指令:结束当前函数的执行,并将控制权还给调用方,返回的值是累加器中的值StackCheck指令:检查是栈是否到达溢出的上限
15 | 隐藏类:如何在内存中快速查找对象属性?
- 为了提升对象属性访问速度,引入隐藏类
- 为了加速运算引入内联缓存
为什么静态语言效率高
JavaScript 在运行时,对象的属性可以被修改,所以 V8 在解析对象时,比如:解析 start.x 时,它不知道 start 中是否有 x,也不知道 x 相对于 start 的偏移量是多少,简单说 V8 不知道 start 对象的具体行状
所以当 JavaScript 查询 start.x 时,过程非常慢
静态语言,比如 C++ 在声明对象之前需要定义该对象的结构(行状),执行之前会被编译,编译的时候,行状是固定的,也就是说在执行过程中,对象的行政是无法改变的
所以当 C++ 查询 start.x 使,编译器在编译的时候,会直接将 x 相对于 start 对象的地址写进汇编指令中,查询时直接读取 x 的地址,没有查找环节
隐藏类
V8 为了做到这点,做了两个假设:
- 对象创建好了之后不会添加新的属性
- 对象创建好了之后也不会删除属性
然后 V8 为每个对象创建一个隐藏类,记录基础的信息
- 对象中所包含的所有属性
- 每个属性相对于对象的偏移量。
在 V8 中隐藏类有称为 map,即每个对象都有一个 map 属性,指向内存中的隐藏类
有了 map 之后,当访问 start.x 时,V8 会先去 start.map 中查询 x 相对 start 的偏移量,然后将 point 对象的地址加上偏移量就得到了 x 属性的值在内存中的地址了
如果两个对象行状相同,V8 会为其复用同一个隐藏类:
- 减少隐藏类的创建次数,也间接加速了代码的执行速度
- 减少了隐藏类的存储空间
两个对象的形状相同,要满足:
- 相同的属性名称
- 相同的属性顺序
- 相同的属性类型
- 相等的属性个数
如果动态改变了对象的行状,V8 就会重新构建新的隐藏类
参考资料:
16 | 答疑:V8 是怎么通过内联缓存来提升函数执行效率的?
function loadX(o) {
  return o.x;
}
var o = { x: 1, y: 3 };
var o1 = { x: 3, y: 6 };
for (var i = 0; i < 90000; i++) {
  loadX(o);
  loadX(o1);
}
V8 获取 o.x 的流程:查找对象 o 的隐藏类,再通过隐藏类查找 x 属性偏移量,然后根据偏移量获取属性值
这段代码里 o.x 会被反复执行,那么查找流程也会被反复执行,那么 V8 有没有做这优化呢
内联缓存(Inline Cache,简称 IC)
V8 在执行函数的过程中,会观察函数中的一些调用点(CallSite)上的关键数据(中间数据),然后将它们缓存起来,当下次再执行该函数时,V8 可以利用这些中间数据,节省再次获取这些数据的过程
IC 会为每个函数维护一个反馈向量(FeedBack Vector),反馈向量记录了函数在执行过程中的一些关键的中间数据
反馈向量是一个表结构,有很多项,每一项称为一个插槽 (Slot)
function loadX(o) {
  o.y = 4;
  return o.x;
}
当 V8 执行这段函数时,它判断 o.y = 4 和 return o.x 是调用点 (CallSite),因为它们使用了对象和属性,那么 V8 会在 loadX 函数的反馈向量中为每个调用点分配一个插槽。
插槽中包括了:
- 插槽的索引 (
slot index) - 插槽的类型 (
type) - 插槽的状态 (
state) - 隐藏类 (
map) 的地址 - 属性的偏移量
function loadX(o) {
  return o.x;
}
loadX({ x: 1 });

// 字节码
StackCheck // 检查是否溢出
LdaNamedProperty a0, [0], [0] // 取出参数 a0 的第一个属性值,并将属性值放到累加器中
Return // 返回累加器中的属性
LdaNameProperty 有三个参数:
a0是loadX的第一参数- 第一个
[0]表示取出对象a0的第一个属性值 - 第二个
[0]和反馈向量有关,表示将LdaNameProperty操作的中间数据写到反馈向量中,这里0表示第一个插槽
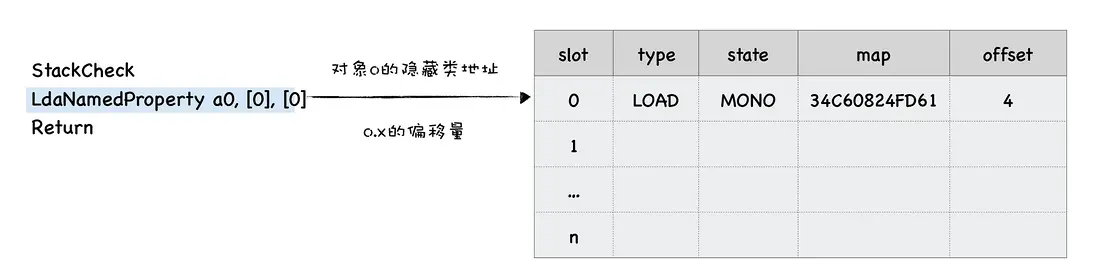
map:缓存了o的隐藏类的地址offset:缓存了属性x的偏移量type:缓存了操作类型,这里是LOAD类型。在反馈向量中,我们把这种通过o.x来访问对象属性值的操作称为LOAD类型。
function foo() {}
function loadX(o) {
  o.y = 4;
  foo();
  return o.x;
}
loadX({ x: 1, y: 4 });

// 字节码
StackCheck
// 下面两行是 o.y = 4,STORE 类型
LdaSmi [4]
StaNamedProperty a0, [0], [0]
// 下面三行是 调用 foo 函数,CALL
LdaGlobal [1], [2]
Star r0
CallUndefinedReceiver0 r0, [4]
// 下面一行是 o.x
LdaNamedProperty a0, [2], [6]
Return
多态和超态
function loadX(o) {
  return o.x;
}
// o 和 o1 行状不同
var o = { x: 1, y: 3 };
var o1 = { x: 3, y: 6, z: 4 };
for (var i = 0; i < 90000; i++) {
  loadX(o);
  loadX(o1);
}- 第一次执行
loadX时,V8将o的隐藏类记录在反馈向量中,同时记录x的偏移量 - 第二次执行
loadX,V8先取出反馈向量中的隐藏类,和o1的隐藏类进行比较,不是同一个隐藏类,那么就无法使用反馈向量中缓存的偏移量了

- 一个插槽只有
1个隐藏类,称为单态 (monomorphic) - 一个插槽有
2 ~ 4个隐藏类,称为为多态 (polymorphic) - 一个插槽中超过
4个隐藏类,称为超态 (magamorphic)。
如果一个插槽中存在多态或者超态时,执行效率是低于单态的(多了比较的过程)
参考资料:
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论