Fast-R-CNN
文章目录
原文 https://zhuanlan.zhihu.com/p/...
算法的主要内容
- Conv layers。作为一种CNN网络目标检测方法,Faster RCNN首先使用一组基础的conv+relu+pooling层提取image的feature maps。该feature maps被共享用于后续RPN层和全连接层。
- Region Proposal Networks。RPN网络用于生成region proposals。该层通过softmax判断anchors属于positive或者negative,再利用bounding box regression修正anchors获得精确的proposals。
- Roi Pooling。该层收集输入的feature maps和proposals,综合这些信息后提取proposal feature maps,送入后续全连接层判定目标类别。
- Classification。利用proposal feature maps计算proposal的类别,同时再次bounding box regression获得检测框最终的精确位置。
算法流程图
算法整体流程

1. Conv Layers
所有的conv层都是:kernel_size=3,pad=1,stride=1
所有的pooling层都是:kernel_size=2,pad=0,stride=2
conv层的卷积不改变图像大小,只有4个pooling层改变大小。最终feature map 尺寸是原图的16分之一。
2. Region Proposal Networks(RPN)
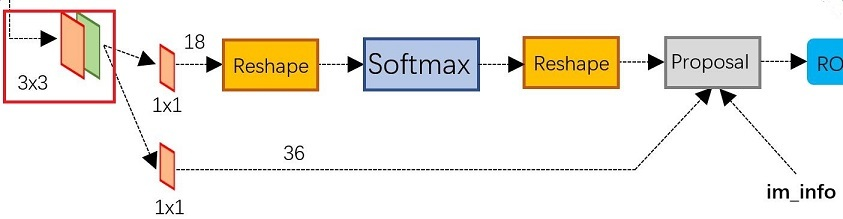
假设一副MxN的矩阵送入Conv Layers,到RPN之前变为(M/16)x(N/16),然后再经过一层1x1卷积,该卷积有18个卷积核,输出矩阵大小就是WxHx18。这里设置为18的意思是,feature map上的每个点都会预测9个固定尺寸的anchors,每个anchors有postive和negative两个预测值,因此输出一共WxHx18个预测值。
softmax的前后reshape layer是历史遗留问题,作用是方便softmax进行分类。
然后下面一条线是用来预测4*9=36个 bounding box regression坐标回归参数。
其实二分类不用2个值,一个logtis就够了,pytorch版的代码:
self.cls_logits = nn.Conv2d(in_channels, num_anchors, kernel_size=1, stride=1)
self.bbox_pred = nn.Conv2d(in_channels, num_anchors * 4, kernel_size=1, stride=1)
最后在proposal层进行整合,剔除,非极大值抑制(NMS),输出候选框的精确未知。
3. Rol Pooling
将不同尺寸的anchors在feature map上池化成固定大小的feature,用于后续全连接网络。
注意的点
- conv层的卷积不改变图像大小,只有4个pooling层改变大小。最终feature map 尺寸是原图的16分之一。
- 之前经典的检测框生成一般是滑动窗口+图像金字塔,非常耗时。这次是使用RPN直接生成检测框,提高了检测速度。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论