<译> 函子性
文章目录
原文见 http://bartoszmilewski.com/20...
-> 上一篇:『函子』
现在,你已经知悉函子是什么了,并且也见识了它的一些例子。本文要做的事,是用一些小函子构造出大函子。更有趣的是,你可以看到哪种类型构造子(相当于一个范畴内部对象之间的映射)能够被扩展为函子(态射之间的映射)。
二元函子
函子是 Cat 范畴(范畴的范畴)中的态射,因此你对态射(亦即函数)所形成的的大部分直觉也适用于函子。例如,如果一个函数能够有两个参数,那么函子也可以有两个参数,这种函子叫二元函子(Bifuntor)。对于对象而言,若一个对象来自范畴 C,另一个对象来自范畴 D,那么二元函子可以将这两个对象映射为范畴 E 中的某个对象。也就是说,二元函子是将范畴 C 与范畴 D 的笛卡尔积 C×D 映射为 E。

这是相当直观的。但是函子性意味着一个二元函子也必须能够映射态射。也就是说,二元函子必须将一对态射——其中一个来自 C,另一个来自 D,映射为 E 中的态射。
注意,上述的一对态射,只不过是范畴 C×D 中的一个态射。若一个态射是在范畴的笛卡尔积中定义的,那么它的行为就是将一对对象映射为另一对对象。这样的态射对可以复合:
(f, g) ∘ (f', g') = (f ∘ f', g ∘ g')这种复合是符合结合律的,并且它也有一个恒等态射,即恒等态射对 (id, id)。因此,范畴的笛卡尔积实际上也是一个范畴。
将二元函子想象为具有两个参数的函数会更直观一些。要证明二元函子是否是函子,不必借助函子定律,只需独立的考察它的参数即可。如果有一个映射,它将两个范畴映射为第三个范畴,只需证明这个映射相对于每个参数(例如,让另一个参数变成常量)具有函子性,那么这个映射就自然是一个二元函子。对于态射,也可以这样来证明二元函子具有函子性。
下面用 Haskell 定义一个二元函子。在这个例子中,三个范畴都是同一个:Haskell 类型的范畴。一个二元函子是一个类型构造子,它接受两个类型参数。下面是直接从 Control.Bifunctor 库中提取出来的 Bifunctor 类型类的定义:
class Bifunctor f where
    bimap :: (a -> c) -> (b -> d) -> f a b -> f c d
    bimap g h = first g . second h
    first :: (a -> c) -> f a b -> f c b
    first g = bimap g id
    second :: (b -> d) -> f a b -> f a d
    second = bimap id
类型变量 f 表示二元函子,可以看到有关它的所有类型签名都是作用于两个类型参数。第一个类型签名定义了 bimap 函数,它将两个函数映射为一个被提升了的函数 (f a b -> f c d),后者作用于二元函子的类型构造子所产生的类型。 bimap 有一个默认的实现,即 first 与 second 的复合,这表明只要 bimap 分别对两个参数都具备函子性,就意味着它是一个二元函子。

其他两个类型签名是 first 与 second,他们分别作用于 bimap 的第一个与第二个参数,因此它们是 f 具有函子性的两个 fmap 证据。
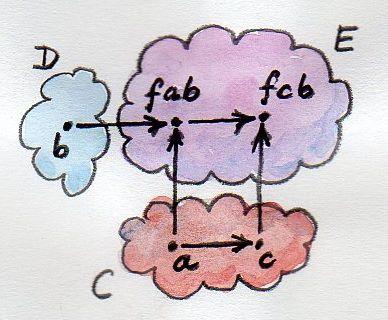
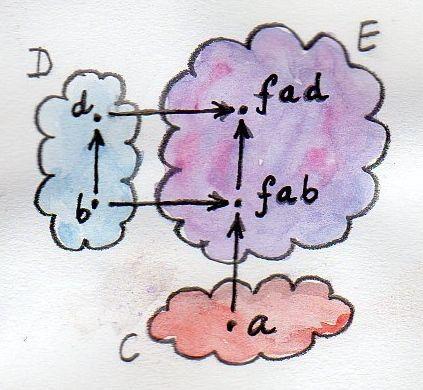
上述类型类的定义以 bimap 的形式提供了 first 与 second 的默认实现。
当声明 Bifunctor 的一个实例时,你可以去实现 bimap,这样 first 与 second 就不用再实现了;也可以去实现 first 与 second,这样就不用再实现 bimap 了。当然,你也可以三个都实现了,但是你需要确定它们之间要满足类型类的定义中的那些关系。
积与余积二元函子
二元函子的一个重要的例子是范畴积——由泛构造(Universal Construction)定义的两个对象的积。如果任意一对对象之间存在积,那么从这些对象到积的映射就具备二元函子性,这通常是正确的,特别是在 Haskell 中。序对构造子就是一个 Bifunctor 实例——最简单的积类型:
instance Bifunctor (,) where
bimap f g (x, y) = (f x, g y)不会有其他选择,bimap 就是简单的将第一个函数作用于第一个序对成员,将第二个函数作用于第二个序对成员。它的代码是不言自明的,其类型为:
bimap :: (a -> c) -> (b -> d) -> (a, b) -> (c, d)这个二元函子的用途就是产生类型序对,例如:
(,) a b = (a, b)余积作为对偶,如果它作用于范畴中的每一对对象,那么它也是一个二元函子。在 Haskell 中,余积二元函子的例子是 Either 类型构造子,它是 Bifunctor 的一个实例:
instance Bifunctor Either where
    bimap f _ (Left x)  = Left (f x)
    bimap _ g (Right y) = Right (g y)
这段代码也是不言自明的。
还记得我们讨论过幺半群范畴吗?一个幺半群范畴定义了一个作用于对象的二元运算,以及一个 unit 对象。我曾说过,Set 是一个与笛卡尔积相关的幺半群范畴,其 unit 是单例。Set 也是一个与不交并(Disjoint Union)相关的幺半群范畴,其 unit 是空集。我没有提到的是,幺半群范畴还需要一个二元函子。如果我们要让幺半群的积与态射所定义的范畴结构相兼容,这个二元函子是必须的。我们现在距离幺半群范畴的完整定义更近了一步,下一步是了解自然性(Naturality)。
具有函子性的代数数据类型
我们所看到的参数化的数据类型的几个例子,结果它们都是函子——可以为它们定义 fmap。复杂的数据类型是由简单的数据类型构造出来的。特别是代数数据类型(ADT),它是由和与积创建的。我们已经见识了和与积的函子性,也了解了函子的复合。因此,如果我们能揭示代数数据类型的基本构造块是具备函子性的,那么就可以确定代数数据类型也具备函子性。
那么,参数化的代数数据类型的基本构造块是什么?首先,有些构造块是不依赖于函子所接受的类型参数的,例如 Maybe 中的 Nothing,List 中的 Nil。它们等价与 Const 函子。记住,Const 函子忽略它的类型参数(实际上是忽略第二个类型参数,第一个被保留作为常量)。
其次,有些构造块简单的将类型参数封装为自身的一部分,例如 Maybe 中的 Just,它们等价于恒等函子。之前我提到过恒等函子,它是 Cat 范畴中的恒等态射,不过 Haskell 未对它进行定义。我们给出它的定义:
data Identity a = Identity a

instance Functor Identity where
    fmap f (Identity x) = Identity (f x)
可将 Indentity 视为最简单的容器,它只存储类型 a 的一个(不变)的值。
其他的代数数据结构都是使用这两种基本类型的和与积构建而成。
运用这个新知识,我们从一个新的角度来看 Maybe 类型构造子:
data Maybe a = Nothing | Just a它是两种类型的和,我们现在知道求和运算是具备函子性的。第一部分,Nothing 可以表示为作用于类型 a 的 Const ()(Const 的第一个类型参数是 unit——后面我们会看到 Const 更多有趣的应用),而第二部分不过是恒等函子的化名而已。在同构的意义下,我们可以将 Maybe 定义为:
type Maybe a = Either (Const () a) (Identity a)因此,Maybe 是 Const () 函子与 Indentity 函子被二元函子 Either 复合后的结果。Const 本身也是一个二元函子,只不过在这里用的是它的偏应用形式。
你应该看到了,两个函子的复合后,其结果是一个函子——这一点不难确定。我们还需要做的就是描述两个函子被一个二元函子复合后如何作用于态射。对于给定的两个态射,我们可以分别用这两个函子对其进行提升,然后再用二元函子去提升这两个被提升后的态射所构成的序对。
我们可以在 Haskell 中表示这种复合。先定义一个由二元函子 bf 参数化的数据类型,两个函子 fu 与 gu,以及两个常规类型 a 与 b。我们将 fu 作用于 a,将 gu 作用于 b,然后将 bf 作用于 fu a 与 fu b:
ewtype BiComp bf fu gu a b = BiComp (bf (fu a) (gu b))这是对象的复合,在 Haskell 中也就是类型的复合。注意,在 Haskell 中,类型构造子作用于类型,就像函数作用于它的参数一样。语法是相同的。
如果你有点迷惑,可以试试将 BiComp 作用于 Either,Const (),Indentity,a,以及 b。你得到的是一个裸奔版本的 Maybe b(a 被忽略了)。
如果 bf 是一个二元函子,fu 与 gu 都是函子,那么这个新的数据类型 BiComp 就是 a 与 b 之间的二元函子。编译器必须知道与 bf 匹配的 bimap 的定义,以及分别与 fu 与 gu 匹配的 fmap 的定义。在 Haskell 中,这个条件可以预先给出:一个类约束集合后面尾随一个粗箭头:
instance (Bifunctor bf, Functor fu, Functor gu) =>
  Bifunctor (BiComp bf fu gu) where
    bimap f1 f2 (BiComp x) = BiComp ((bimap (fmap f1) (fmap f2)) x)
面向 BiComp 的 bimap 实现是以面向 bf 的 bimap 以及两个分别面向 fu 与 gu 的 fmap 的形式给出的。在使用 Bimap 时,编译器会自动推断出所有类型,并选择正确的重载函数。
在 bimap 的定义中,x 的类型为:
bf (fu a) (gu b)它的个头很大。外围的 bimap 脱去它的 bf 层,然后两个 fmap 分别脱去它的 fu 与 gu 层。如果 f1 与 f2 的类型是:
f1 :: a -> a'
f2 :: b -> b'
那么,最终结果是类型 bf (fu a') (gu b'):
bimap (fu a -> fu a') -> (gu b -> gu b')
  -> bf (fu a) (gu b) -> bf (fu a') (gu b')
如果你喜欢拼图游戏,诸如此类的类型操作够你娱乐几个小时的了。
没有必要去证明 Maybe 是一个函子,由于它是两个基本的函子求和后的结果,因此 Maybe 自然也就具备了函子性。
敏锐的读者可能会问,对于代数数据类型而言,Functor 实例的继承相当繁琐,这个过程有无可能由编译器自动完成?的确,编译器能做到这一点。你需要在代码的首部中启用 Haskell 的扩展:
{-# LANGUAGE DeriveFunctor #-}然后在数据结构中添加 deriving Functor:
data Maybe a = Nothing | Just a
  deriving Functor
然后你就会得到相应的 fmap 的实现。
代数数据结构的规律性不仅适用于 Functor 的自动继承,也适合其它的类型类,例如之前提到的 Eq 类型类。也可以训导编译器自动继承你自定义的类型类,但是技术上要难一点。不过思想是相同的:你需要为你的类型类描述基本构造块、求和以及求积的行为,然后让编译器来描述其他部分。
C++ 中的函子
如果你是 C++ 程序猿,显然你会不知不觉的就实现了一些函子。不过,现在你应该能够认识到 C++ 中存在一些代数数据结构类型。如果这样的数据结构是以泛型模板的方式实现的,那么就可以为它实现 fmap。
看一下树的数据结构,它在 Haskell 中是一种递归求和类型:
data Tree a = Leaf a | Node (Tree a) (Tree a)
    deriving Functor
之前曾提到过,C++ 中是通过类继承的方式实现类型求和的。因此很自然的会想到,在一种面向对象语言中,可将 fmap 实现为 Functor 基类的虚函数,然后在子类中对其进行重载。不幸的是,这是无法实现的,因为 fmap 是一个模板,它的类型参数不仅是它所作用的对象的类型,也包括它所作用的函数的返回类型。在 C++ 中,类的虚函数无法模板化。因此我们只能将 fmap 实现为一个泛型的自由函数,并采用 dynamic_cast 替代 Haskell 中的模式匹配。
为了支持动态类型转换,基类至少需要定义一个虚函数,因此我们将析构函数定义为虚函数(在任何情况下这都是各好主意):
template<class T>
struct Tree {
    virtual ~Tree() {};
};
Leaf 只不过是一个带着面具的恒等(Identity)函子:
template<class T>
struct Leaf : public Tree<T> {
    T _label;
    Leaf(T l) : _label(l) {}
};
Node 是一个积类型:
template<class T>
struct Node : public Tree<T> {
    Tree<T> * _left;
    Tree<T> * _right;
    Node(Tree<T> * l, Tree<T> * r) : _left(l), _right(r) {}
};
在实现 fmap 时,我们需要借助 Tree 类型的动态分配的优势。Leaf 对应的情况是 fmap 的 Identity 版本,Node 对应的情况是一个二元函子,它复合了两个 Tree 函子的复本。作为 C++ 程序猿,你可能不习惯这样子分析代码,但是要建立范畴化思考,这是一个很好的练习。
template<class A, class B>
Tree<B> * fmap(std::function<B(A)> f, Tree<A> * t)
{
    Leaf<A> * pl = dynamic_cast <Leaf<A>*>(t);
    if (pl)
        return new Leaf<B>(f (pl->_label));
    Node<A> * pn = dynamic_cast<Node<A>*>(t);
    if (pn)
        return new Node<B>( fmap<A>(f, pn->_left)
                          , fmap<A>(f, pn->_right));
    return nullptr;
}
为了简单起见,我决定忽略内存与资源管理问题,但是在产品级代码中,你可能会考虑使用智能指针(独占还是共享,取决于你的决策)。
将上述 C++ 的 fmap 与 Haskell 的 fmap 对比一下:
instance Functor Tree where
    fmap f (Leaf a) = Leaf (f a)
    fmap f (Node t t') = Node (fmap f t) (fmap f t')
Haskell 中的 fmap 也可以由编译器通过自动继承实现。
Writer 函子
我曾许诺,将会重提 Kleisli 范畴。在 Kleisli 范畴中,态射被表示为被装帧过的函数,他们返回 Writer 数据结构。
type Writer a = (a, String)我说过,这种装帧与自函子有一些关系,并且 Writer 类型构造子对于 a 具有函子性。我们不需要去为它实现 fmap,因为它只是一种简单的积类型。
但是,Kleisli 范畴与一个函子之间存在什么关系呢?一个 Kleisli 范畴,作为一个范畴,它定义了复合与恒等。复合是通过小鱼运算符实现的:
(>=>) :: (a -> Writer b) -> (b -> Writer c) -> (a -> Writer c)
m1 >=> m2 = \x ->
    let (y, s1) = m1 x
        (z, s2) = m2 y
    in (z, s1 ++ s2)
恒等态射是一个叫做 return 的函数:
return :: a -> Writer a
return x = (x, "")
如果你仔细审度这两个函数的类型,结果会发现,可以将它们组合成一个函数,这个函数就是 fmap:
fmap f = id >=> (\x -> return (f x))这里,小鱼运算符组合了两个函数:一个是我们熟悉的 id,另一个是一个匿名函数,它将 return 作用于 f x。最难理解的地方可能就是 id 的用途。小鱼运算符难道不是接受一个『常规』类型,返回一个经过装帧的类型吗?实际上并非如此。没人说 a -> Writer b 中的 a 必须是一个『常规』类型。它是一个类型变量,因此它可以是任何东西,特别是它可以是一个被装帧的类型,例如 Writer b。
因此,id 将会接受 Writer a,然后返回 Writer a。小鱼运算符就会拿到 a 的值,将它作为 x 传给那个匿名函数。在匿名函数中,f 会将 x 变成 b,然后 return 会对 b 进行装帧,从而得到 Writer b。把这些放到一起,最终就得到了一个函数,它接受 Writer a,返回 Writer b,这正是 fmap 想要的结果。
注意,上述讨论是可以推广的:你可以将 Writer 替换为任何一个类型构造子。只要这个类型构造子支持一个小鱼运算符以及 return,那么你就可以定义 fmap。因此,Kleisli 范畴中的这种装帧,实际上是一个函子。(尽管并非每个函子都能产生一个 Kleisli 范畴)
你可能会感到奇怪,我们刚才定义的 fmap 是否与编译器使用 deriving Functor 自动继承来的 fmap 相同?相当有趣,它们是相同的。这是 Haskell 实现多态函数的方式所决定的。这种多态函数的实现方式叫做参数化多态,它是所谓的免费定理(Theorems for free)之源。这些免费的定理中有一个是这么说的,如果一个给定的类型构造子具有一个 fmap 的实现,它能维持恒等(将一个范畴中的恒等态射映射为另一个范畴中的恒等态射),那么它必定具备唯一性。
协变与逆变函子
刚才回顾了一番 Writer 函子,现在来回顾 Reader 函子。Reader 函子是『函数箭头』类型构造子的的偏应用(译注:函数箭头 -> 本身就是一个类型构造子,它接受两个类型参数)。
(->) r我们可以给它取一个类型别名:
type Reader r a = r -> a将它声明为 Functor 的实例,跟之前我们见过的类似:
instance Functor (Reader r) where
    fmap f g = f . g
但是,函数类型构造子接受两个类型参数,这一点与序对或 Either 类型构造子相似。序对与 Either 对于它们所接受的参数具备函子性,因此它们二元函子。函数类型构造子也是一个二元函子吗?
我们试试让函数类型构造子对于第一个参数具备函子性。为此需要再定义一个类型别名——与 Reader 相似,只是参数次序颠倒了一下:
type Op r a = a -> r这样,我们将返回类型 r 固定了下来,只让参数类型是 a 可变的。与它相匹配的 fmap 的类型签名如下:
fmap :: (a -> b) -> (a -> r) -> (b -> r)只凭借 a -> b 与 a -> r 这两个函数,显然无法构造 b -> r!如果我们以某种方式将第一个函数的参数翻转一下,让它变成 b -> a,这样就可以构造 b -> r 了。虽然我们不能随便反转一个函数的参数,但是在相反的范畴中可以这样做。
快速回顾一下:对于每个范畴 $C$,存在一个对偶范畴 $C^{OP}$,后者所包含的对象与前者相同,但是后者所有的箭头都与前者相反。
假设 $C^{op}$ 与另一个范畴 $D$ 之间存在一个函子:
$$F::C^{OP} \rightarrow D$$
这种函子将 $C^{OP}$ 中的一个态射 $f^{OP}::a \rightarrow b$ 映射为 $D$ 中的一个态射 $F\;f^{OP}::F\;a\rightarrow F\;b$. 但是,态射 $f^{OP}$ 在原范畴 $C$ 中与某个态射 $f::b\rightarrow a$ 相对应,它们的方向是相反的。
现在,$F$ 是一个常规的函子,但是我们可以基于 $F$ 定义一个映射,这个映射不是函子,姑且称之为 $G$. 这个映射从 $C$ 到 $D$. 它在映射对象方面的功能与 $F$ 相同,但是当它作用于态射时,它会将态射的方向反转。它接受 $C$ 中的一个态射 $f::b\rightarrow a$,将其映射为相反的态射 $f^{OP}::a\rightarrow b$,然后用函子 $F$ 作用于这个被反转的态射,结果得到 $F\;f^{OP}::F\;a\rightarrow F\;b$.

假设 $F\;a$ 与 $G\;a$ 相同,$F\;b$ 与 $G\;b$ 相同,那么整个旅程可以描述为:
$$G\;f::(b\rightarrow a)\rightarrow (G\;a\rightarrow G\;b)$$
这是一个『带有一个扭结的函子』。范畴的一个映射,它反转了态射的方向,这种映射被称为逆变函子。注意,逆变函子只不过来自相反范畴的一个常规函子。顺便说一下,这种常规函子——我们已经碰到很多了——被称为协变函子。
下面是 Haskell 中逆变函子的类型类的定义(实际上,是逆变自函子):
class Contravariant f where
    contramap :: (b -> a) -> (f a -> f b)
类型构造子 Op 是它的一个实例:
instance Contravariant (Op r) where
    -- (b -> a) -> Op r a -> Op r b
    contramap f g = g . f
注意,函数 f 将在 Op 的内容——函数g 之前(也就是右边)插入其自身。
如果你注意到面向 Op 的 contramap 只是参数颠倒了的函数复合运算符,那么它定义可以搞的更简洁一些。有一个特定的函数可以颠倒参数,它叫 flip:
flip :: (a -> b -> c) -> (b -> a -> c)
flip f y x = f x y
使用这个函数定义 contramap:
contramap = flip (.)副函子
我们已经看到了函数箭头运算符对于它的第一个参数是具有逆变函子性,而对于它的第二个参数则具有协变函子性。像这样的的怪兽,该叫它什么?如果是集合范畴,这种怪兽叫 副函子(Profunctor)。由于一个逆变函子等价于相反范畴的协变函子,因此可以这样定义一个副函子:
$$C^{OP}\times D\rightarrow Set$$
因为 Haskell 的类型与集合差不多,所以我们可将 Profunctor 这个名字应用于一个类型构造子 p,它接受两个参数,它对于第一个参数具有逆变函子性,对于第二个参数则具有协变函子性。下面是从 Data.Profunctor 库中抽取出来的相应的类型类:
class Profunctor p where
  dimap :: (a -> b) -> (c -> d) -> p b c -> p a d
  dimap f g = lmap f . rmap g
  lmap :: (a -> b) -> p b c -> p a c
  lmap f = dimap f id
  rmap :: (b -> c) -> p a b -> p a c
  rmap = dimap id
这三个函数只是默认的实现。就像 Bifunctor 那样,当声明 Profunctor 的一个实例时,你要么去实现 dimap,要么去实现 lmap。
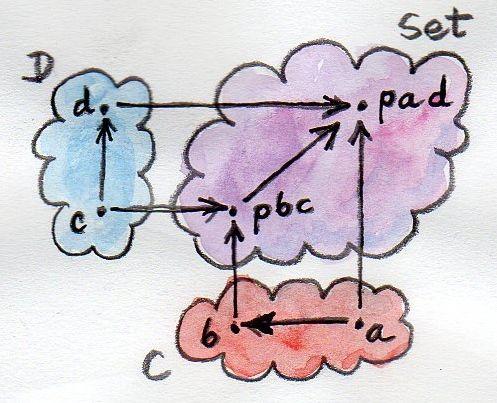
现在,我们宣称函数箭头运算符是 Profunctor 的一个实例了:
instance Profunctor (->) where
  dimap ab cd bc = cd . bc . ab
  lmap = flip (.)
  rmap = (.)
副函子在 Haskell 的 lens 库中被用到了。以后讲到端(End)与余端(Coend)时再来回顾它(译注:不知 End 与 Coend 对应的数学中文名词是谁)。
挑战
1. 证明数据类型
data Pair a b = Pair a b是一个二元函子,然后实现 Bifunctor 的全部方法,并使用等式推导去证明这些方法在使用时与它们的默认实现是兼容的。
2. 证明 Maybe 的标准定义与下面的 Maybe' 同构。
type Maybe' a = Either (Const () a) (Identity a)提示:为这两种数据类型定义两个映射,然后使用等式推导去证明这两个映射互逆。
3. 试试我称之为 PreList 的数据结构,它是 List 的前身。这个数据结构用一个类型参数 b 替换了递归:
data PreList a b = Nil | Cons a b如果用 PreList 代替 b,就可以得到 List(在讲不动点的时候就知道如何实现)。
证明 PreList 是 Bifunctor 的一个实例。
4. 证明一下数据类型是 a 与 b 上的二元函子:
data K2 c a b = K2 c

data Fst a b = Fst a

data Snd a b = Snd b
附加题:检查一下你的答案是否与 Conor McBride 的论文『Clowns to the Left of me, Jokers to the Right』相符。
5. 用非 Haskell 语言定义一个二元函子,为那种语言提供的泛型序对实现 bimap。
6. 应当将 std:map 视为作用于两个模板参数 Key 与 T 的二元函子或副函子吗?如果不可以,该怎么让它是?
-> 下一篇:『函数类型』
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论