Lucene系列一:搜索引擎核心理论
文章目录
一、为什么需要搜索引擎
问题1:数据库索引的原理是怎样的?
索引原理:对列值创建排序存储,数据结构={列值、行地址}。在有序数据列表中就可以利用二分查找快速找到要查找的行的地址,再根据地址直接取行数据。
问题2:索引的排序,是怎么排的?
数值列
时间列
文本列
问题3:在新闻标题列上建索引,当我们查询 标题 = ‘钓鱼岛’,数据库会怎么去查? 而当我们查询 标题 LIKE ‘%钓鱼岛%’ ,数据库该如何去查?
Like 时索引失效,全表扫描,数据量大时是噩梦。
问题4:在数据库中如何判断一个列是否可以建索引?
基本原则:
表经常被访问,且数据量很大,而每次查询的数据只占很小很小一部分
列的数据值分布范围广泛
列中包含大量空值
列被经常用在查询条件中(不能是包含在表达式中)
经过前面的问题的讨论,得出为什么需要搜索引擎的结论:
数据库适合结构化数据的精确查询,而不适合半结构化、非结构化数据的模糊查询及灵活搜索(特别是数据量大时),无法提供想要的实时性。
二、怎样建立反向索引
问题1:如何做才能快速查询到与苍老师有关的新闻?
分析:我们查询时,输入的是苍老师,想要得到标题或内容中包含“苍老师”的新闻列表。
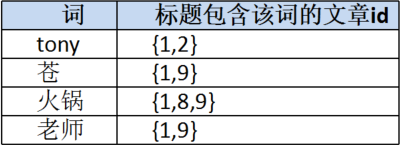
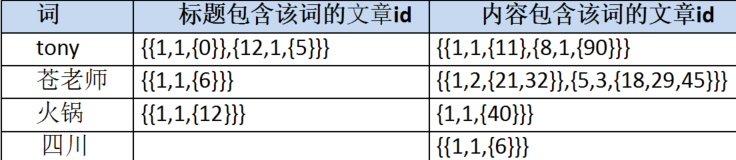
如果标题、内容列上都有一个这样的索引,里面能快速找到与苍老师关键字对应的文章id,再根据文章id就可以快速找到文章了。
标题列索引:
内容列索引:
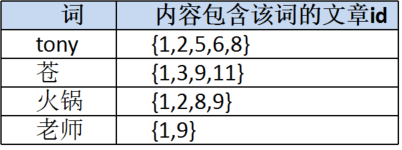
词到文章id的索引,这就是:反向索引(Inverted index)
问题2:问题1的标题列索引和内容列索引两个索引可以合并到一起,这样有什么好处?
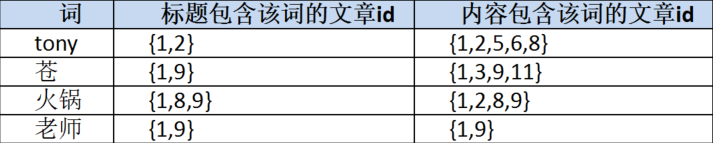
合并得好处是:可以减少访问数据库的次数
问题3:反向索引的记录数会不会很大?如果是英文的,最大是多少?如果是中文的,最大可能是多少?
英语单词的大致数量是10万个 汉字的总数已经超过了8万,而常用的只有3500字
《现代汉语规范词典》比《现代汉语词典》收录的字和词数量更多。前者是13000多字,72000多词,后者是11000多字,69000多词
结论:量不会很大,30万以内;通过这个索引找文章会很快
问题4:如何建立问题2中的这样一个反向索引?
数据示例:
新闻id:1
新闻标题:Tony 与苍老师一起吃火锅
新闻内容:2018年4月1日,Tony 在四川成都出席某活动时,碰巧主办方也邀请了苍老师来提高人气,在主办方的邀请下和苍老师一起吃了个火锅,很爽!
如果是英文文章,好不好分?
It’s one thing to find the 10 best documents to match your query
英文好分(有空格),中文则不好分。 但一定得要分,否则无法建立反向索引。
就必须写一套专门的程序来做这个事情:分词器
中文分词器原理:有个词的字典,对语句前后字进行组合,与字典匹配,歧义分析
总结:
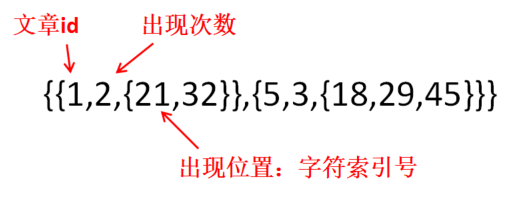
根据分词结果,我们创建反向索引,如下所示:
三、有了反向索引了,如何进行搜索?
如想搜索与 “tony OR 苍老师” 相关的新闻,步骤是怎样的?
步骤1: 对搜索输入进行分词
tony 、苍老师
步骤2: 在反向索引中找出包含tony、苍老师的文章列表
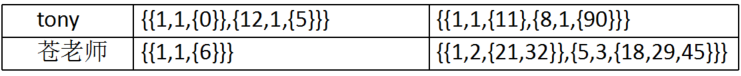
步骤3: 合并两个列表,排序输出
{1,12,8,5}
四、如何建立一个相关性评估模型?
利用出现次数来建立模型
规则1: 统计出现次数,根据次数从高到低排
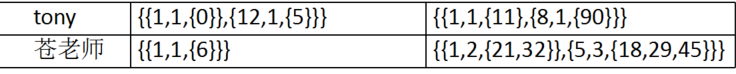
{{1,5},{5,3},{12,1},{8,1}}:文章1出现5次,文章5出现3次,文章12出现1次,文章8出现1次
问题1:标题中出现苍老师,与新闻的内容中出现苍老师,哪个是专门写苍老师的相关度高些?怎么做
规则2: 加入权重,标题权重10,内容权重1,计算权重得分,按高-低排序
{{1,23},{12,10},{5,3},{8,1}}
总结:利用出现次数来建立模型这个相关性模型很简单。有时排序会不是很准确。
复杂的相关性计算模型有:
tf-idf 词频-逆文档率模型
向量空间模型
贝叶斯概率模型,如: BM25
搜索引擎中会提供一种、或多种实现供选择使用,也会提供扩展。
电商网站中的搜索相关性计算会考虑更多,更复杂。
五、反向索引更新:数据更新时,索引是不是必须得更新?好更新吗?
更新情况分析:
问1:新增时,需要怎么更新?
问2:删除时,需要怎么更新?
问3:修改时,需要怎么更新?
六、反向索引是存储在内存中,还是磁盘中合适?
大的放磁盘,小的放内存,同时需要做持久化
七、搜索引擎需要支持精确搜索吗?需要支持像数据库一样的多条件AND OR 组合搜索吗?
如 类别 IN () 数值 > = < 时间
必须要,否则搜索引擎就没人用了
八、总结
1、搜索引擎是什么?
一套可对大量结构化、半结构化数据、非结构化文本类数据进行实时搜索的专门软件
最早应用于信息检索领域,经谷歌、百度等公司推出网页搜索而为大众广知。后又被各大电商网站采用来做网站的商品搜索。现广泛应用于各行业、互联网应用。是大型系统、网站架构师必备技能。
2、搜索引擎是用来解决什么问题的?
专门解决大量结构化、半结构化数据、非结构化文本类数据的实时检索问题。 这种实时搜索数据库做不了。
3、搜索引擎适合什么场景使用?
核心:大量结构化、半结构化、非结构化文本类数据的实时搜索
信息检索(如电子图书馆、电子档案馆)
网页搜索
内容提供网站的内容搜索(如 新闻、论坛、博客网站)
电子商务网站的商品搜索
如果你负责的系统数据量大,通过数据库检索慢,可以考虑用搜索引擎来专门负责检索。
4、搜索引擎由哪些核心部件构成?
数据源、分词器、反向索引(倒排索引)、相关性计算模型
5、搜索引擎的工作原理是怎样的?
1、从数据源加载数据,分词、建立反向索引
2、搜索时,对搜索输入进行分词,查找反向索引
3、计算相关性,排序,输出
6、要实现一个搜索引擎,需要实现哪些?
1、分词器
2、反向索引,索引存储
3、相关性计算模型
7、要去使用一个搜索引擎,需要搞清楚它的哪些方面?
1、分词器
2、反向索引建立、存储、更新
3、相关性计算模型
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论