[HDFS学习笔记]数据流操作
文章目录
写数据流程
注意:
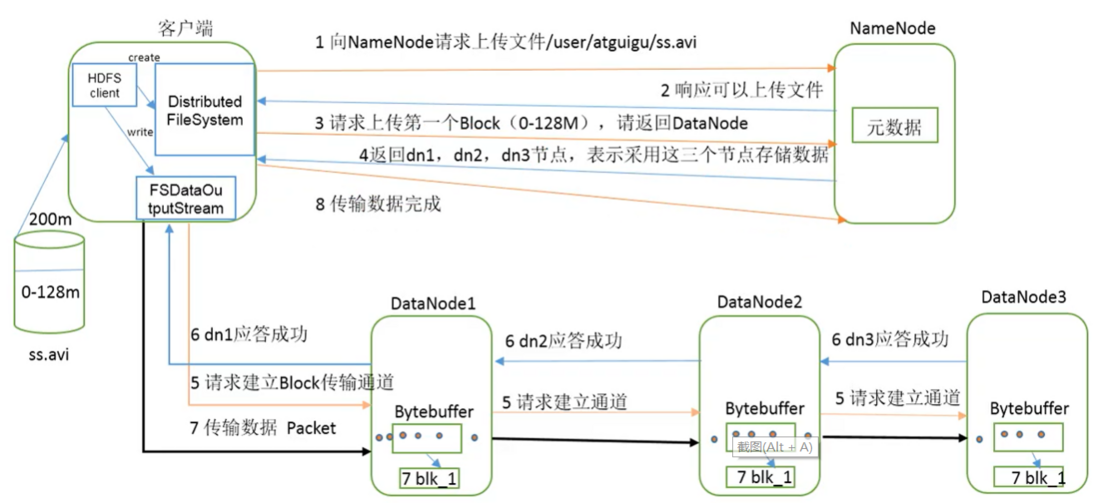
- 客户端先实例化一个分布式文件系统的类,并创建输出流
FSDataOutputStream的对象.
-
FSDataOutputStream会向NameNode请求上传文件到XXX路径 - NameNoed 会先做一系列检测,比如文件是否已存在,若存在则返回文件已存在的错误,用户是否有权限。若没有问题则返回可以上传的消息。
- 客户端需要知道自己应该把文件上传到哪个DataNode,因此依然由
FSDataOutputStream向NameNode 询问. - NameNode根据到客户端的节点距离 返回相应的DataNode及位置 如dn1,dn2,dn3三个节点(备份)
- 客户端向DataNode1请求建立Block传输通道,DataNode1收到请求后 向DataNode2同样发送建立通道请求,DataNode2也向DataNode3发送...
- DataNode 从后往前依次回应,最后返回给客户端
- 客户端开始以packet的形式传递数据给DataNode1, DataNode1把数据先存至内存队列ByteBuff当中,并将该数据序列化后存至本地Block,同时ByteBuffer的数据会传给DataNode2的ByteBuffer,...
- 数据接收完毕后 从后面依次应答 传递完毕,最后应答给客户端, 客户端再向NameNode回应 传输完成的消息
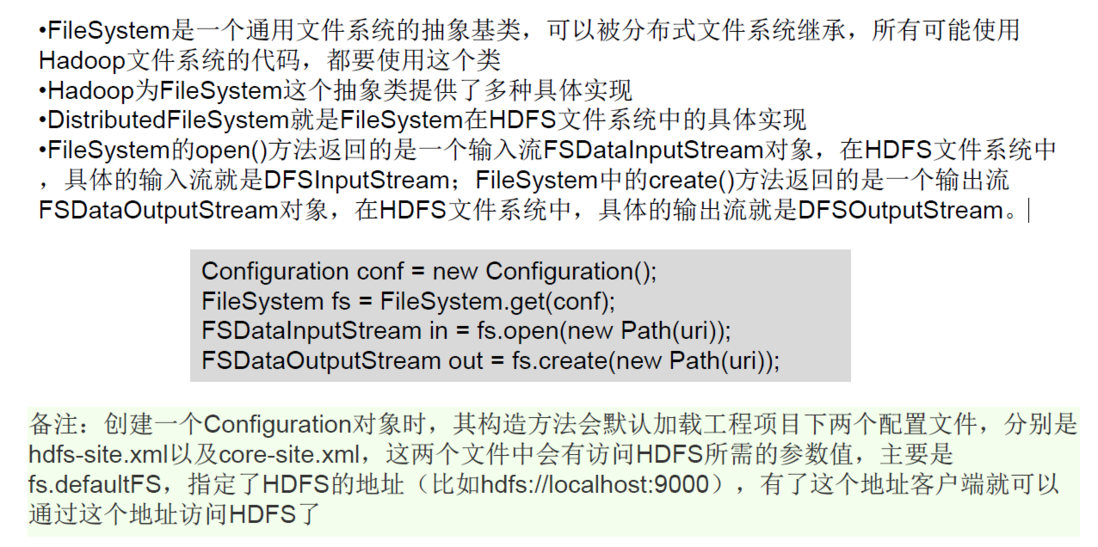
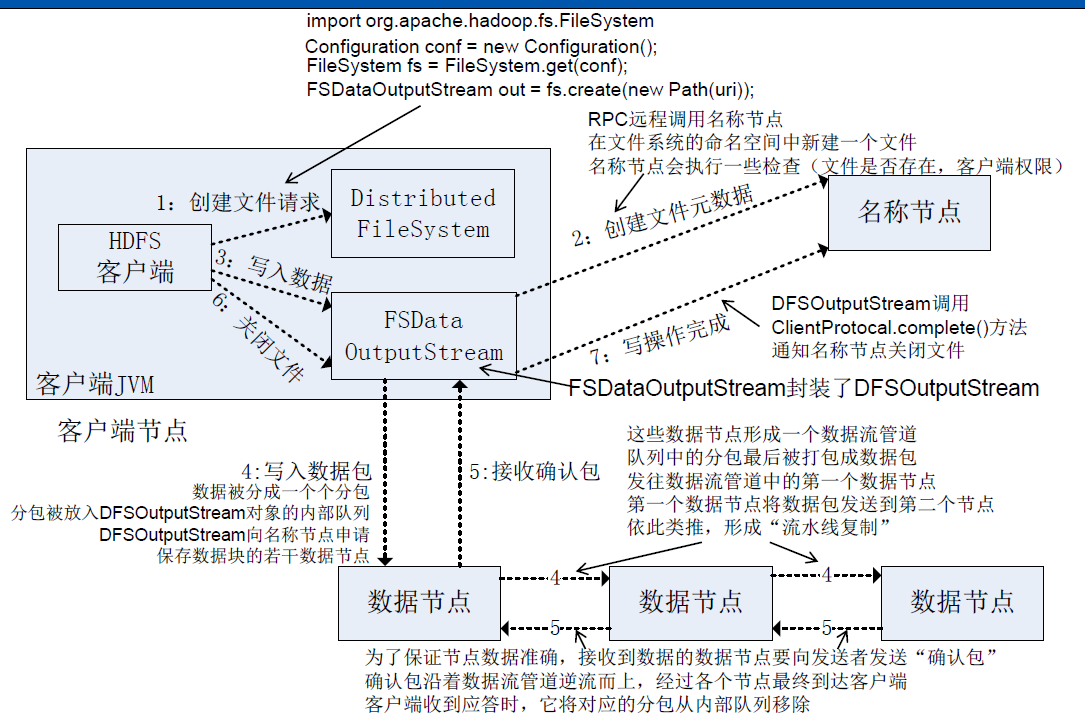
再从代码层面理解这个过程

读数据过程

1.先创建一个DFS实例,向NameNode发送下载请求
- NameNode 返回该文件的元数据,包括了数据块的起始位置
- 客户端向DataNode 请求读取数据块
- 如果需要的数据块在一台机器上 则一次传输就返回。若该数据块损坏或不在该DataNode上 则还需要去相应的DataNode以相同的方式请求数据
- 客户端收到数据后写入本地磁盘.
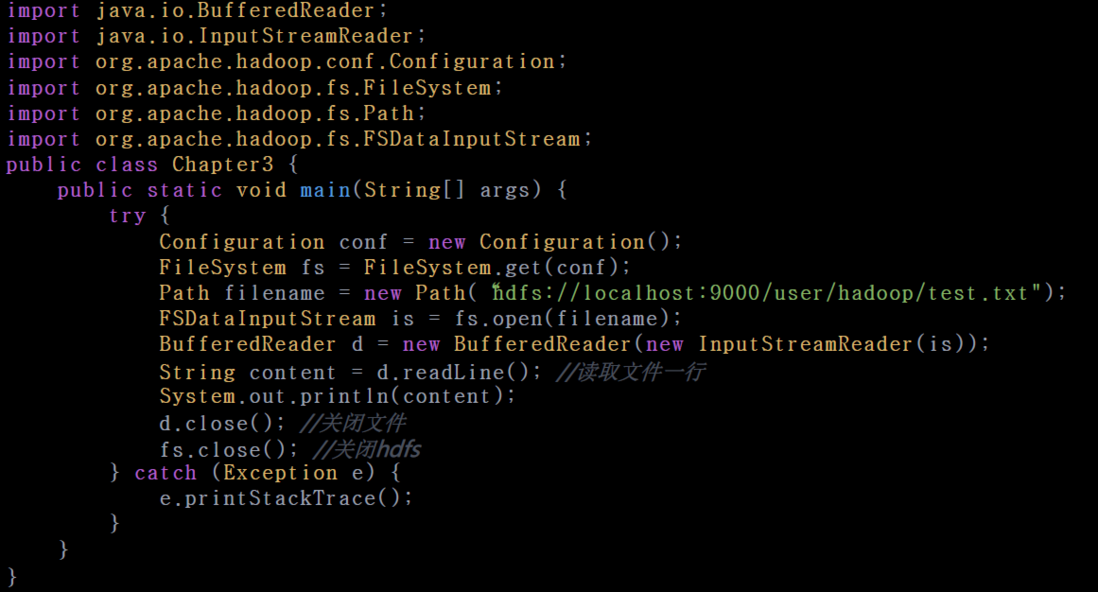
代码层面

节点距离计算
节点距离: 两个节点到达最小公共祖先的距离和
最小公共祖先 一般指 机架,集群的路由器
例子: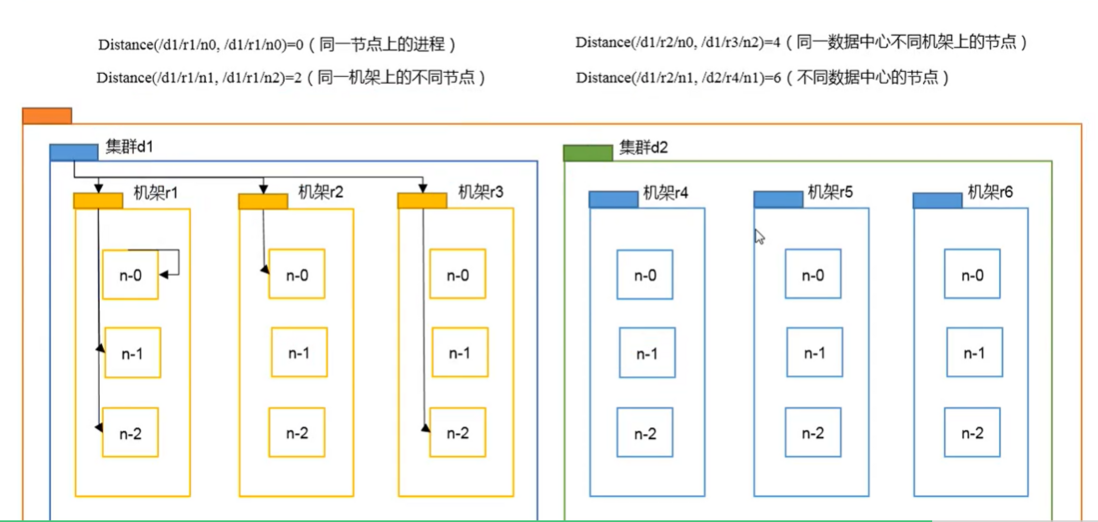
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论