前端面试
文章目录
Html5和CSS3
px、em、rem、vw、百分比的区别
px是固定单位,其他几种都是相对单位。当我们把电脑屏幕的分辨率调为1440*900时,css里设置的1px实际的物理尺寸就是屏幕宽度的1/1440。
em:默认字体大小的倍数。比如给元素设置font-size: 2em,这里的默认字体大小实际上是继承自父亲的大小,font-size: 2em表示当前元素字体大小是父亲的2倍。当给元素设置width: 2em,这里的默认字体大小是该元素自身的实际字体大小。
rem:根元素(html 节点)字体大小的倍数。比如一个元素设置 width: 2rem 表示该元素宽度为html节点的font-size 大小的2倍。 如果html未设置font-size的大小,默认是16px。
1vw 代表浏览器视口宽度的1%。
1% 对不同属性有不同的含义。 font-size: 200% 和font-size: 2em 一样,表示字体大小是默认(继承自父亲)字体大小的2倍。 line-height: 200% 表示行高是自己字体大小的2倍。 width: 100%表示自己content的宽度等于父亲content宽度的1倍。
需要注意的是chrome浏览器下文字最小是12px,设置低于12px的值最终也会展示12px。
常见的水平垂直居中实现方案
最简单的方案当然是flex布局
.father {
display: flex;
justify-content: center;
align-items: center;
}
.son {
...
}
绝对定位配合margin:auto,的实现方案
.father {
position: relative;}
.son {
position: absolute;
top: 0;
left: 0;
bottom: 0;
right: 0;
margin: auto;
}
绝对定位配合transform实现
.father {
position: relative;}
.son {
position: absolute;
top: 50%;
left: 50%;
transform: translate(-50%, -50%);
}
BFC问题
BFC:块格式上下文,是一块独立的渲染区域,内部元素不会影响外部的元素。
flex:1; 是哪些属性的缩写,对应的属性代表什么含义
flex: 1;在浏览器中查看分别是flex-grow(设置了对应元素的增长系数)、flex-shrink(指定了对应元素的收缩规则,只有在所有元素的默认宽度之和大于容器宽度时才会触发)、flex-basis(指定了对应元素在主轴上的大小)
隐藏元素的属性有哪些
display: none;
visibility: hidden;
opacity: 0;
Js相关
Js的基础类型,typeof和instanceof的区别
基础类型有:boolean、string、number、bigint、undefined、symbol、null。
typeof能识别所有的值类型,识别函数,能区分是否是引用类型。
instanceof用于检测构造函数的 prototype 属性是否出现在某个实例对象的原型链上。
数组的forEach和map方法有哪些区别?常用哪些方法去对数组进行增、删、改
forEach是对数组的每一个元素执行一次给定的函数。
map是创建一个新数组,该新数组由原数组的每个元素都调用一次提供的函数返回的值。
pop():删除数组后面的最后一个元素,返回值为被删除的那个元素。
push():将一个元素或多个元素添加到数组末尾,并返回新的长度。
shift():删除数组中的第一个元素,并返回被删除元素的值。
unshift():将一个或多个元素添加到数组的开头,并返回该数组的新长度。
splice():通过删除或替换现有元素或者原地添加新的元素来修改数组,并以数组形式返回被修改的内容。
reverse(): 反转数组。
闭包和作用域
闭包是作用域应用的特殊场景。 js中常见的作用域包括全局作用域、函数作用域、块级作用域。要知道js中自由变量的查找是在函数定义的地方,向上级作用域查找,不是在执行的地方。 常见的闭包使用有两种场景:一种是函数作为参数被传递;一种是函数作为返回值被返回。
实现一个类似关键字new功能的函数
在js中new关键字主要做了:首先创建一个空对象,这个对象会作为执行new构造函数之后返回的对象实例,将创建的空对象原型(__proto__)指向构造函数的prototype属性,同时将这个空对象赋值给构造函数内部的this,并执行构造函数逻辑,根据构造函数的执行逻辑,返回初始创建的对象或构造函数的显式返回值。
如何实现继承(原型和原型链)
使用class语法,用extends进行继承,或直接改变对象的__proto__指向。
箭头函数和普通函数有什么区别
箭头函数不会创建自身的this,只会从上一级继承this,箭头函数的this在定义的时候就已经确认了,之后不会改变。同时箭头函数无法作为构造函数使用,没有自身的prototype,也没有arguments。
浏览器的事件循环机制
首先要知道一件事,JavaScript是单线程的(指的是js引擎在执行代码的时候只有一个主线程,每次只能干一件事),同时还是非阻塞运行的(执行异步任务的时候,会先挂起相应任务,待异步返回结果再执行回调),这就要知道其事件的循环机制才能正确理解js代码的执行顺序。
在js代码执行时,会将对象存在堆(heap)中,在栈(stack)中存放一些基础类型变量和对象的指针。在执行方法时,会根据当前方法的执行上下文,来进行一个执行。对于普通函数就是正常的入栈出栈即可,涉及到异步任务的时候,js执行会将对应的任务放到事件队列中(微任务队列、宏任务队列)。
常见微任务:queueMicrotask、Promise、MutationObserve等。
常见宏任务:ajax、setTimeout、setInterval、script(js整体代码)、IO操作、UI交互、postMessage等。
故事件循环可以理解为是一个桥梁,连接着应用程序的js和系统调用之间的通道。其过程为:
执行一个宏任务(一般为一段script),若没有可选的宏任务,就直接处理微任务。
执行中遇到微任务,就将其添加到微任务的任务队列中。
执行中遇到宏任务,就将其提交到宏任务队列中。
执行完当前执行的宏任务后,去查询当前有无需要执行的微任务,有就执行
检查渲染,若需要渲染,浏览器执行渲染任务
渲染完毕后,Js线程会去执行下一个宏任务。。。(如此循环)
浏览器相关
跨域问题
由于浏览器同源策略(浏览器安全功能,它会阻止一个域与另一个域的内容进行交互,能有效防止XSS、CSRF攻击)的限制,非同源的请求会被限制。
解决跨域问题的方法:
配置nginx反向代理
使用jsonp方式(script方式)
使用图片
设置CORS(跨域资源共享)
利用iframe实现
WebSocket
几种浏览器存储方法及其优缺点
那么浏览器存储有哪些方法呢,主要有cookie、localStorage、sessionStorage
cookie属于文档对象模型DOM树根节点document,而 sessionStorage 和 localStorage 属于浏览器对象模型BOM的对象window
其中 sessionStorage 和 localStorage 是 HTML5 Web Storage API 提供的
sessionStorage:为每一个给定的源(given origin)维持一个独立的存储区域,该存储区域在页面会话期间可用(即只要浏览器处于打开状态,包括页面重新加载和恢复)
localStorage:同样的功能,但是在浏览器关闭,然后重新打开后数据仍然存在。
说说浏览器渲染页面的过程
首先输入一个网址,浏览器会向服务器发起DNS请求,得到对应的IP地址(会被缓存一段时间,后续访问就不用再去向服务器查询)。之后会进行TCP三次握手与服务器建立连接,连接建立后,浏览器会代表用户发送一个初始的GET请求,通常是请求一个HTML文件。服务器收到对应请求后 ,会根据相关的响应头和HTML内容进行回复。
一旦浏览器拿到了数据,就会开始解析信息,这个过程中,浏览器会根据HTML文件去构建DOM树,当遇到一些阻塞资源时(如同步加载的script标签)会去加载阻塞资源而停止当前DOM树构建(所以能够异步的或延迟加载的就尽量异步或延迟,同时页面的脚本还是越少越好)。在构建DOM树时,浏览器的主线程被占据着,不过浏览器的预加载扫描器会去请求高优先级的资源(如css、js、字体),预加载扫描器很好的优化了阻塞问题。接下来浏览器会处理CSS生成CSSDOM树,将CSS规则转换为可以理解和使用的样式映射,这个过程非常快(通常小于一次DNS查询所需时间)。有了DOM树和CSSDOM树,浏览器会将其组合生成一个Render树,计算样式或渲染树会从DOM的根节点开始构建,遍历每一个可见节点(将相关样式匹配到每一个可见节点,并根据CSS级联去的每个节点的计算样式)。接下来开始布局,该过程(依旧是从根节点开始)会确定所有节点的宽高和位置,最后通过渲染器将其在页面上绘制。绘制完成了,并不代表交互也都生效了,因为主线程可能还无法抽出时间去处理滚动、触摸等交互,要等到js加载完成,同时主线程空闲了整个页面才是正常可用的状态。

项目相关题
关于模块化
首先模块化的目的是将程序划分为一个个小的结构。在这些结构中编写自己的逻辑代码,有自己的作用域,不会影响到其他的结构。同时这些结构可以将自己希望暴露的函数、变量、对象等导出给其他结构使用,也可通过某种方式,将另外结构中的函数、变量、对象等导入使用。
微前端
随着项目的开发,会出现一个前端项目模块巨多的情况,不利于开发和维护。微前端就能帮助我们解决这个问题,帮我们实现了前端复杂项目的解耦,同时能做到跨团队和跨部门协同开发。
对于微前端,它与技术栈无关(主框架不限制介入应用的技术栈,微应用具有完全的自主权),各个微应用间仓库独立,每个微应用之间状态隔离,运行时状态不共享。
常见的微前端实现方案:
基于iframe的完全隔离,iframe是浏览器自带的功能,使用简单,隔离完美,不过它无法保持路由状态,页面一刷新状态就丢失,同时iframe中的状态无法突破对应的应用,同时整个应用是全量加载,速度慢。
基于single-spa路由劫持的方案。qiankun就是基于这种方案实现的,通过对single-spa做一层封装,根据执行环境的修改,来解析微应用的资源,实现了JS沙箱、样式隔离等特性。
借鉴WebComponent思想的micro-app,通过CustomElement结合自定义的ShadowDom,将微前端封装成一个类Web Component组件。
前端低代码的认识
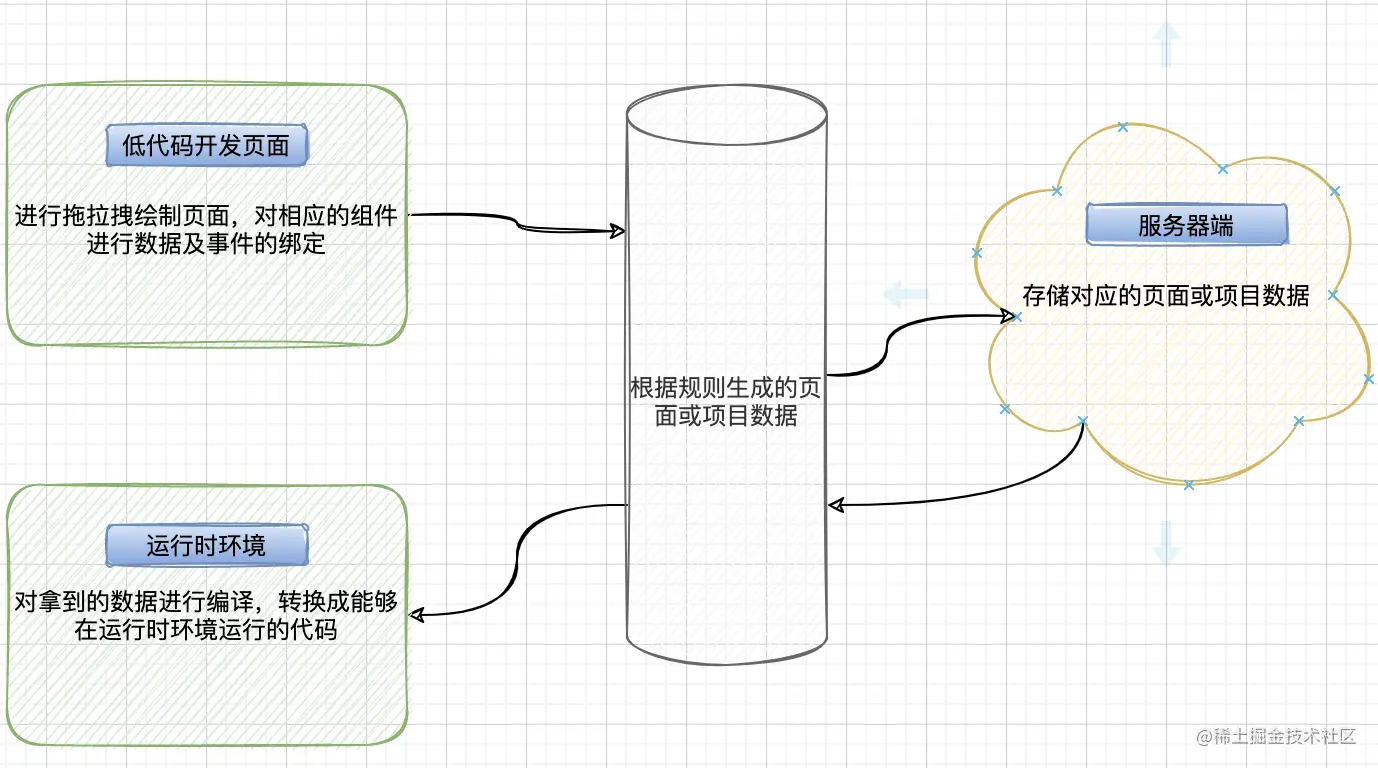
低代码平台一般提供一个可视化的编辑页面,供知晓低代码开发规则的人员进行编程,是一种声明式编程。
常见的低代码工作流程如图:
低代码的好处:
门槛低,所见即所得,上手容易
基于现成组件库开发,开发速度快
低代码的缺点:
灵活性差,只适合某些特定领域
调试困难,对使用者来说是个黑盒
对运行环境有一定要求,兼容性不好,低代码开发的兼容性完全取决于低代码平台的支持
前端权限设计思路
项目中,尤其是管理后台必不可少的一个环节就是权限设计。通常一个系统下的不同用户会对应不同的角色,不同角色会对应不同的组织。在进入到管理里后台的时候会去请求对应的权限接口,这个接口里有和后台约定好的权限标识内容,如果权限管理不是很复杂,可以将当前用户的所有权限标识一次性返回,前端进行一个持久化存储,之后根据规则处理即可。如果是个极为复杂的权限管理,甚至存在不同操作导致同一用户对应后续流程权限变化的情况,这里就建议用户首次登录管理后台时,获取的是最高一层权限,即可以看到的页面权限,之后在用户每次做了不同操作,切换页面的时候,根据约定好的规则,在页面路由切换的时候去请求下一个页面对应的权限(可以精确到每个交互动作),这样能更加精确的管理权限。
taro是如何将react代码转换成对应的小程序代码或其他平台代码
平时使用React JSX进行开发时,要知道React将其核心功能分成了三部分:React Core(负责处理核心API、与终端平台和渲染解耦,提供了createElement、createClass、Component、Children等方法)、React Renderer(渲染器,定义了React Tree如何构建以接轨不同平台,有React-dom、React-Natvie等)、React Reconciler(调和器,负责diff算法,接驳patch行为。为渲染器提供基础计算能力,主要有16版本之前的Stack Reconciler和16及其之后的Fiber Reconciler)。React团队将Reconciler作为一个单独的包发布,任何平台的渲染器函数只要在HostConfig(宿主配置)内置基本方法,就可以构造自己的渲染逻辑。有了react-reconciler的支持。Taro团队就是提供了taro-react(实现了HostConfig)包来连接react-reconciler和taro-runtime。开发者写的React代码,Taro通过CLI将代码进行webpack打包,taro实现了一套完整的DOM和BOM API在各个平台的适配,打包完之后,就可以将程序渲染到对应的平台上。
核心就在于对输入的源代码的语法分析,语法树构建,随后对语法树进行转换操作再解析生成目标代码的过程。
token可以放在cookie里吗?
当被问这个问题的时候,第一时间要想到安全问题。通常回答不可以,因为存在CSRF(跨站请求伪造)风险,攻击者可以冒用Cookie中的信息来发送恶意请求。解决CSRF问题,可以设置同源检测(Origin和Referer认证),也可以设置Samesite为Strict。最好嘛,就是不把token放在cookie里咯。
前端埋点的实现,说说看思路
对于埋点方案:一般分为手动埋点(侵入性强,和业务强关联,用于需要精确搜集并分析数据,不过该方式耗时耗力,且容易出现误差,后续要调整,成本较高)、可视化埋点(提供一个可视化的埋点控制台,只能在可视化平台已支持的页面进行埋点)、无埋点(就是全埋点,监控页面发生的一切行为,优点是前端只需要处理一次埋点脚本,不过数据量过大会产生大量的脏数据,需要后端进行数据清洗)。
埋点通常传采用img方式来上传,首先所有浏览器都支持Image对象,并且记录的过程很少出错,同时不存在跨域问题,请求Image也不会阻塞页面的渲染。建议使用1*1像素的GIF,其体积小。
现在的浏览器如果支持Navigator.sendBeacon(url, data)方法,优先使用该方法来实现,它的主要作用就是用于统计数据发送到web服务器。当然如果不支持的话就继续使用图片的方式来上传数据。
说说封装组件的思路
要考虑组件的灵活性、易用性、复用性。
常见的封装思路是,对于视图层面,如相似度高的视图,进行一个封装,提供部分参数方便使用者修改。对于业务复用度较高的,提取出业务组件。
性能优化题
什么情况下会重绘和回流,常见的改善方案
浏览器请求到对应页面资源的时候,会将HTML解析成DOM,把CSS解析成CSSDOM,然后将DOM和CSSDOM合并就产生了Render Tree。在有了渲染树之后,浏览器会根据流式布局模型来计算它们在页面上的大小和位置,最后将节点绘制在页面上。
那么当Render Tree中部分或全部元素的尺寸、结构、或某些属性发生改变,浏览器就会重新渲染页面,这个就是浏览器的回流。常见的回流操作有:页面的首次渲染、浏览器窗口尺寸改变、部分元素尺寸或位置变化、添加或删除可见的DOM、激活伪类、查询某些属性或调用方法(各种宽高的获取,滚动方法的执行等)。
当页面中的元素样式的改变不影响它在文档流的位置时(如color、background-color等),浏览器对应元素的样式,这个就是重绘。
可见:回流必将导致重绘,重绘不一定会引起回流。回流比重绘的代价更高。
常见改善方案:
在进行频繁操作的时候,使用防抖和节流来控制调用频率。
避免频繁操作DOM,可以利用DocumentFragment,来进行对应的DOM操作,将最后的结果添加到文档中。
灵活使用display: none属性,操作结束后将其显示出来,因为display的属性为none的元素上进行的DOM操作不会引发回流和重绘。
获取各种会引起重绘/回流的属性,尽量将其缓存起来,不要频繁的去获取。
对复杂动画采用绝对定位,使其脱离文档流,否则它会频繁的引起父元素及其后续元素的回流。
一次请求大量数据怎么优化,数据多导致渲染慢怎么优化
个人觉得这就是个伪命题,首先后端就不该一次把大量数据返回前端,但是会这么问,那么我们作为面试的就老老实实回答呗。
首先大量数据的接收,那么肯定是用异步的方式进行接收,对数据进行一个分片处理,可以拆分成一个个的小单元数据,通过自定义的属性进行关联。这样数据分片完成。接下来渲染的话,由于是大量数据,如果是长列表的话,这里就可以使用虚拟列表(当前页面需要渲染的数据拿到进行渲染,然后对前面一段范围及后面一段范围,监听对应的滚动数据来切换需要渲染的数据,这样始终要渲染的就是三部分)。当然还有别的渲染情况,比如echarts图标大量点位数据优化等。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论