计算机系统漫游 | 编码原理与编译系统
文章目录
信息=位序列+上下文
- 每个二进制数字0或1表示一个位(比特),八个位组成一个字节。由程序员通过编译器创建的文本文件称为源程序(如hello.c)。源程序实际上就是一个位序列,在位序列中,每一个、两个或四个字节表示一个文本字符。
- 字符编码
| 语言 | 字节关系 | 标准 |
|---|---|---|
| 英语 | 一个字节表示一个文本字符 | ASCII |
| 汉字 | 两个字节表示一个文本字符 | GB2312、BIG5、Unicode... |
下图为hello.c的ASCII码表示
有关编码的小知识:
GB2312编码:简体中文汉字编码国家标准,汉字采用双字节编码。
BIG5编码:台湾地区繁体中文标准字符集,采用双字节编码。
GBK编码:1995年发布的汉字编码国家标准,是对GB2312编码的扩充,对汉字采用双字节编码。包含国家标准GB13000-1中的全部中日韩汉字,和BIG5编码中的所有汉字。
GB18030编码:2000年发布的汉字编码国家标准,是对GBK编码的扩充,覆盖中文、日文、朝鲜语和中国少数民族文字。GB18030字符集采用单字节、双字节和四字节三种方式对字符编码。兼容GBK和GB2312字符集。
Unicode编码:国际标准字符集,它将世界各种语言的每个字符定义一个唯一的编码,以满足跨语言、跨平台的文本信息转换。
- 只有ASCII字符构成的文件称为文本文件,其他所有文件都称为二进制文件。
- 由上,系统中所有信息,从文件、程序到数据,都是由位序列表示。
- 区分不同数据对象的唯一方法:看数据对象的上下文。在不同上下文中,一个字节序列可能表示整数、浮点数、字符串、机器指令等。
编译系统的工作过程
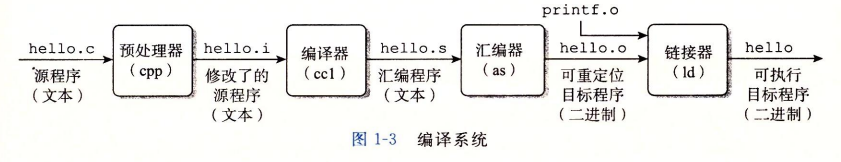
- 在系统上运行hello.c程序时,先将c语句转化为汇编语句,再转化为一系列低级机器语言指令,最后将这些指令按照一种称为可执行目标程序的格式打好包,以二进制磁盘文件形式存放起来。
- 从源程序hello.c到可执行目标文件hello,此过程共分为四个阶段完成。执行这四个阶段的程序(预处理器、编译器、汇编器、链接器)构成编译系统。
- 预处理阶段
预处理过程主要处理那些源代码中以#开始的预编译指令,主要处理规则如下:
①将所有的#define删除,并且展开所有的宏定义;
②处理所有条件编译指令,如#if,#ifdef等;
③处理#include预编译指令,将引用的头文件插入到该预编译指令的位置。
④删除所有的注释//和 /**/;
⑤添加行号和文件标识,如#2 “hello.c” 2,以便于编译时编译器产生调试用的行号信息及用于编译时产生编译错误或警告时能够显示行号信息;
⑥保留所有的#pragma编译器指令,因为编译器须要使用它们;
- 编译阶段
生成汇编语言文件(汇编语言:以文本格式描述低级机器指令),如下图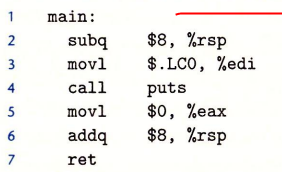
- 汇编阶段
将汇编语言翻译成机器指令(机器指令是一串二进制码)
- 链接阶段
链接器ld将各个目标文件组装在一起,解决符号依赖、库依赖关系,并生成可执行文件。
如hello.c程序调用了printf函数,而printf函数存在于一个printf.o的文件中,而ld就负责将这个文件以某种形式合并到hello.o程序中,并最终得到hello文件。

评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论