Python3 爬虫自学笔记,爬取小说(四)
文章目录
感谢作者分享-http://bjbsair.com/2020-04-07...
郑智化-别哭,我最爱的人.mp3
03:32.34200000000001
来自居家IT男
v1.2及之前版本主要是爬取小说单章节内容并下载到本地保存为txt文件,主要熟悉了Python爬虫的基本代码,但缺少实用性。
个人观点:对于小说爬取,主要有两个方面可以尝试进一步优化,一是直接在可提供下载txt链接的小说网站直接爬取txt文件,可节省代码运行时间;二是对于还在更新中的小说,不定时检测小说更新状态,并推送最新更新信息,可尝试通过邮件、微信、短信等方式推送信息。
1 功能及版本说明
功能:提供小说名称,检索小说网站,爬取网站小说txt链接,并下载。
版本:v1.4
更新说明:
在可提供txt链接的小说网站进行爬取小说链接进行下载。
2 开发环境
开发环境:Python3和PyCharm;
3 网站介绍及分析
网上搜索了一下,可实现小说txt下载的网站较多,这里以无限小说网为例,网址为:https://www.555x.org/。
选择一本小说,其小说主页面网址为:https://www.555x.org/html/xua...;下载页面网址为:https://www.555x.org/down/160...。由此可以看出,每一本小说有唯一对应编号,《卡徒》的编号为16089。

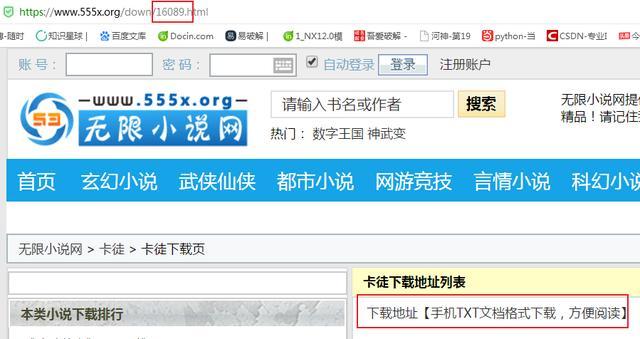
查看下载地址源码,具体如下:

从图中可以看出,小说txt下载链接为:https://www.555x.org/home/dow...,其代码结构很简单,网址中"16089"编号代表小说《卡徒》,网址中其他固定不变,只改变最后编号可以对其他小说进行下载。
尝试改变了一下编号,发现"16090"编号是小说《调教初唐》,"16088"编号书籍不存在,由此可以尝试对全站小说尝试进行下载。
4 编码思路
1) 提供小说名称;
2) 在小说网站检索小说,提取小说对应编号;
3) 下载小说;
5 代码实现(1)
实现下说下载的代码:
if __name__ == "__main__":
    start_time = time.time()
    r = requests.get("https://www.555x.org/home/down/txt/id/16089")
    print(r.status_code)
    print(r.encoding)
    with open("a.txt","a",encoding="ISO-8859-1") as f:
        f.write(r.text)
    end_time = time.time()
    print("下载时间:" + str(round(end_time - start_time))  + "s")
非完整代码,后续其他功能尝试成功后会陆续更新。
6 代码问题汇总
小说下载后保存下来的txt为乱码,查看下载网址反馈的编码格式为ISO-8859-1,在写入本地txt时进行编码格式定义。
7 相关学习知识点
小说网站编码格式的查看:r.encoding;
8 结束语
本次代码只是实现了根据小说下载链接对小说进行下载,代码较简单;在之后要完善小说的检索代码,即提供输入窗口,输入小说名称,在网站检索小说,提取下载链接。
将此次编码的过程及源码分享给大家,供大家参考。对于错误的地方,或有更好的建议,希望大家提出来,不胜感激!感谢作者分享-http://bjbsair.com/2020-04-07...
郑智化-别哭,我最爱的人.mp3
03:32.34200000000001
来自居家IT男
v1.2及之前版本主要是爬取小说单章节内容并下载到本地保存为txt文件,主要熟悉了Python爬虫的基本代码,但缺少实用性。
个人观点:对于小说爬取,主要有两个方面可以尝试进一步优化,一是直接在可提供下载txt链接的小说网站直接爬取txt文件,可节省代码运行时间;二是对于还在更新中的小说,不定时检测小说更新状态,并推送最新更新信息,可尝试通过邮件、微信、短信等方式推送信息。
1 功能及版本说明
功能:提供小说名称,检索小说网站,爬取网站小说txt链接,并下载。
版本:v1.4
更新说明:
在可提供txt链接的小说网站进行爬取小说链接进行下载。
2 开发环境
开发环境:Python3和PyCharm;
3 网站介绍及分析
网上搜索了一下,可实现小说txt下载的网站较多,这里以无限小说网为例,网址为:https://www.555x.org/。
选择一本小说,其小说主页面网址为:https://www.555x.org/html/xua...;下载页面网址为:https://www.555x.org/down/160...。由此可以看出,每一本小说有唯一对应编号,《卡徒》的编号为16089。
查看下载地址源码,具体如下:
从图中可以看出,小说txt下载链接为:https://www.555x.org/home/dow...,其代码结构很简单,网址中"16089"编号代表小说《卡徒》,网址中其他固定不变,只改变最后编号可以对其他小说进行下载。
尝试改变了一下编号,发现"16090"编号是小说《调教初唐》,"16088"编号书籍不存在,由此可以尝试对全站小说尝试进行下载。
4 编码思路
1) 提供小说名称;
2) 在小说网站检索小说,提取小说对应编号;
3) 下载小说;
5 代码实现(1)
实现下说下载的代码:
if __name__ == "__main__":
    start_time = time.time()
    r = requests.get("https://www.555x.org/home/down/txt/id/16089")
    print(r.status_code)
    print(r.encoding)
    with open("a.txt","a",encoding="ISO-8859-1") as f:
        f.write(r.text)
    end_time = time.time()
    print("下载时间:" + str(round(end_time - start_time))  + "s")
非完整代码,后续其他功能尝试成功后会陆续更新。
6 代码问题汇总
小说下载后保存下来的txt为乱码,查看下载网址反馈的编码格式为ISO-8859-1,在写入本地txt时进行编码格式定义。
7 相关学习知识点
小说网站编码格式的查看:r.encoding;
8 结束语
本次代码只是实现了根据小说下载链接对小说进行下载,代码较简单;在之后要完善小说的检索代码,即提供输入窗口,输入小说名称,在网站检索小说,提取下载链接。
将此次编码的过程及源码分享给大家,供大家参考。对于错误的地方,或有更好的建议,希望大家提出来,不胜感激!感谢作者分享-http://bjbsair.com/2020-04-07...
郑智化-别哭,我最爱的人.mp3
03:32.34200000000001
来自居家IT男
v1.2及之前版本主要是爬取小说单章节内容并下载到本地保存为txt文件,主要熟悉了Python爬虫的基本代码,但缺少实用性。
个人观点:对于小说爬取,主要有两个方面可以尝试进一步优化,一是直接在可提供下载txt链接的小说网站直接爬取txt文件,可节省代码运行时间;二是对于还在更新中的小说,不定时检测小说更新状态,并推送最新更新信息,可尝试通过邮件、微信、短信等方式推送信息。
1 功能及版本说明
功能:提供小说名称,检索小说网站,爬取网站小说txt链接,并下载。
版本:v1.4
更新说明:
在可提供txt链接的小说网站进行爬取小说链接进行下载。
2 开发环境
开发环境:Python3和PyCharm;
3 网站介绍及分析
网上搜索了一下,可实现小说txt下载的网站较多,这里以无限小说网为例,网址为:https://www.555x.org/。
选择一本小说,其小说主页面网址为:https://www.555x.org/html/xua...;下载页面网址为:https://www.555x.org/down/160...。由此可以看出,每一本小说有唯一对应编号,《卡徒》的编号为16089。
查看下载地址源码,具体如下:
从图中可以看出,小说txt下载链接为:https://www.555x.org/home/dow...,其代码结构很简单,网址中"16089"编号代表小说《卡徒》,网址中其他固定不变,只改变最后编号可以对其他小说进行下载。
尝试改变了一下编号,发现"16090"编号是小说《调教初唐》,"16088"编号书籍不存在,由此可以尝试对全站小说尝试进行下载。
4 编码思路
1) 提供小说名称;
2) 在小说网站检索小说,提取小说对应编号;
3) 下载小说;
5 代码实现(1)
实现下说下载的代码:
if __name__ == "__main__":
    start_time = time.time()
    r = requests.get("https://www.555x.org/home/down/txt/id/16089")
    print(r.status_code)
    print(r.encoding)
    with open("a.txt","a",encoding="ISO-8859-1") as f:
        f.write(r.text)
    end_time = time.time()
    print("下载时间:" + str(round(end_time - start_time))  + "s")
非完整代码,后续其他功能尝试成功后会陆续更新。
6 代码问题汇总
小说下载后保存下来的txt为乱码,查看下载网址反馈的编码格式为ISO-8859-1,在写入本地txt时进行编码格式定义。
7 相关学习知识点
小说网站编码格式的查看:r.encoding;
8 结束语
本次代码只是实现了根据小说下载链接对小说进行下载,代码较简单;在之后要完善小说的检索代码,即提供输入窗口,输入小说名称,在网站检索小说,提取下载链接。
将此次编码的过程及源码分享给大家,供大家参考。对于错误的地方,或有更好的建议,希望大家提出来,不胜感激!感谢作者分享-http://bjbsair.com/2020-04-07...
郑智化-别哭,我最爱的人.mp3
03:32.34200000000001
来自居家IT男
v1.2及之前版本主要是爬取小说单章节内容并下载到本地保存为txt文件,主要熟悉了Python爬虫的基本代码,但缺少实用性。
个人观点:对于小说爬取,主要有两个方面可以尝试进一步优化,一是直接在可提供下载txt链接的小说网站直接爬取txt文件,可节省代码运行时间;二是对于还在更新中的小说,不定时检测小说更新状态,并推送最新更新信息,可尝试通过邮件、微信、短信等方式推送信息。
1 功能及版本说明
功能:提供小说名称,检索小说网站,爬取网站小说txt链接,并下载。
版本:v1.4
更新说明:
在可提供txt链接的小说网站进行爬取小说链接进行下载。
2 开发环境
开发环境:Python3和PyCharm;
3 网站介绍及分析
网上搜索了一下,可实现小说txt下载的网站较多,这里以无限小说网为例,网址为:https://www.555x.org/。
选择一本小说,其小说主页面网址为:https://www.555x.org/html/xua...;下载页面网址为:https://www.555x.org/down/160...。由此可以看出,每一本小说有唯一对应编号,《卡徒》的编号为16089。
查看下载地址源码,具体如下:
从图中可以看出,小说txt下载链接为:https://www.555x.org/home/dow...,其代码结构很简单,网址中"16089"编号代表小说《卡徒》,网址中其他固定不变,只改变最后编号可以对其他小说进行下载。
尝试改变了一下编号,发现"16090"编号是小说《调教初唐》,"16088"编号书籍不存在,由此可以尝试对全站小说尝试进行下载。
4 编码思路
1) 提供小说名称;
2) 在小说网站检索小说,提取小说对应编号;
3) 下载小说;
5 代码实现(1)
实现下说下载的代码:
if __name__ == "__main__":
    start_time = time.time()
    r = requests.get("https://www.555x.org/home/down/txt/id/16089")
    print(r.status_code)
    print(r.encoding)
    with open("a.txt","a",encoding="ISO-8859-1") as f:
        f.write(r.text)
    end_time = time.time()
    print("下载时间:" + str(round(end_time - start_time))  + "s")
非完整代码,后续其他功能尝试成功后会陆续更新。
6 代码问题汇总
小说下载后保存下来的txt为乱码,查看下载网址反馈的编码格式为ISO-8859-1,在写入本地txt时进行编码格式定义。
7 相关学习知识点
小说网站编码格式的查看:r.encoding;
8 结束语
本次代码只是实现了根据小说下载链接对小说进行下载,代码较简单;在之后要完善小说的检索代码,即提供输入窗口,输入小说名称,在网站检索小说,提取下载链接。
将此次编码的过程及源码分享给大家,供大家参考。对于错误的地方,或有更好的建议,希望大家提出来,不胜感激!感谢作者分享-http://bjbsair.com/2020-04-07...
郑智化-别哭,我最爱的人.mp3
03:32.34200000000001
来自居家IT男
v1.2及之前版本主要是爬取小说单章节内容并下载到本地保存为txt文件,主要熟悉了Python爬虫的基本代码,但缺少实用性。
个人观点:对于小说爬取,主要有两个方面可以尝试进一步优化,一是直接在可提供下载txt链接的小说网站直接爬取txt文件,可节省代码运行时间;二是对于还在更新中的小说,不定时检测小说更新状态,并推送最新更新信息,可尝试通过邮件、微信、短信等方式推送信息。
1 功能及版本说明
功能:提供小说名称,检索小说网站,爬取网站小说txt链接,并下载。
版本:v1.4
更新说明:
在可提供txt链接的小说网站进行爬取小说链接进行下载。
2 开发环境
开发环境:Python3和PyCharm;
3 网站介绍及分析
网上搜索了一下,可实现小说txt下载的网站较多,这里以无限小说网为例,网址为:https://www.555x.org/。
选择一本小说,其小说主页面网址为:https://www.555x.org/html/xua...;下载页面网址为:https://www.555x.org/down/160...。由此可以看出,每一本小说有唯一对应编号,《卡徒》的编号为16089。
查看下载地址源码,具体如下:
从图中可以看出,小说txt下载链接为:https://www.555x.org/home/dow...,其代码结构很简单,网址中"16089"编号代表小说《卡徒》,网址中其他固定不变,只改变最后编号可以对其他小说进行下载。
尝试改变了一下编号,发现"16090"编号是小说《调教初唐》,"16088"编号书籍不存在,由此可以尝试对全站小说尝试进行下载。
4 编码思路
1) 提供小说名称;
2) 在小说网站检索小说,提取小说对应编号;
3) 下载小说;
5 代码实现(1)
实现下说下载的代码:
if __name__ == "__main__":
    start_time = time.time()
    r = requests.get("https://www.555x.org/home/down/txt/id/16089")
    print(r.status_code)
    print(r.encoding)
    with open("a.txt","a",encoding="ISO-8859-1") as f:
        f.write(r.text)
    end_time = time.time()
    print("下载时间:" + str(round(end_time - start_time))  + "s")
非完整代码,后续其他功能尝试成功后会陆续更新。
6 代码问题汇总
小说下载后保存下来的txt为乱码,查看下载网址反馈的编码格式为ISO-8859-1,在写入本地txt时进行编码格式定义。
7 相关学习知识点
小说网站编码格式的查看:r.encoding;
8 结束语
本次代码只是实现了根据小说下载链接对小说进行下载,代码较简单;在之后要完善小说的检索代码,即提供输入窗口,输入小说名称,在网站检索小说,提取下载链接。
将此次编码的过程及源码分享给大家,供大家参考。对于错误的地方,或有更好的建议,希望大家提出来,不胜感激!感谢作者分享-http://bjbsair.com/2020-04-07...
郑智化-别哭,我最爱的人.mp3
03:32.34200000000001
来自居家IT男
v1.2及之前版本主要是爬取小说单章节内容并下载到本地保存为txt文件,主要熟悉了Python爬虫的基本代码,但缺少实用性。
个人观点:对于小说爬取,主要有两个方面可以尝试进一步优化,一是直接在可提供下载txt链接的小说网站直接爬取txt文件,可节省代码运行时间;二是对于还在更新中的小说,不定时检测小说更新状态,并推送最新更新信息,可尝试通过邮件、微信、短信等方式推送信息。
1 功能及版本说明
功能:提供小说名称,检索小说网站,爬取网站小说txt链接,并下载。
版本:v1.4
更新说明:
在可提供txt链接的小说网站进行爬取小说链接进行下载。
2 开发环境
开发环境:Python3和PyCharm;
3 网站介绍及分析
网上搜索了一下,可实现小说txt下载的网站较多,这里以无限小说网为例,网址为:https://www.555x.org/。
选择一本小说,其小说主页面网址为:https://www.555x.org/html/xua...;下载页面网址为:https://www.555x.org/down/160...。由此可以看出,每一本小说有唯一对应编号,《卡徒》的编号为16089。
查看下载地址源码,具体如下:
从图中可以看出,小说txt下载链接为:https://www.555x.org/home/dow...,其代码结构很简单,网址中"16089"编号代表小说《卡徒》,网址中其他固定不变,只改变最后编号可以对其他小说进行下载。
尝试改变了一下编号,发现"16090"编号是小说《调教初唐》,"16088"编号书籍不存在,由此可以尝试对全站小说尝试进行下载。
4 编码思路
1) 提供小说名称;
2) 在小说网站检索小说,提取小说对应编号;
3) 下载小说;
5 代码实现(1)
实现下说下载的代码:
if __name__ == "__main__":
    start_time = time.time()
    r = requests.get("https://www.555x.org/home/down/txt/id/16089")
    print(r.status_code)
    print(r.encoding)
    with open("a.txt","a",encoding="ISO-8859-1") as f:
        f.write(r.text)
    end_time = time.time()
    print("下载时间:" + str(round(end_time - start_time))  + "s")
非完整代码,后续其他功能尝试成功后会陆续更新。
6 代码问题汇总
小说下载后保存下来的txt为乱码,查看下载网址反馈的编码格式为ISO-8859-1,在写入本地txt时进行编码格式定义。
7 相关学习知识点
小说网站编码格式的查看:r.encoding;
8 结束语
本次代码只是实现了根据小说下载链接对小说进行下载,代码较简单;在之后要完善小说的检索代码,即提供输入窗口,输入小说名称,在网站检索小说,提取下载链接。
将此次编码的过程及源码分享给大家,供大家参考。对于错误的地方,或有更好的建议,希望大家提出来,不胜感激!感谢作者分享-http://bjbsair.com/2020-04-07...
郑智化-别哭,我最爱的人.mp3
03:32.34200000000001
来自居家IT男
v1.2及之前版本主要是爬取小说单章节内容并下载到本地保存为txt文件,主要熟悉了Python爬虫的基本代码,但缺少实用性。
个人观点:对于小说爬取,主要有两个方面可以尝试进一步优化,一是直接在可提供下载txt链接的小说网站直接爬取txt文件,可节省代码运行时间;二是对于还在更新中的小说,不定时检测小说更新状态,并推送最新更新信息,可尝试通过邮件、微信、短信等方式推送信息。
1 功能及版本说明
功能:提供小说名称,检索小说网站,爬取网站小说txt链接,并下载。
版本:v1.4
更新说明:
在可提供txt链接的小说网站进行爬取小说链接进行下载。
2 开发环境
开发环境:Python3和PyCharm;
3 网站介绍及分析
网上搜索了一下,可实现小说txt下载的网站较多,这里以无限小说网为例,网址为:https://www.555x.org/。
选择一本小说,其小说主页面网址为:https://www.555x.org/html/xua...;下载页面网址为:https://www.555x.org/down/160...。由此可以看出,每一本小说有唯一对应编号,《卡徒》的编号为16089。
查看下载地址源码,具体如下:
从图中可以看出,小说txt下载链接为:https://www.555x.org/home/dow...,其代码结构很简单,网址中"16089"编号代表小说《卡徒》,网址中其他固定不变,只改变最后编号可以对其他小说进行下载。
尝试改变了一下编号,发现"16090"编号是小说《调教初唐》,"16088"编号书籍不存在,由此可以尝试对全站小说尝试进行下载。
4 编码思路
1) 提供小说名称;
2) 在小说网站检索小说,提取小说对应编号;
3) 下载小说;
5 代码实现(1)
实现下说下载的代码:
if __name__ == "__main__":
    start_time = time.time()
    r = requests.get("https://www.555x.org/home/down/txt/id/16089")
    print(r.status_code)
    print(r.encoding)
    with open("a.txt","a",encoding="ISO-8859-1") as f:
        f.write(r.text)
    end_time = time.time()
    print("下载时间:" + str(round(end_time - start_time))  + "s")
非完整代码,后续其他功能尝试成功后会陆续更新。
6 代码问题汇总
小说下载后保存下来的txt为乱码,查看下载网址反馈的编码格式为ISO-8859-1,在写入本地txt时进行编码格式定义。
7 相关学习知识点
小说网站编码格式的查看:r.encoding;
8 结束语
本次代码只是实现了根据小说下载链接对小说进行下载,代码较简单;在之后要完善小说的检索代码,即提供输入窗口,输入小说名称,在网站检索小说,提取下载链接。
将此次编码的过程及源码分享给大家,供大家参考。对于错误的地方,或有更好的建议,希望大家提出来,不胜感激!感谢作者分享-http://bjbsair.com/2020-04-07...
郑智化-别哭,我最爱的人.mp3
03:32.34200000000001
来自居家IT男
v1.2及之前版本主要是爬取小说单章节内容并下载到本地保存为txt文件,主要熟悉了Python爬虫的基本代码,但缺少实用性。
个人观点:对于小说爬取,主要有两个方面可以尝试进一步优化,一是直接在可提供下载txt链接的小说网站直接爬取txt文件,可节省代码运行时间;二是对于还在更新中的小说,不定时检测小说更新状态,并推送最新更新信息,可尝试通过邮件、微信、短信等方式推送信息。
1 功能及版本说明
功能:提供小说名称,检索小说网站,爬取网站小说txt链接,并下载。
版本:v1.4
更新说明:
在可提供txt链接的小说网站进行爬取小说链接进行下载。
2 开发环境
开发环境:Python3和PyCharm;
3 网站介绍及分析
网上搜索了一下,可实现小说txt下载的网站较多,这里以无限小说网为例,网址为:https://www.555x.org/。
选择一本小说,其小说主页面网址为:https://www.555x.org/html/xua...;下载页面网址为:https://www.555x.org/down/160...。由此可以看出,每一本小说有唯一对应编号,《卡徒》的编号为16089。
查看下载地址源码,具体如下:
从图中可以看出,小说txt下载链接为:https://www.555x.org/home/dow...,其代码结构很简单,网址中"16089"编号代表小说《卡徒》,网址中其他固定不变,只改变最后编号可以对其他小说进行下载。
尝试改变了一下编号,发现"16090"编号是小说《调教初唐》,"16088"编号书籍不存在,由此可以尝试对全站小说尝试进行下载。
4 编码思路
1) 提供小说名称;
2) 在小说网站检索小说,提取小说对应编号;
3) 下载小说;
5 代码实现(1)
实现下说下载的代码:
if __name__ == "__main__":
    start_time = time.time()
    r = requests.get("https://www.555x.org/home/down/txt/id/16089")
    print(r.status_code)
    print(r.encoding)
    with open("a.txt","a",encoding="ISO-8859-1") as f:
        f.write(r.text)
    end_time = time.time()
    print("下载时间:" + str(round(end_time - start_time))  + "s")
非完整代码,后续其他功能尝试成功后会陆续更新。
6 代码问题汇总
小说下载后保存下来的txt为乱码,查看下载网址反馈的编码格式为ISO-8859-1,在写入本地txt时进行编码格式定义。
7 相关学习知识点
小说网站编码格式的查看:r.encoding;
8 结束语
本次代码只是实现了根据小说下载链接对小说进行下载,代码较简单;在之后要完善小说的检索代码,即提供输入窗口,输入小说名称,在网站检索小说,提取下载链接。
将此次编码的过程及源码分享给大家,供大家参考。对于错误的地方,或有更好的建议,希望大家提出来,不胜感激!感谢作者分享-http://bjbsair.com/2020-04-07...
郑智化-别哭,我最爱的人.mp3
03:32.34200000000001
来自居家IT男
v1.2及之前版本主要是爬取小说单章节内容并下载到本地保存为txt文件,主要熟悉了Python爬虫的基本代码,但缺少实用性。
个人观点:对于小说爬取,主要有两个方面可以尝试进一步优化,一是直接在可提供下载txt链接的小说网站直接爬取txt文件,可节省代码运行时间;二是对于还在更新中的小说,不定时检测小说更新状态,并推送最新更新信息,可尝试通过邮件、微信、短信等方式推送信息。
1 功能及版本说明
功能:提供小说名称,检索小说网站,爬取网站小说txt链接,并下载。
版本:v1.4
更新说明:
在可提供txt链接的小说网站进行爬取小说链接进行下载。
2 开发环境
开发环境:Python3和PyCharm;
3 网站介绍及分析
网上搜索了一下,可实现小说txt下载的网站较多,这里以无限小说网为例,网址为:https://www.555x.org/。
选择一本小说,其小说主页面网址为:https://www.555x.org/html/xua...;下载页面网址为:https://www.555x.org/down/160...。由此可以看出,每一本小说有唯一对应编号,《卡徒》的编号为16089。
查看下载地址源码,具体如下:
从图中可以看出,小说txt下载链接为:https://www.555x.org/home/dow...,其代码结构很简单,网址中"16089"编号代表小说《卡徒》,网址中其他固定不变,只改变最后编号可以对其他小说进行下载。
尝试改变了一下编号,发现"16090"编号是小说《调教初唐》,"16088"编号书籍不存在,由此可以尝试对全站小说尝试进行下载。
4 编码思路
1) 提供小说名称;
2) 在小说网站检索小说,提取小说对应编号;
3) 下载小说;
5 代码实现(1)
实现下说下载的代码:
if __name__ == "__main__":
    start_time = time.time()
    r = requests.get("https://www.555x.org/home/down/txt/id/16089")
    print(r.status_code)
    print(r.encoding)
    with open("a.txt","a",encoding="ISO-8859-1") as f:
        f.write(r.text)
    end_time = time.time()
    print("下载时间:" + str(round(end_time - start_time))  + "s")
非完整代码,后续其他功能尝试成功后会陆续更新。
6 代码问题汇总
小说下载后保存下来的txt为乱码,查看下载网址反馈的编码格式为ISO-8859-1,在写入本地txt时进行编码格式定义。
7 相关学习知识点
小说网站编码格式的查看:r.encoding;
8 结束语
本次代码只是实现了根据小说下载链接对小说进行下载,代码较简单;在之后要完善小说的检索代码,即提供输入窗口,输入小说名称,在网站检索小说,提取下载链接。
将此次编码的过程及源码分享给大家,供大家参考。对于错误的地方,或有更好的建议,希望大家提出来,不胜感激!感谢作者分享-http://bjbsair.com/2020-04-07...
郑智化-别哭,我最爱的人.mp3
03:32.34200000000001
来自居家IT男
v1.2及之前版本主要是爬取小说单章节内容并下载到本地保存为txt文件,主要熟悉了Python爬虫的基本代码,但缺少实用性。
个人观点:对于小说爬取,主要有两个方面可以尝试进一步优化,一是直接在可提供下载txt链接的小说网站直接爬取txt文件,可节省代码运行时间;二是对于还在更新中的小说,不定时检测小说更新状态,并推送最新更新信息,可尝试通过邮件、微信、短信等方式推送信息。
1 功能及版本说明
功能:提供小说名称,检索小说网站,爬取网站小说txt链接,并下载。
版本:v1.4
更新说明:
在可提供txt链接的小说网站进行爬取小说链接进行下载。
2 开发环境
开发环境:Python3和PyCharm;
3 网站介绍及分析
网上搜索了一下,可实现小说txt下载的网站较多,这里以无限小说网为例,网址为:https://www.555x.org/。
选择一本小说,其小说主页面网址为:https://www.555x.org/html/xua...;下载页面网址为:https://www.555x.org/down/160...。由此可以看出,每一本小说有唯一对应编号,《卡徒》的编号为16089。
查看下载地址源码,具体如下:
从图中可以看出,小说txt下载链接为:https://www.555x.org/home/dow...,其代码结构很简单,网址中"16089"编号代表小说《卡徒》,网址中其他固定不变,只改变最后编号可以对其他小说进行下载。
尝试改变了一下编号,发现"16090"编号是小说《调教初唐》,"16088"编号书籍不存在,由此可以尝试对全站小说尝试进行下载。
4 编码思路
1) 提供小说名称;
2) 在小说网站检索小说,提取小说对应编号;
3) 下载小说;
5 代码实现(1)
实现下说下载的代码:
if __name__ == "__main__":
    start_time = time.time()
    r = requests.get("https://www.555x.org/home/down/txt/id/16089")
    print(r.status_code)
    print(r.encoding)
    with open("a.txt","a",encoding="ISO-8859-1") as f:
        f.write(r.text)
    end_time = time.time()
    print("下载时间:" + str(round(end_time - start_time))  + "s")
非完整代码,后续其他功能尝试成功后会陆续更新。
6 代码问题汇总
小说下载后保存下来的txt为乱码,查看下载网址反馈的编码格式为ISO-8859-1,在写入本地txt时进行编码格式定义。
7 相关学习知识点
小说网站编码格式的查看:r.encoding;
8 结束语
本次代码只是实现了根据小说下载链接对小说进行下载,代码较简单;在之后要完善小说的检索代码,即提供输入窗口,输入小说名称,在网站检索小说,提取下载链接。
将此次编码的过程及源码分享给大家,供大家参考。对于错误的地方,或有更好的建议,希望大家提出来,不胜感激!感谢作者分享-http://bjbsair.com/2020-04-07...
郑智化-别哭,我最爱的人.mp3
03:32.34200000000001
来自居家IT男
v1.2及之前版本主要是爬取小说单章节内容并下载到本地保存为txt文件,主要熟悉了Python爬虫的基本代码,但缺少实用性。
个人观点:对于小说爬取,主要有两个方面可以尝试进一步优化,一是直接在可提供下载txt链接的小说网站直接爬取txt文件,可节省代码运行时间;二是对于还在更新中的小说,不定时检测小说更新状态,并推送最新更新信息,可尝试通过邮件、微信、短信等方式推送信息。
1 功能及版本说明
功能:提供小说名称,检索小说网站,爬取网站小说txt链接,并下载。
版本:v1.4
更新说明:
在可提供txt链接的小说网站进行爬取小说链接进行下载。
2 开发环境
开发环境:Python3和PyCharm;
3 网站介绍及分析
网上搜索了一下,可实现小说txt下载的网站较多,这里以无限小说网为例,网址为:https://www.555x.org/。
选择一本小说,其小说主页面网址为:https://www.555x.org/html/xua...;下载页面网址为:https://www.555x.org/down/160...。由此可以看出,每一本小说有唯一对应编号,《卡徒》的编号为16089。
查看下载地址源码,具体如下:
从图中可以看出,小说txt下载链接为:https://www.555x.org/home/dow...,其代码结构很简单,网址中"16089"编号代表小说《卡徒》,网址中其他固定不变,只改变最后编号可以对其他小说进行下载。
尝试改变了一下编号,发现"16090"编号是小说《调教初唐》,"16088"编号书籍不存在,由此可以尝试对全站小说尝试进行下载。
4 编码思路
1) 提供小说名称;
2) 在小说网站检索小说,提取小说对应编号;
3) 下载小说;
5 代码实现(1)
实现下说下载的代码:
if __name__ == "__main__":
    start_time = time.time()
    r = requests.get("https://www.555x.org/home/down/txt/id/16089")
    print(r.status_code)
    print(r.encoding)
    with open("a.txt","a",encoding="ISO-8859-1") as f:
        f.write(r.text)
    end_time = time.time()
    print("下载时间:" + str(round(end_time - start_time))  + "s")
非完整代码,后续其他功能尝试成功后会陆续更新。
6 代码问题汇总
小说下载后保存下来的txt为乱码,查看下载网址反馈的编码格式为ISO-8859-1,在写入本地txt时进行编码格式定义。
7 相关学习知识点
小说网站编码格式的查看:r.encoding;
8 结束语
本次代码只是实现了根据小说下载链接对小说进行下载,代码较简单;在之后要完善小说的检索代码,即提供输入窗口,输入小说名称,在网站检索小说,提取下载链接。
将此次编码的过程及源码分享给大家,供大家参考。对于错误的地方,或有更好的建议,希望大家提出来,不胜感激!感谢作者分享-http://bjbsair.com/2020-04-07...
郑智化-别哭,我最爱的人.mp3
03:32.34200000000001
来自居家IT男
v1.2及之前版本主要是爬取小说单章节内容并下载到本地保存为txt文件,主要熟悉了Python爬虫的基本代码,但缺少实用性。
个人观点:对于小说爬取,主要有两个方面可以尝试进一步优化,一是直接在可提供下载txt链接的小说网站直接爬取txt文件,可节省代码运行时间;二是对于还在更新中的小说,不定时检测小说更新状态,并推送最新更新信息,可尝试通过邮件、微信、短信等方式推送信息。
1 功能及版本说明
功能:提供小说名称,检索小说网站,爬取网站小说txt链接,并下载。
版本:v1.4
更新说明:
在可提供txt链接的小说网站进行爬取小说链接进行下载。
2 开发环境
开发环境:Python3和PyCharm;
3 网站介绍及分析
网上搜索了一下,可实现小说txt下载的网站较多,这里以无限小说网为例,网址为:https://www.555x.org/。
选择一本小说,其小说主页面网址为:https://www.555x.org/html/xua...;下载页面网址为:https://www.555x.org/down/160...。由此可以看出,每一本小说有唯一对应编号,《卡徒》的编号为16089。
查看下载地址源码,具体如下:
从图中可以看出,小说txt下载链接为:https://www.555x.org/home/dow...,其代码结构很简单,网址中"16089"编号代表小说《卡徒》,网址中其他固定不变,只改变最后编号可以对其他小说进行下载。
尝试改变了一下编号,发现"16090"编号是小说《调教初唐》,"16088"编号书籍不存在,由此可以尝试对全站小说尝试进行下载。
4 编码思路
1) 提供小说名称;
2) 在小说网站检索小说,提取小说对应编号;
3) 下载小说;
5 代码实现(1)
实现下说下载的代码:
if __name__ == "__main__":
    start_time = time.time()
    r = requests.get("https://www.555x.org/home/down/txt/id/16089")
    print(r.status_code)
    print(r.encoding)
    with open("a.txt","a",encoding="ISO-8859-1") as f:
        f.write(r.text)
    end_time = time.time()
    print("下载时间:" + str(round(end_time - start_time))  + "s")
非完整代码,后续其他功能尝试成功后会陆续更新。
6 代码问题汇总
小说下载后保存下来的txt为乱码,查看下载网址反馈的编码格式为ISO-8859-1,在写入本地txt时进行编码格式定义。
7 相关学习知识点
小说网站编码格式的查看:r.encoding;
8 结束语
本次代码只是实现了根据小说下载链接对小说进行下载,代码较简单;在之后要完善小说的检索代码,即提供输入窗口,输入小说名称,在网站检索小说,提取下载链接。
将此次编码的过程及源码分享给大家,供大家参考。对于错误的地方,或有更好的建议,希望大家提出来,不胜感激!感谢作者分享-http://bjbsair.com/2020-04-07...
郑智化-别哭,我最爱的人.mp3
03:32.34200000000001
来自居家IT男
v1.2及之前版本主要是爬取小说单章节内容并下载到本地保存为txt文件,主要熟悉了Python爬虫的基本代码,但缺少实用性。
个人观点:对于小说爬取,主要有两个方面可以尝试进一步优化,一是直接在可提供下载txt链接的小说网站直接爬取txt文件,可节省代码运行时间;二是对于还在更新中的小说,不定时检测小说更新状态,并推送最新更新信息,可尝试通过邮件、微信、短信等方式推送信息。
1 功能及版本说明
功能:提供小说名称,检索小说网站,爬取网站小说txt链接,并下载。
版本:v1.4
更新说明:
在可提供txt链接的小说网站进行爬取小说链接进行下载。
2 开发环境
开发环境:Python3和PyCharm;
3 网站介绍及分析
网上搜索了一下,可实现小说txt下载的网站较多,这里以无限小说网为例,网址为:https://www.555x.org/。
选择一本小说,其小说主页面网址为:https://www.555x.org/html/xua...;下载页面网址为:https://www.555x.org/down/160...。由此可以看出,每一本小说有唯一对应编号,《卡徒》的编号为16089。
查看下载地址源码,具体如下:
从图中可以看出,小说txt下载链接为:https://www.555x.org/home/dow...,其代码结构很简单,网址中"16089"编号代表小说《卡徒》,网址中其他固定不变,只改变最后编号可以对其他小说进行下载。
尝试改变了一下编号,发现"16090"编号是小说《调教初唐》,"16088"编号书籍不存在,由此可以尝试对全站小说尝试进行下载。
4 编码思路
1) 提供小说名称;
2) 在小说网站检索小说,提取小说对应编号;
3) 下载小说;
5 代码实现(1)
实现下说下载的代码:
if __name__ == "__main__":
    start_time = time.time()
    r = requests.get("https://www.555x.org/home/down/txt/id/16089")
    print(r.status_code)
    print(r.encoding)
    with open("a.txt","a",encoding="ISO-8859-1") as f:
        f.write(r.text)
    end_time = time.time()
    print("下载时间:" + str(round(end_time - start_time))  + "s")
非完整代码,后续其他功能尝试成功后会陆续更新。
6 代码问题汇总
小说下载后保存下来的txt为乱码,查看下载网址反馈的编码格式为ISO-8859-1,在写入本地txt时进行编码格式定义。
7 相关学习知识点
小说网站编码格式的查看:r.encoding;
8 结束语
本次代码只是实现了根据小说下载链接对小说进行下载,代码较简单;在之后要完善小说的检索代码,即提供输入窗口,输入小说名称,在网站检索小说,提取下载链接。
将此次编码的过程及源码分享给大家,供大家参考。对于错误的地方,或有更好的建议,希望大家提出来,不胜感激!感谢作者分享-http://bjbsair.com/2020-04-07...
郑智化-别哭,我最爱的人.mp3
03:32.34200000000001
来自居家IT男
v1.2及之前版本主要是爬取小说单章节内容并下载到本地保存为txt文件,主要熟悉了Python爬虫的基本代码,但缺少实用性。
个人观点:对于小说爬取,主要有两个方面可以尝试进一步优化,一是直接在可提供下载txt链接的小说网站直接爬取txt文件,可节省代码运行时间;二是对于还在更新中的小说,不定时检测小说更新状态,并推送最新更新信息,可尝试通过邮件、微信、短信等方式推送信息。
1 功能及版本说明
功能:提供小说名称,检索小说网站,爬取网站小说txt链接,并下载。
版本:v1.4
更新说明:
在可提供txt链接的小说网站进行爬取小说链接进行下载。
2 开发环境
开发环境:Python3和PyCharm;
3 网站介绍及分析
网上搜索了一下,可实现小说txt下载的网站较多,这里以无限小说网为例,网址为:https://www.555x.org/。
选择一本小说,其小说主页面网址为:https://www.555x.org/html/xua...;下载页面网址为:https://www.555x.org/down/160...。由此可以看出,每一本小说有唯一对应编号,《卡徒》的编号为16089。
查看下载地址源码,具体如下:
从图中可以看出,小说txt下载链接为:https://www.555x.org/home/dow...,其代码结构很简单,网址中"16089"编号代表小说《卡徒》,网址中其他固定不变,只改变最后编号可以对其他小说进行下载。
尝试改变了一下编号,发现"16090"编号是小说《调教初唐》,"16088"编号书籍不存在,由此可以尝试对全站小说尝试进行下载。
4 编码思路
1) 提供小说名称;
2) 在小说网站检索小说,提取小说对应编号;
3) 下载小说;
5 代码实现(1)
实现下说下载的代码:
if __name__ == "__main__":
    start_time = time.time()
    r = requests.get("https://www.555x.org/home/down/txt/id/16089")
    print(r.status_code)
    print(r.encoding)
    with open("a.txt","a",encoding="ISO-8859-1") as f:
        f.write(r.text)
    end_time = time.time()
    print("下载时间:" + str(round(end_time - start_time))  + "s")
非完整代码,后续其他功能尝试成功后会陆续更新。
6 代码问题汇总
小说下载后保存下来的txt为乱码,查看下载网址反馈的编码格式为ISO-8859-1,在写入本地txt时进行编码格式定义。
7 相关学习知识点
小说网站编码格式的查看:r.encoding;
8 结束语
本次代码只是实现了根据小说下载链接对小说进行下载,代码较简单;在之后要完善小说的检索代码,即提供输入窗口,输入小说名称,在网站检索小说,提取下载链接。
将此次编码的过程及源码分享给大家,供大家参考。对于错误的地方,或有更好的建议,希望大家提出来,不胜感激!
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论