Linux系统下用Python提取《釜山行》人物关系
文章目录
【项目说明】本项目源自蓝桥实验楼,本文为实验笔记,补充了一些原教程未说明的细节
主要思路:
关系紧密的人物往往会在文本中多段内同时出现
可以通过识别文本中已确定的实体(人名),计算不同实体共同出现的次数和比率。
当比率大于某一阈值,我们认为两个实体间存在某种联系。
一、开发准备
1、下载并安装可视化软件Gephi:
Gephi介绍:Gephi是一款开源免费跨平台基于JVM的复杂网络分析软件,其主要用于各种网络和复杂系统,动态和分层图的交互可视化与探测开源工具。
【步骤】
(1)进入终端:cd /home/Code
(2)创建work文件夹,下载并安装gephi
【具体实现】
(1)创建两个文件夹并进入文件夹:
mkdir work && cd work
mkdir gephi $$ cd gephi
(2)安装gephi:
wget http://labfile.oss.aliyuncs.com/courses/677/gephi-0.9.1-linux.tar.gz  #下载
$ tar -zxvf gephi-0.9.1-linux.tar.gz  #解压
2、安装jieba中文分词库
sudo pip3 install jieba
3、下载《釜山行》的中文剧本
wget http://labfile.oss.aliyuncs.com/courses/677/busan.txt
4、观察文本结构,准备词典
由于《釜山行》人物少、关系简单,所以我们可以通过词典指定人物名称的方式做实体识别。也可以不建立字典并尝试使用某种分词算法或包装好的分词库,如教程使用的jieba,但离开特定词典的针对特定文本的分词效果可能会有很大程度削弱。因此对简单网络而言,建立字典是效率较高的做法。
可以通过各类百科获取《釜山行》的主要人物,并将人名写入一个字典中。项目将主要人物的名称保存在文件dict.txt中,你可以通过下面的命令下载这个字典,也可以自己新建一个文件保存。字典dict.txt需放在文件夹/home/shiyanlou/Code/work下。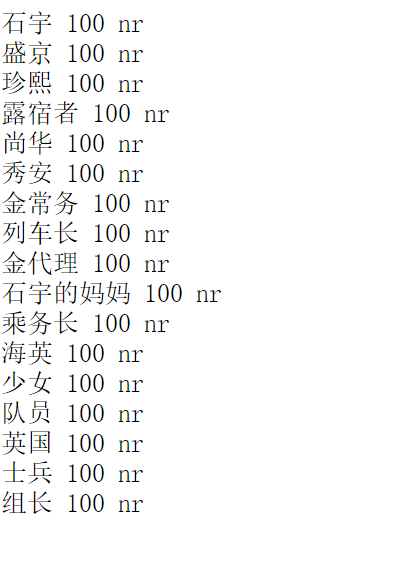
二、新建Python文件并开始编写
1. 确定需要的变量
(1)设定以下几个字典变量,字典{key:value}
- names,用来保存人物: {人物名称:全文中出现的次数}
- relationships,用来保存人物关系的有向边*,代表人物之间联系的紧密程度:{有向边的起点:edge}
【补充说明】edge:edge是一个字典变量,edge={有向边的终点:有向边的权值}
该字典的键为有向边的起点,值为一个字典edge,edge的键是有向边的终点,值是有向边的权值。
(2)设定一个列表变量
- lineNames,保存对每一段分词得到当前段中出现的人物名称。(这是一个缓存变量)
lineName[i]表示储存第i段中出现过的人物。
2. 具体实现
(在文件夹下创建busan.py文件并开始编写代码: vim busan.py)
(1)先引入几个库
import os, sys
import jieba, codecs, math
import jieba.posseg as pseg
(2)接着定义变量
names = {}   #姓名字典
relationships = {} #关系字典
lineNames = [] #每段内人物关系
(3)文本中的实体识别
【逻辑】读入《釜山行》剧本的每一行,对其做分词(判断该词的词性是不是“人名”[词性编码:nr],如果该词的词性不为nr,则认为该词不是人名),提取该行(段)中出现的人物集,存入lineName中。之后对出现的人物,更新他们在names中的出现次数。
【实现】
jieba.load_userdict("dict.txt")        # 加载字典
with codecs.open("busan.txt", "r", "utf8") as f:
    for line in f.readlines():
        poss = pseg.cut(line)        # 分词并返回该词词性
        lineNames.append([])        # 为新读入的一段添加人物名称列表
        for w in poss:
            if w.flag != "nr" or len(w.word) < 2:
                continue            # 当分词长度小于2或该词词性不为nr时认为该词不为人名
            lineNames[-1].append(w.word)        # 为当前段的环境增加一个人物
            if names.get(w.word) is None:
                names[w.word] = 0
                relationships[w.word] = {}     #理解为为了能够做加法补充说明初始值
            names[w.word] += 1                    # 同时该人物出现次数加 1
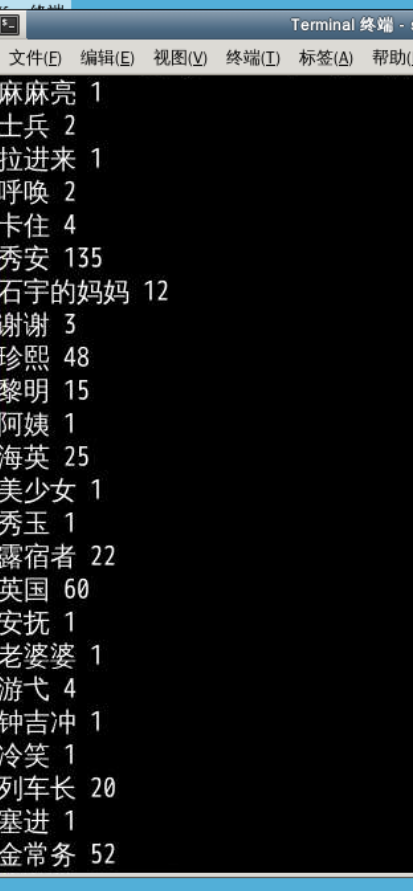
可以在 with 代码块之后添加以下代码输出生成的 names 来观察人物出现的次数:
for name, times in names.items():
print(name, times)运行代码查看结果:python3 busan.py
【补充说明】
在lineNames中是这样的:
在第一次大循环中(for line in f.readlines这个循环)
- 在lineNames中新增一个列表用于存放这段中会出现的人物
- 如果出现了一个词性为名称的词,就把这个名称放进刚在lineNames中新建的列表中,全文出现该名字的次数加1(names中对应该词的值加1)
- 完成大循环后会是这样:
[[张三,李四,张三,王二,李四],[张三,张三,李四,小美,王二,李白],[…],[…],….]
因此在lineNames中每一个索引,代表这是第几行的line(从0计数)
【初学者在实现过程中会遇到的问题】
- with
防止出现异常而影响整个程序的运行(进一步学习:《浅谈with的神奇魔法》https://blog.csdn.net/lxy2107...); - codecs.open()函数
python3直接用open即可,这么用可兼容python2和3,参数,r为读,w为写,rw为读写; - as f
将打开的文件命名为f - f.readlines()函数
读取所有行(直到结束符 EOF)并返回列表,将读取到的一行存储进变量line - pseg.cut()
用于分词,并返回一个词性,返回值估计是个字典{word:flag},flag指词性 - lineNames.append([])
在lineNames中增加一个列表(也就是说,lineNames是一个包含几个列表的列表) - 变量line的作用
这里用到jieba库里刚刚我们加载的字典,如果符合,则的返回词性为nr - for x in y
表示x就是y里的一个元素,和计数器有所区别,此处x有y中元素的属性,line就是f.readlines()返回的数组中的元素,也就是那一行话,因为其中只有一个元素 if names.get(w.word) is None:
- 取字典names中索引为w.word的值,names中存放的是对应w.names的次数
get是字典中的查询
- lineNames.append()
在列表中追加元素 - lineNames[-1].append(w.word)
在最末尾加上w.word这个词,也就是某个人物名字 for name, times in names.items(): 字典的遍历
    ↑      ↑
    key   value
(4)根据识别结果构建网络
【逻辑】对于 lineNames 中每一行,我们为该行中出现的所有人物两两相连。如果两个人物之间尚未有边建立,则将新建的边权值设为 1,否则将已存在的边的权值加 1。
(这种方法将产生很多的冗余边,这些冗余边将在最后处理。)
for line in lineNames:                    # 对于每一段
    for name1 in line:
        for name2 in line:                # 每段中的任意两个人
#(“二维”遍历,对每个x中的每个y做下面操作)
            if name1 == name2:
                continue
            if relationships[name1].get(name2) is None:        # 若两人尚未同时出现则新建项
                relationships[name1][name2]= 1
            else:
                relationships[name1][name2] = relationships[name1][name2]+ 1        # 两人共同出现次数加 1
【补充说明】
在字典relationships中实际是这样的: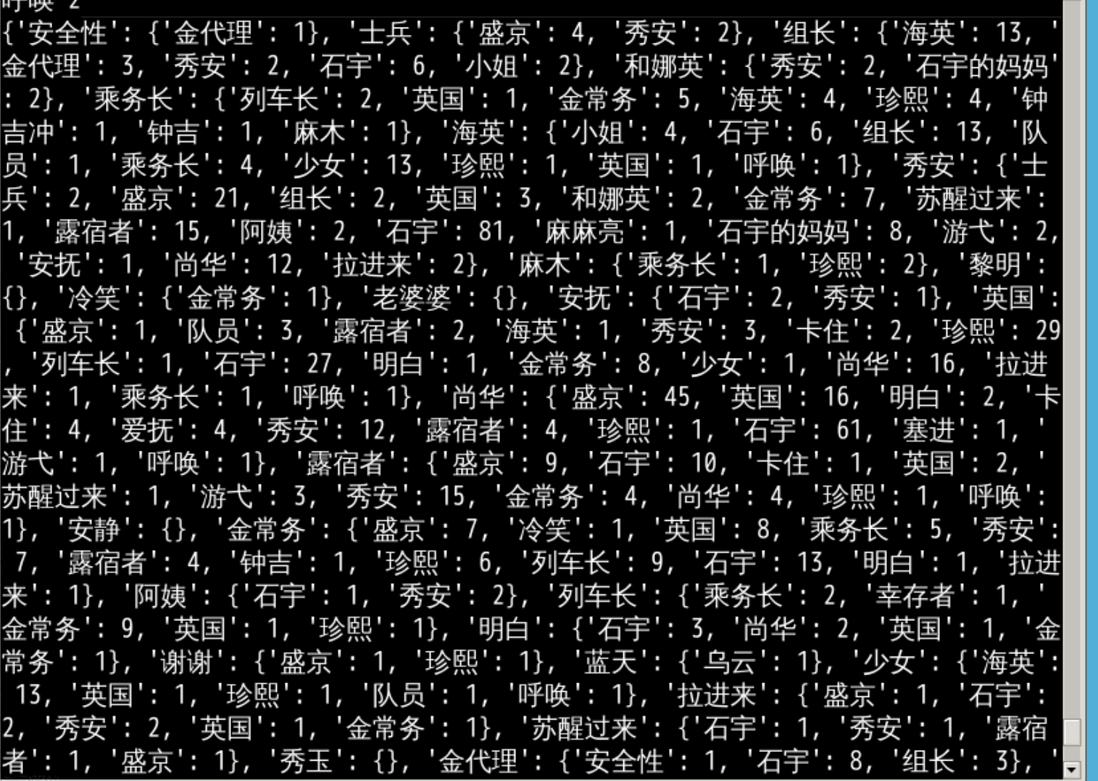
来看单个元素:
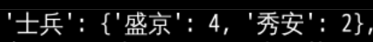
就可以对应理解:
relationships[name1].get(name2)和relationships[name1][name2]如何理解:字典变量relationships[][]=1(之前没有name1和name2的关系,但是在这段分词中出现了,因此初始化为1)
(5) 过滤冗余边并输出结果
【逻辑】将已经建好的 names 和 relationships 输出到文本,以方便 gephi 可视化处理。输出边的过程中可以过滤可能是冗余的边,这里假设共同出现次数少于 3 次的是冗余边,则在输出时跳过这样的边。输出的节点集合保存为 busan_node.txt ,边集合保存为 busan_edge.txt 。
with codecs.open("busan_node.txt", "w", "gbk") as f:
    f.write("Id Label Weight\r\n")
    for name, times in names.items():
        f.write(name + " " + name + " " + str(times) + "\r\n")

with codecs.open("busan_edge.txt", "w", "gbk") as f:
    f.write("Source Target Weight\r\n")
    for name, edges in relationships.items():
        for v, w in edges.items():
            if w > 3:
f.write(name + " " + v + " " + str(w) + "\r\n")完成所有代码编写后,运行python3 busan.py
在文件夹work下将会生成busan_node.txt和busan_edge.txt。
busan_node.txt: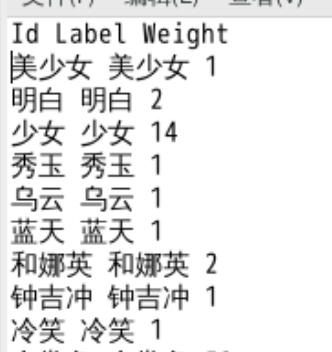
busan_edge.txt: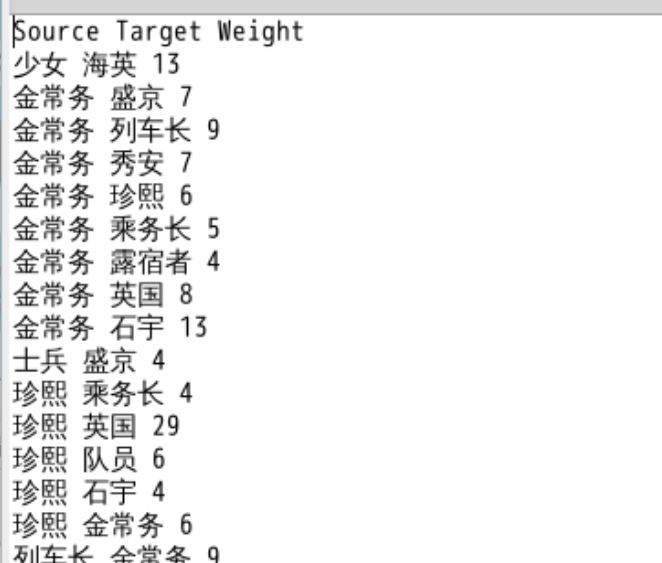
【初学者在实现过程中会遇到的问题】
- \r\n:换行
- f.write(name + " " + name + " " + str(times) + "\r\n")中为什么有两次name:
为了两个文件格式统一,方便之后用于Gephi做可视化 最后一段代码目的是计算人物之间的对应关系:
for name, edges in relationships.items():  #对每个字典relationships{name:edges}做
   for v, w in edges.items():          #对每个字典edges{v:w}做
        if w > 3:                       #(v是终点 ,w是权值-即同一终点出现的次数)
            f.write(name + " " + v + " " + str(w) + "\r\n")
(6)可视化网络
前面对《釜山行》剧本中的人物关系数据进行了处理,下面我们将使用gephi这个软件来将人物关系可视化,以便展示的更直观。
- 使用 gephi 导入生成的网络,并生成简单的可视化布局。执行下面命令启动 gephi 。
$ cd gephi/gephi-0.9.1/bin
$ ./gephi
点击 文件 -> Import SpreadSheets 。

分别选择节点表格和边表格导入上面代码中生成的两个文件,分隔符选择 空格 ,编码选择GB2312。
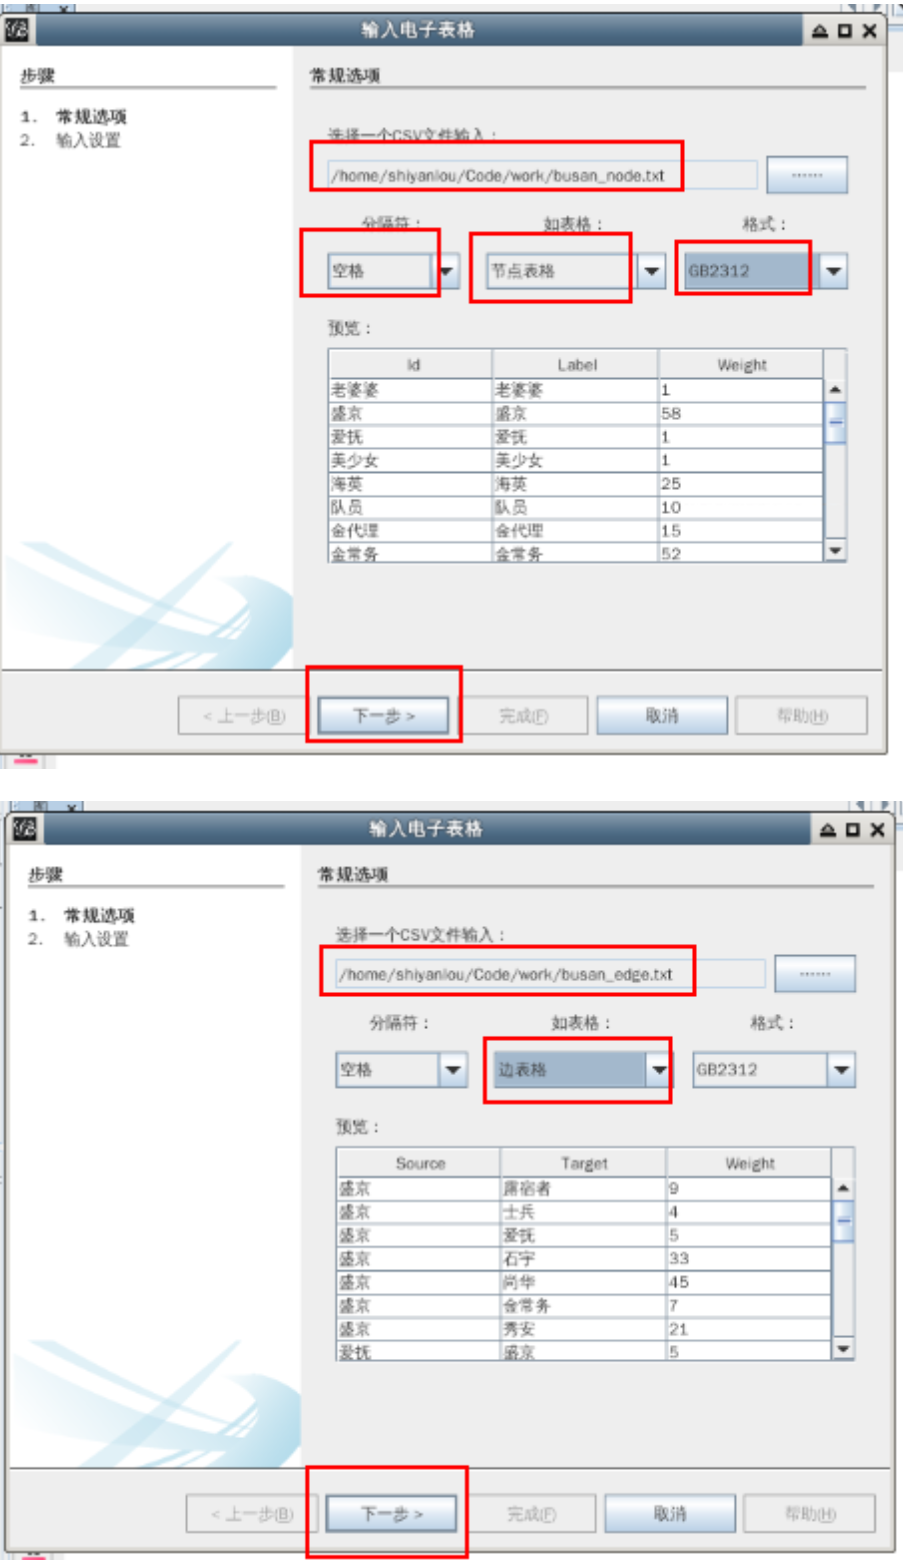
导入后 gephi 将显示所有节点。此时节点没有合适的布局,如下图。你可以在最上方的 数据资料 选项卡中查看图中所有的边和节点,对于分词不准确导致的噪音,可以手动删除。
【数据资料】选项卡中如果id列显示名字而label列为空白,可以通过下方的复制数据到其它列按钮把id列的数据复制到label列中。
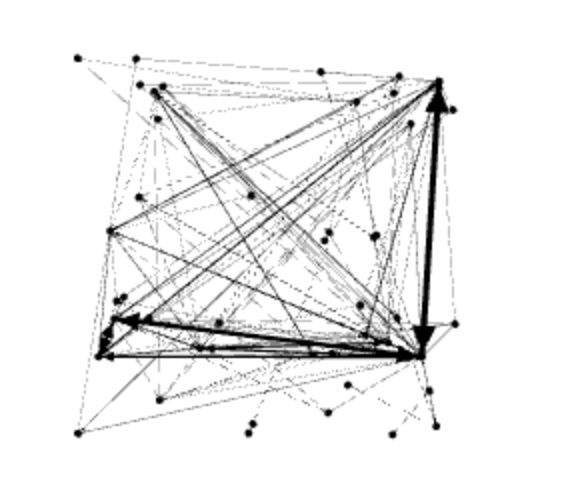
分别点击右侧 统计 栏中 平均度 和 模块化 运行计算。模块化运算时 Resolution 值填写 0.5。

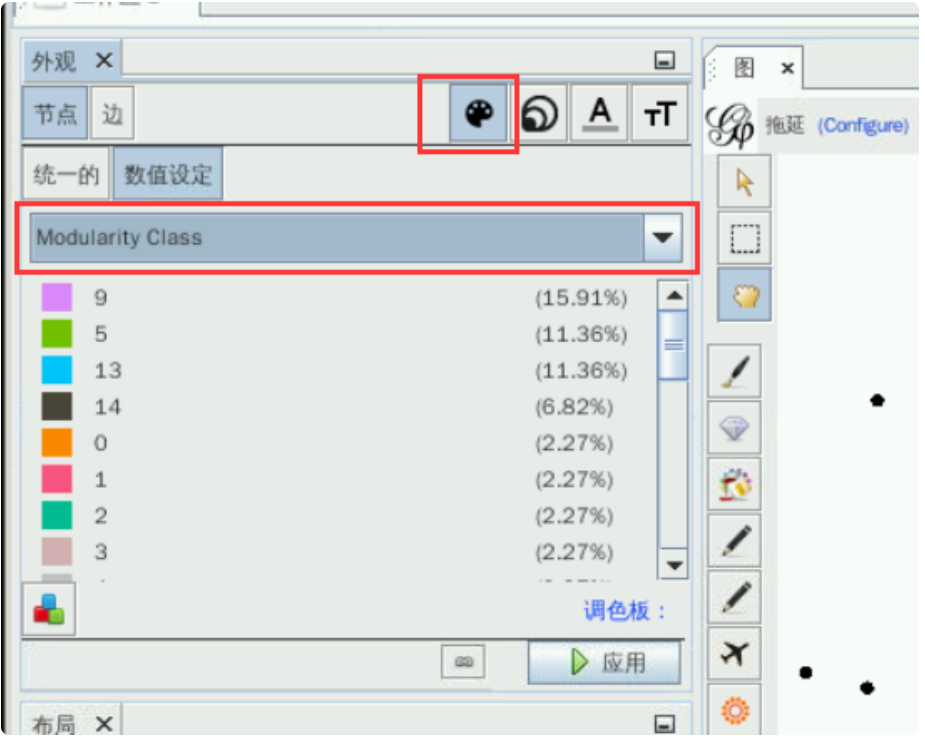
点击左上角外观中节点第一个选项卡,选择数值设定,选择Modularity Class。
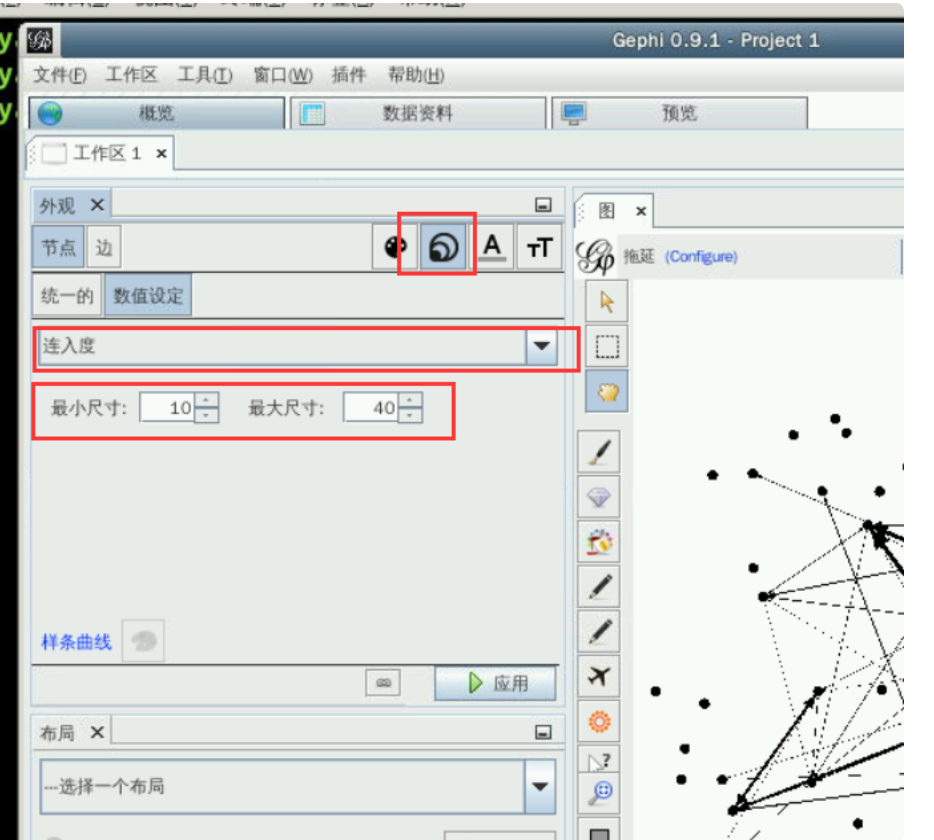
选中第二个选项卡,选择数值设定,选择连入度,最小尺寸填10,最大尺寸填40,点击应用为节点染色、放大。
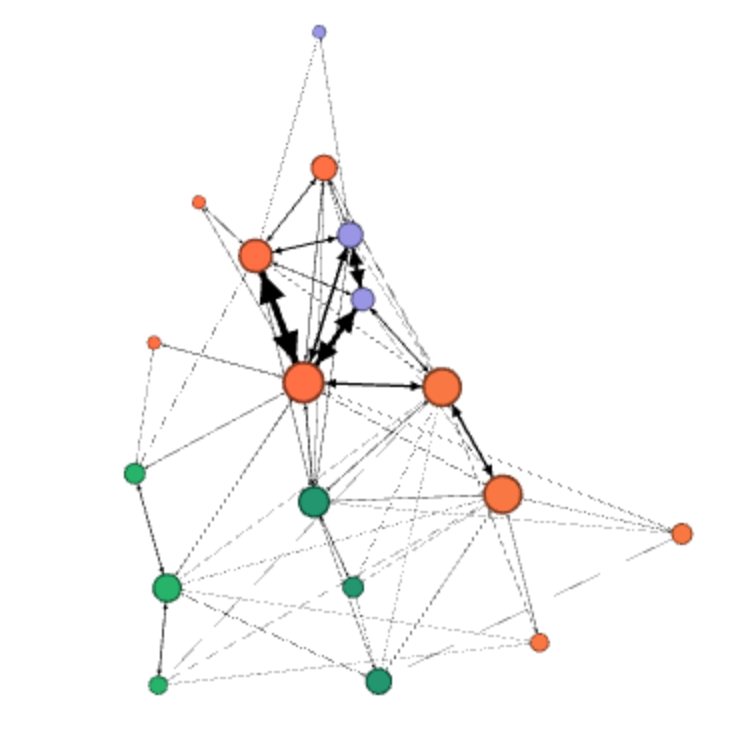
选择左下角布局中的 Force Atlas ,斥力强度填写 20000.0 ,吸引强度填写 1.0 。点击运行,稍后点击停止。

此时布局大致如下图所示。节点染色根据模块化计算结果不定,但染色效果大致相同。
点击最上方的 预览 按钮,选中左侧 节点标签 中 显示标签 选项,并选择一种字体,这里选择 文泉驿微米黑 。

点击刷新按钮,右侧显示最终的人物关系图。
【结果】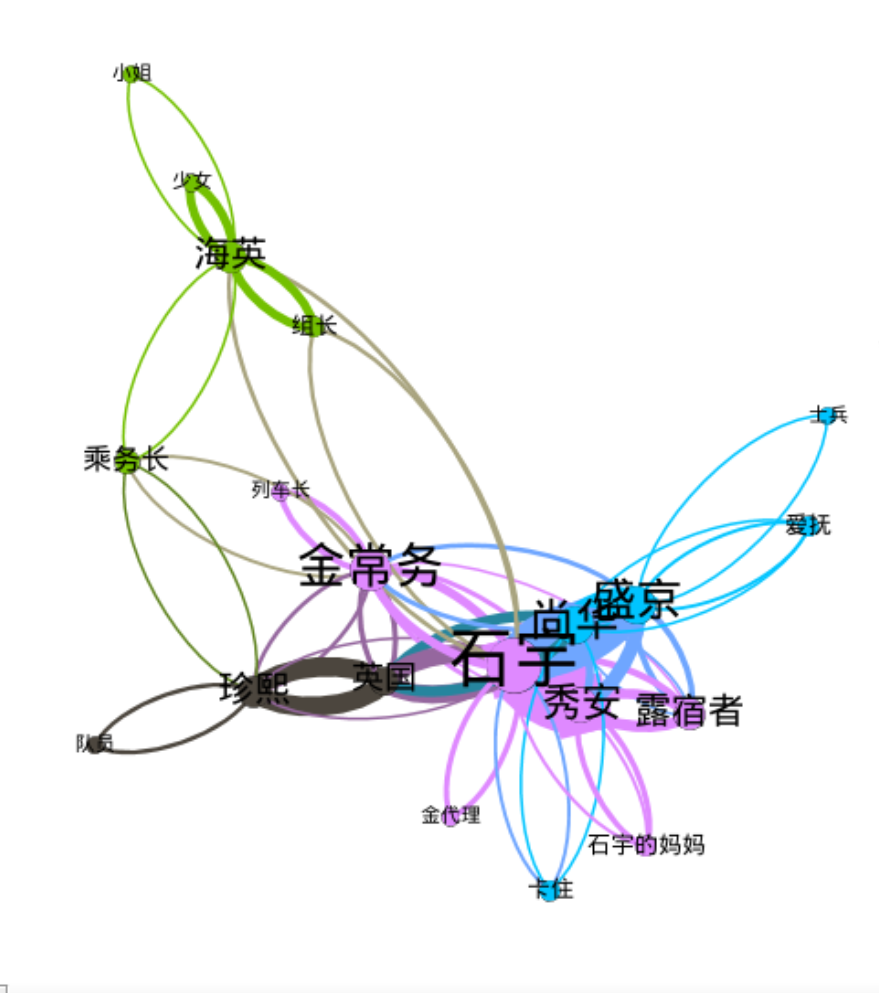
最后,我又用相同的方法提取了《长安十二时辰》的node和edge,有兴趣的朋友可以下载来试着做一做可视化,代码链接:https://github.com/fsdrnf28/C...
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论