【机器学习总结】--决策树
文章目录
决策树的结构

每个内部节点表示一种特征或属性,每个边代表着一个特征或属性的取值,每个叶子节点表示一种类别。
决策树的构建过程
决策树分为分类树和回归树,首先来说分类树:
分类决策树的构建过程如下: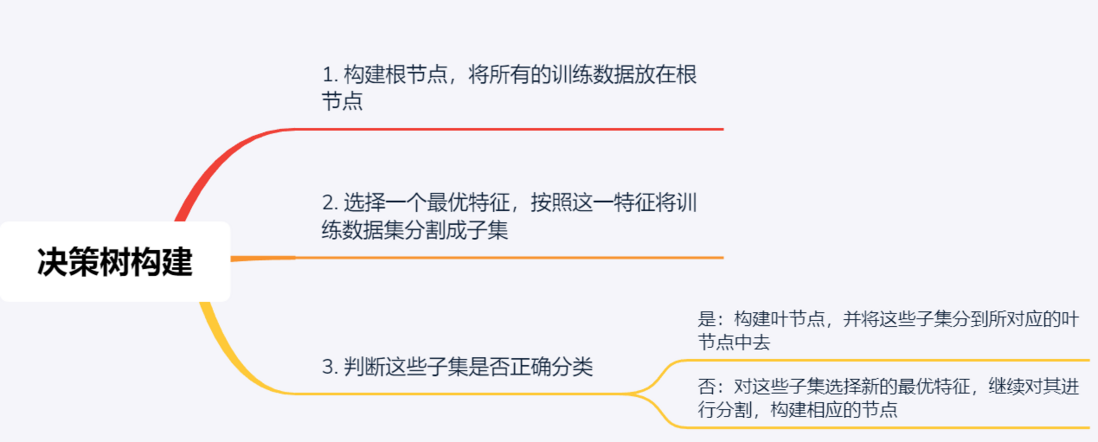
根据上图过程,构建决策树时重要的两个过程:一是如何选择一个最优特征;二是如何
如何判断这些子集是否被正确的分类:
一. 选择最优特征
特征选择关键在于选取对训练数据具有分类能力的特征,即如果按照这一特征将训练数据分割成子集,使得各个子集在当前条件下能够很好的区分开样本,那么就应该选择这个特征。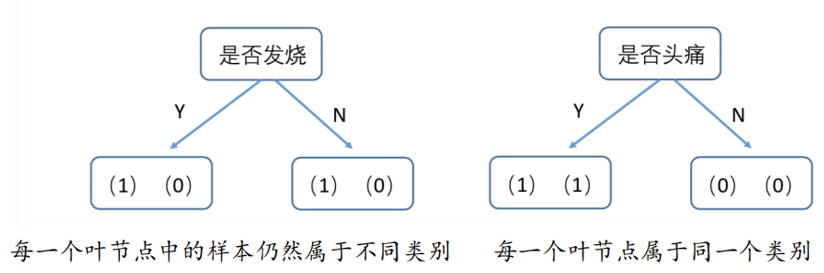
怎样算能够很好的区分开样本,主要在于使用某特征做分割后,不确定性变小了。
那么问题就是不确定性怎样定义,以及怎样来刻画不确定性变化的程度。
定义不确定性
一般使用信息熵来定义不确定性,信息熵通过平均信息量来度量不确定性,熵越大,不确定性越大。下面解释下为什么熵可以用来表示不确定性:
信息熵是信息量的定量描述,是随机变量抽样得到的分布中产生的信息量的平均值:
$$H(x) = -\sum_{i=1}^{\infty}P(x_i)logP(x)$$
- 信息量:信息量可以被看做是在学习x的值时的“惊讶程度”,当一个相当于不可能的事件发生时,信息量(惊讶程度)越大;当一个事情一定会发生时,信息量(惊讶程度)越小;
- 定义信息量的函数h(x):由此将信息内容的度量与概率分布P(x)挂钩,将信息内容的度量依赖于概率分布P(x),信息内容h(x)是概率P(x)的单调递减函数;
不相关的事件X、Y,X和Y同时发生的概率为:P(X,Y) = P(X)P(Y),X和Y同时发生的信息量应是:h(X, Y) = h(X)+h(Y),根据这个变乘为加的关系,可以考虑引入log来表示h(X),于是可以有:
$$h(x) = -logP(x)$$或者$$h(x)=log(\frac {1}{P(x)})$$ - 对随机变量抽样所获得的平均信息量,就是关于概率分布P(x)的期望(以第一种表达方式为例):
$$H(x) = -\sum_{i=1}^{\infty}P(x_i)logP(x)$$
参考blog链接:https://blog.csdn.net/pipisor...
因此一个样本的信息熵越大,对这个样本进行随机抽样所获得的平均信息量就越大(惊讶程度),其不确定性就越大。(如果是二分布的话,概率为0.5时熵最大)
定义不确定性变化的程度
使用信息熵只能知道这个样本的不确定性是大还是小,考虑不确定性的变化程度可以通过这三种方法:
信息增益(互信息)
特征A对数据集D不确定性减少的程度称为信息增益,即信息增益描述了属性对样本的不确定性的减少程度:
$$g(D,A)=H(D)-H(D|A)$$
根据信息增益选择特征的方法是:对训练数据集D,计算其每个特征的信息增益,并比较它们的大小,最终选择信息增益最大的特征。
计算特征A对训练数据集D的信息增益方法如下:
- 计算数据集D的信息熵H(D):$H(D)=-\sum_{k=1}^{K}{\frac{C_k}{D}log_2{\frac{C_k}{D}\quad}}$
- 计算特征A对数据集D的经验条件熵H(D|A):$H(D|A)=\sum_{i=1}^{n}{\frac{|D_i|}{|D|}H(D_i)}=-\sum_{i=1}^{n}{\frac{|D_i|}{|D|}\sum_{k=1}^{K}{\frac{|D_{ik}|}{D_i}log_2{\frac{|D_{ik}|}{|D_i|}}}}$
- 计算信息增益:$g(D,A)=H(D)-H(D|A)$
其中$|C_k|$表示属于类$C_k$的个数,$\sum_{k=1}^{K}{|C_k|}=|D|$;
$|D_i|$表示根据特征A的取值将D划分的子集中,属于每个子集$D_i$的样本个数;
$|D_{ik}|$表示子集$D_i$中属于类$C_k=\sum_{i=1}^{n}{\frac{|D_i|}{D}H(D_i)}$的样本个数;
例子: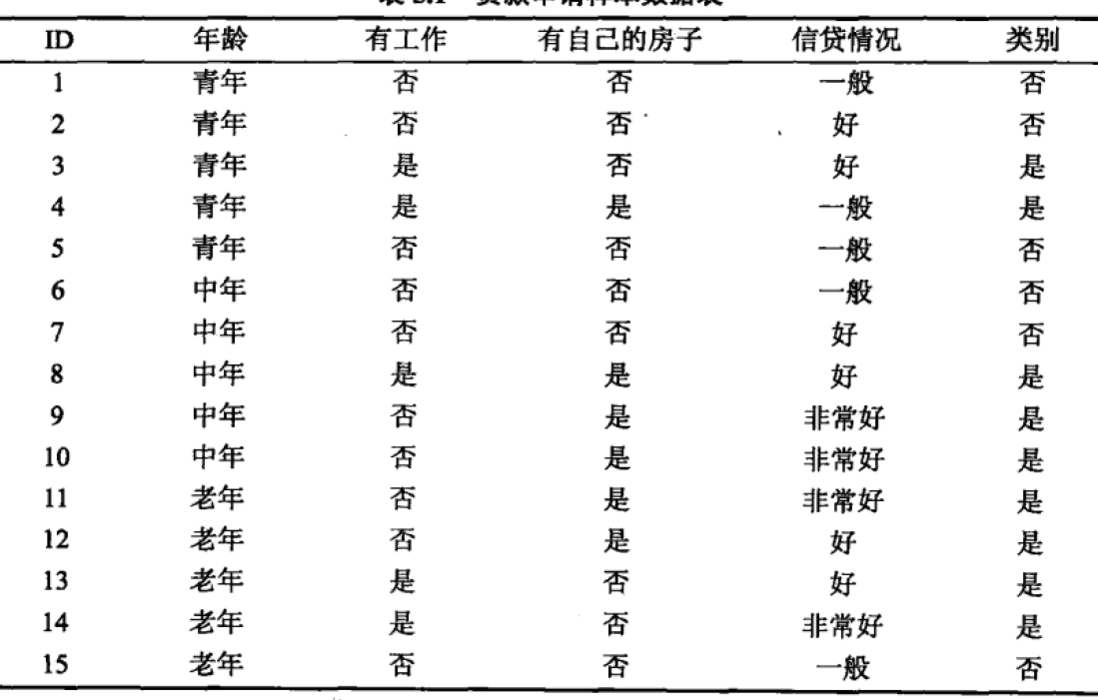
其中总样本数$|D|=15,D_1=9,D_0=6$
训练集的信息熵:$H(D)=-(\frac{6}{15}log(\frac{6}{15})+\frac{9}{15}log(\frac{9}{15}))=0.971$
- 对于年龄属性,有青年,中年,老年三个集合,其中每个类别的不同类样本数为Morning(3:2),Afternoon(2:3),Night(1:4):
$H(D|Age)=-\frac{5}{15}[\frac{3}{5}log(\frac{3}{5})+\frac{2}{5}log(\frac{2}{5})]-\frac{5}{15}[\frac{2}{5}log(\frac{2}{5})+\frac{3}{5}log(\frac{3}{5})]-\frac{5}{15}[\frac{1}{5}log(\frac{1}{5})+\frac{4}{5}log(\frac{4}{5})]=0.888$
$g(D,Age)=0.971-0.888=0.083$ - 有工作属性,有是和否两个集合,其中每个类别的不同类样本数为:有工作(0:5),无工作(4:6):
$H(D|offer)=-\frac{5}{15}[\frac{0}{5}log(\frac{0}{5})+\frac{5}{5}log(\frac{5}{5})]-\frac{10}{15}[\frac{4}{10}log(\frac{4}{10})+\frac{6}{10}log(\frac{6}{10})]=0.647$
$g(D,offer)=0.971-0.647=0.324$ - 其他属性同理,g(D|house)=0.42,g(D|pay)=0.363,故选择house作为第一个特征进行分类;
信息增益比
信息增益对类别数较多的特征会有所偏好,原因在于:
一般情况下是类别数越多,其熵大的可能性越大,应该是对类别数多的特征越不会关照才对,但是互信息多乘了$\frac{D_i}{D}$,这个再乘上每个子集里的熵,当特征多时每项都乘上小于1的数求和,会让特征数多的熵变小的可能性增大,故信息增益偏向于类别数的特征。
基尼系数
基尼系数与熵相似,
二. 判断子集是否被正确分类
- 当前节点包含的样本全属于同一个类别:
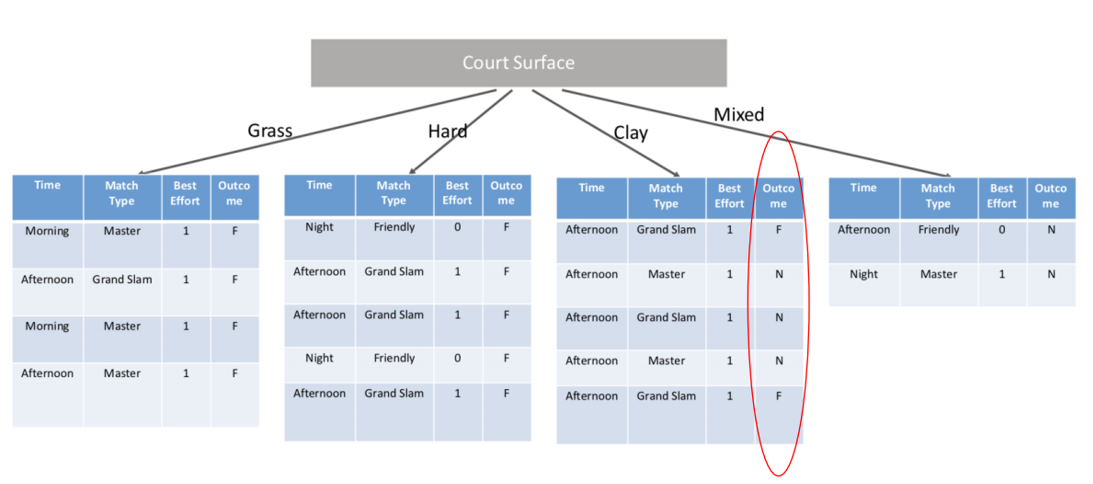
- 当前特征集为空,或是所有样本在所有特征上取值相同,无法划分:
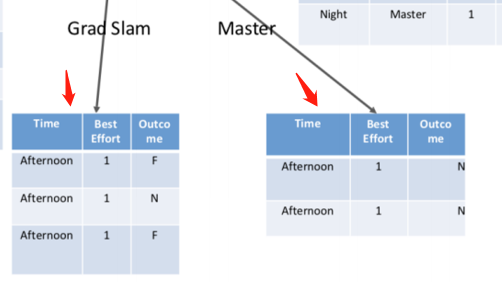
- 当前节点包含的样本集合为空,不能划分;
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论