Redis复习总结

文章目录
## Redis内存模型
### Redis内存分配
- 数据 :Redis存储的数据对象 字符串、哈希、列表、集合、有序集合
- 进程本身所需内存 : Redis进程自己运行所需要的内存,比如代码,占用内存,常量池等
- 缓存内存:
+ 客户端缓冲区 : 连接客户端输入输出的缓存
+ 复制积压缓冲区: 在主从同步时,非全量复制时,所需要的缓存区
+ 复制积压缓冲区: AOF写入时的缓存
- 内存碎片:内存碎片是Redis在分配、回收物理内存过程中产生的
### Redis内存分配器 (jemalloc)
+ jemalloc 将空间分为 小(Small)、大(Large)、巨大(Huge)三种

### Redis内存统计
- used_memory (Redis内存分配器分配的内存)
> 存储的数据的内存
- used_memory_rss (Redis占操作系统的内存)
> 包括存储的数据内存还有内存碎片以及Redis本身占用内存
### Redis数据的存储过程
- RedisObject
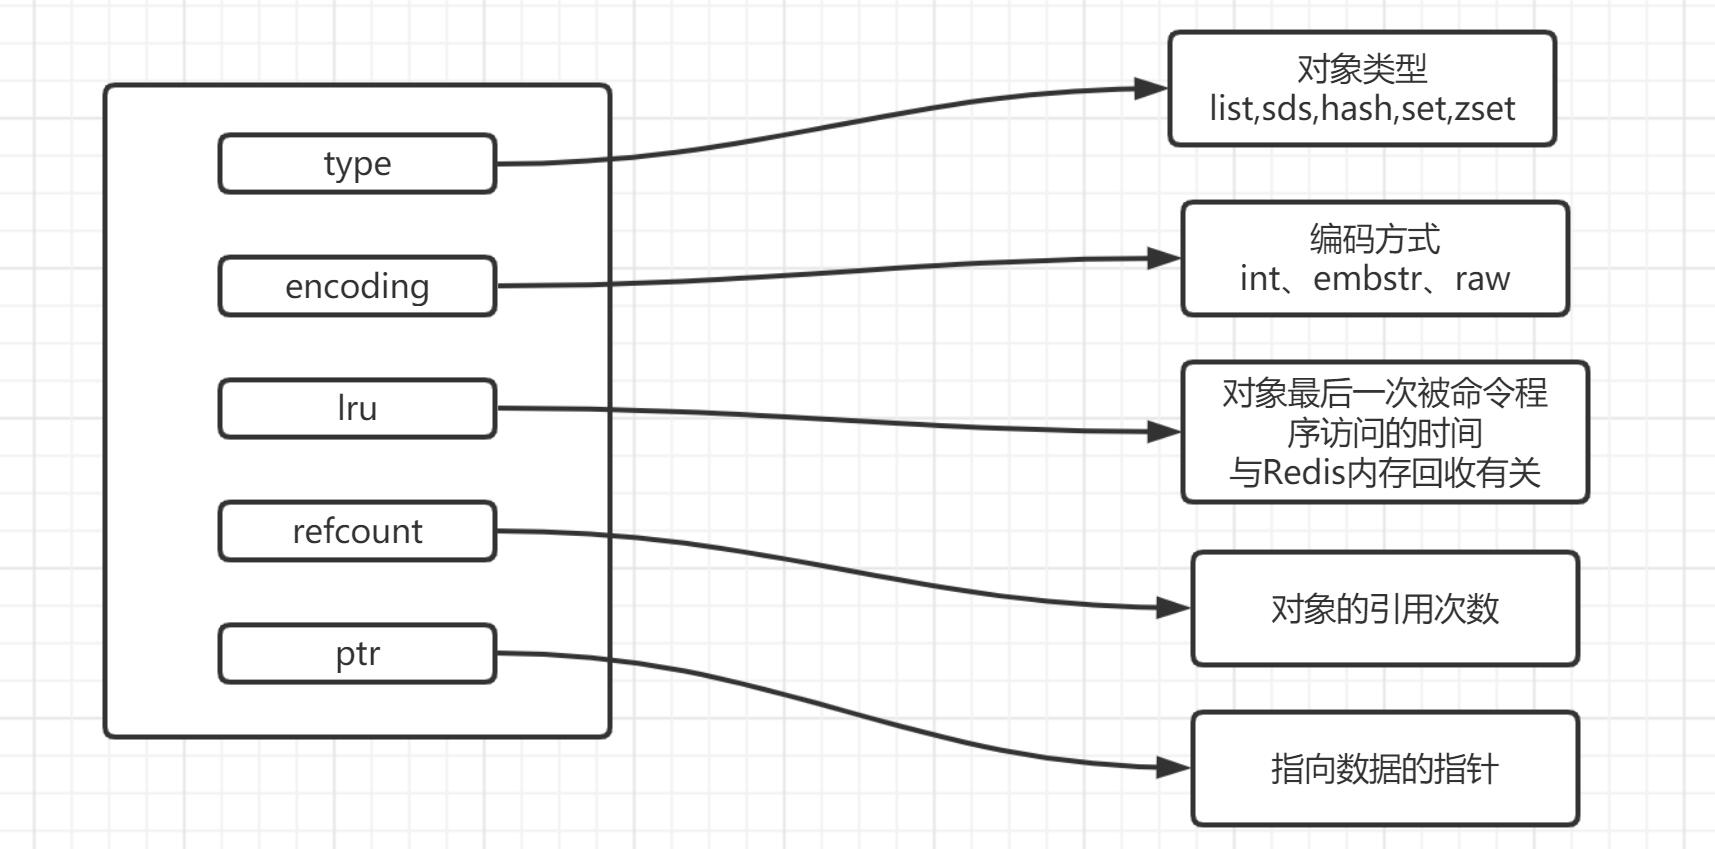
- 数据类型
+ SDS
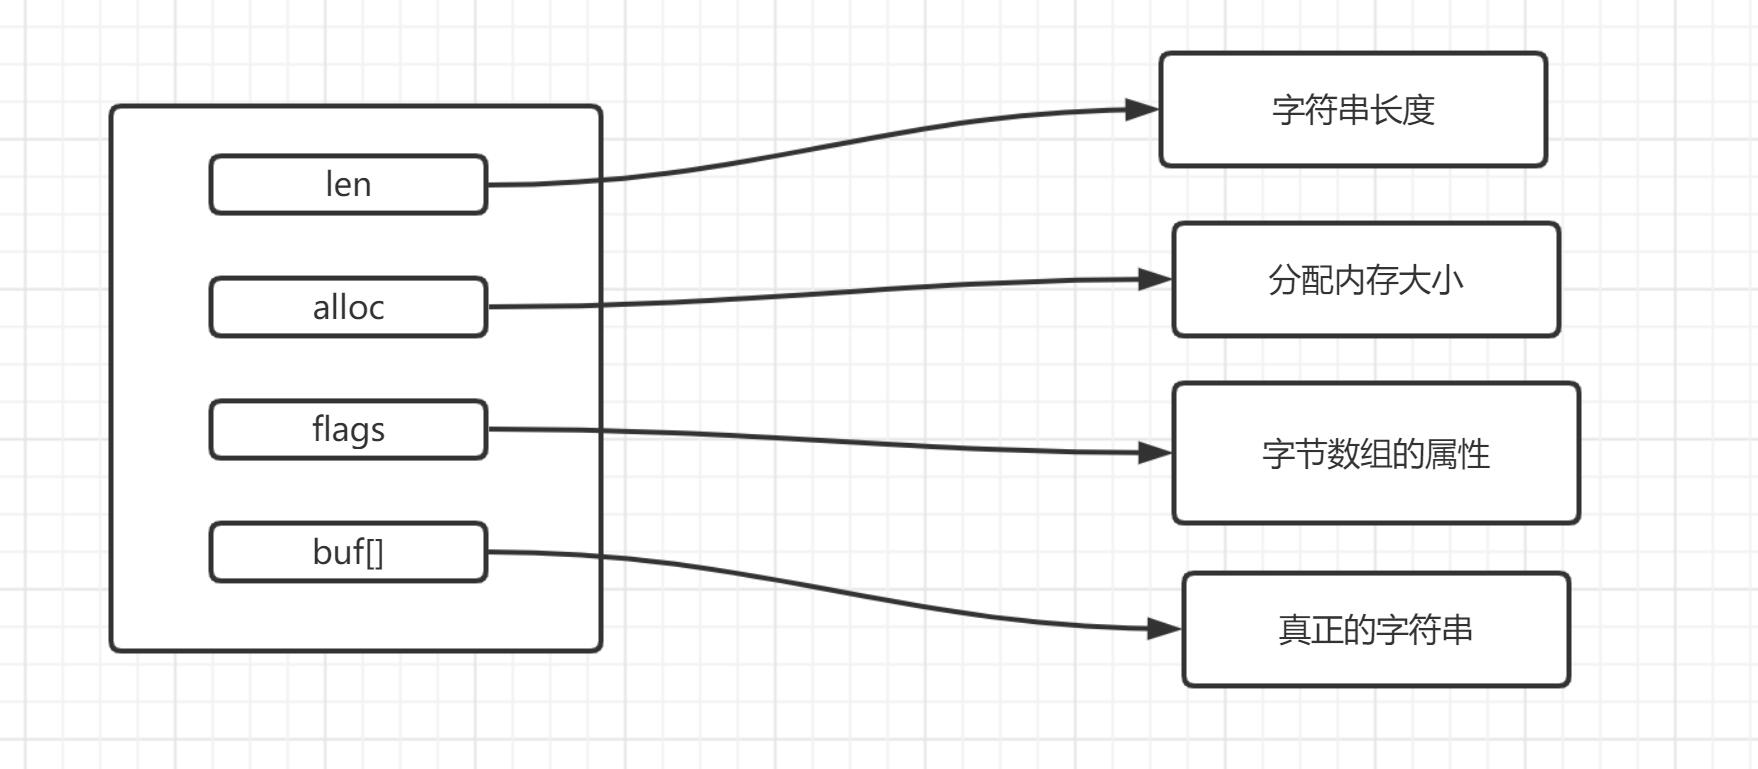
- 空间预分配
sdscat =》给字符串后面再拼接一个字符串
当sdscat 之后内存小于 1M,字符串长度*2+1 (’\0’)
当sdscat 之后内存大于 1M, 字符串长度 + 1M + 1(’\0’)
- 空间懒分配
如果sdstrim(减少字符串),则不急着回收空间,下次如果需要添加长度,直接使用多余的空间。
+ List
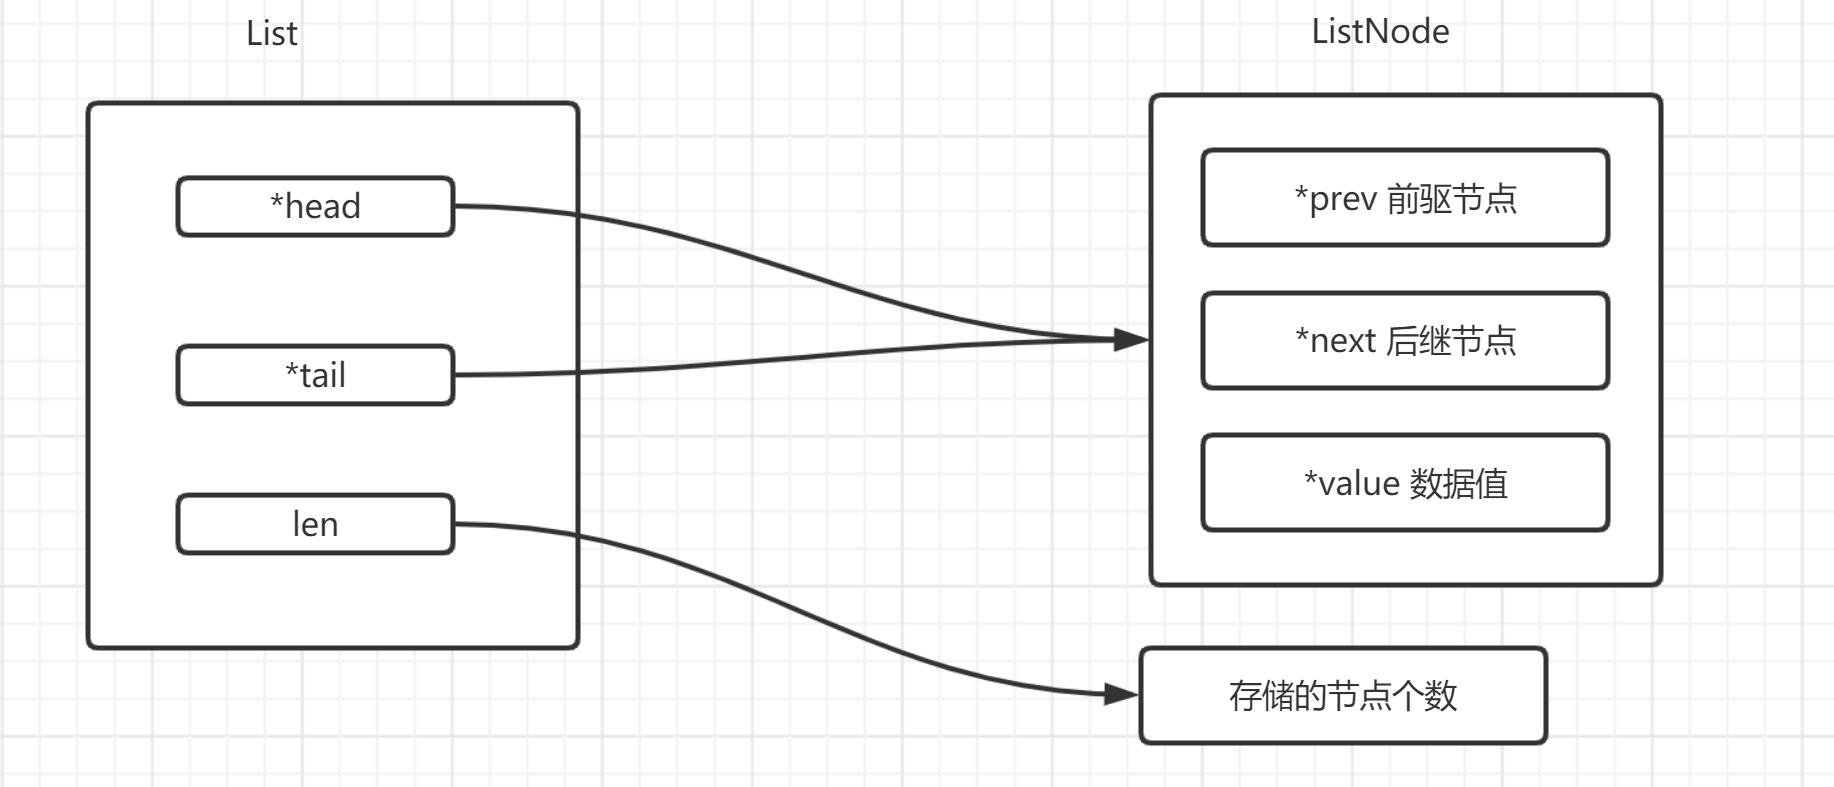
+ Hash
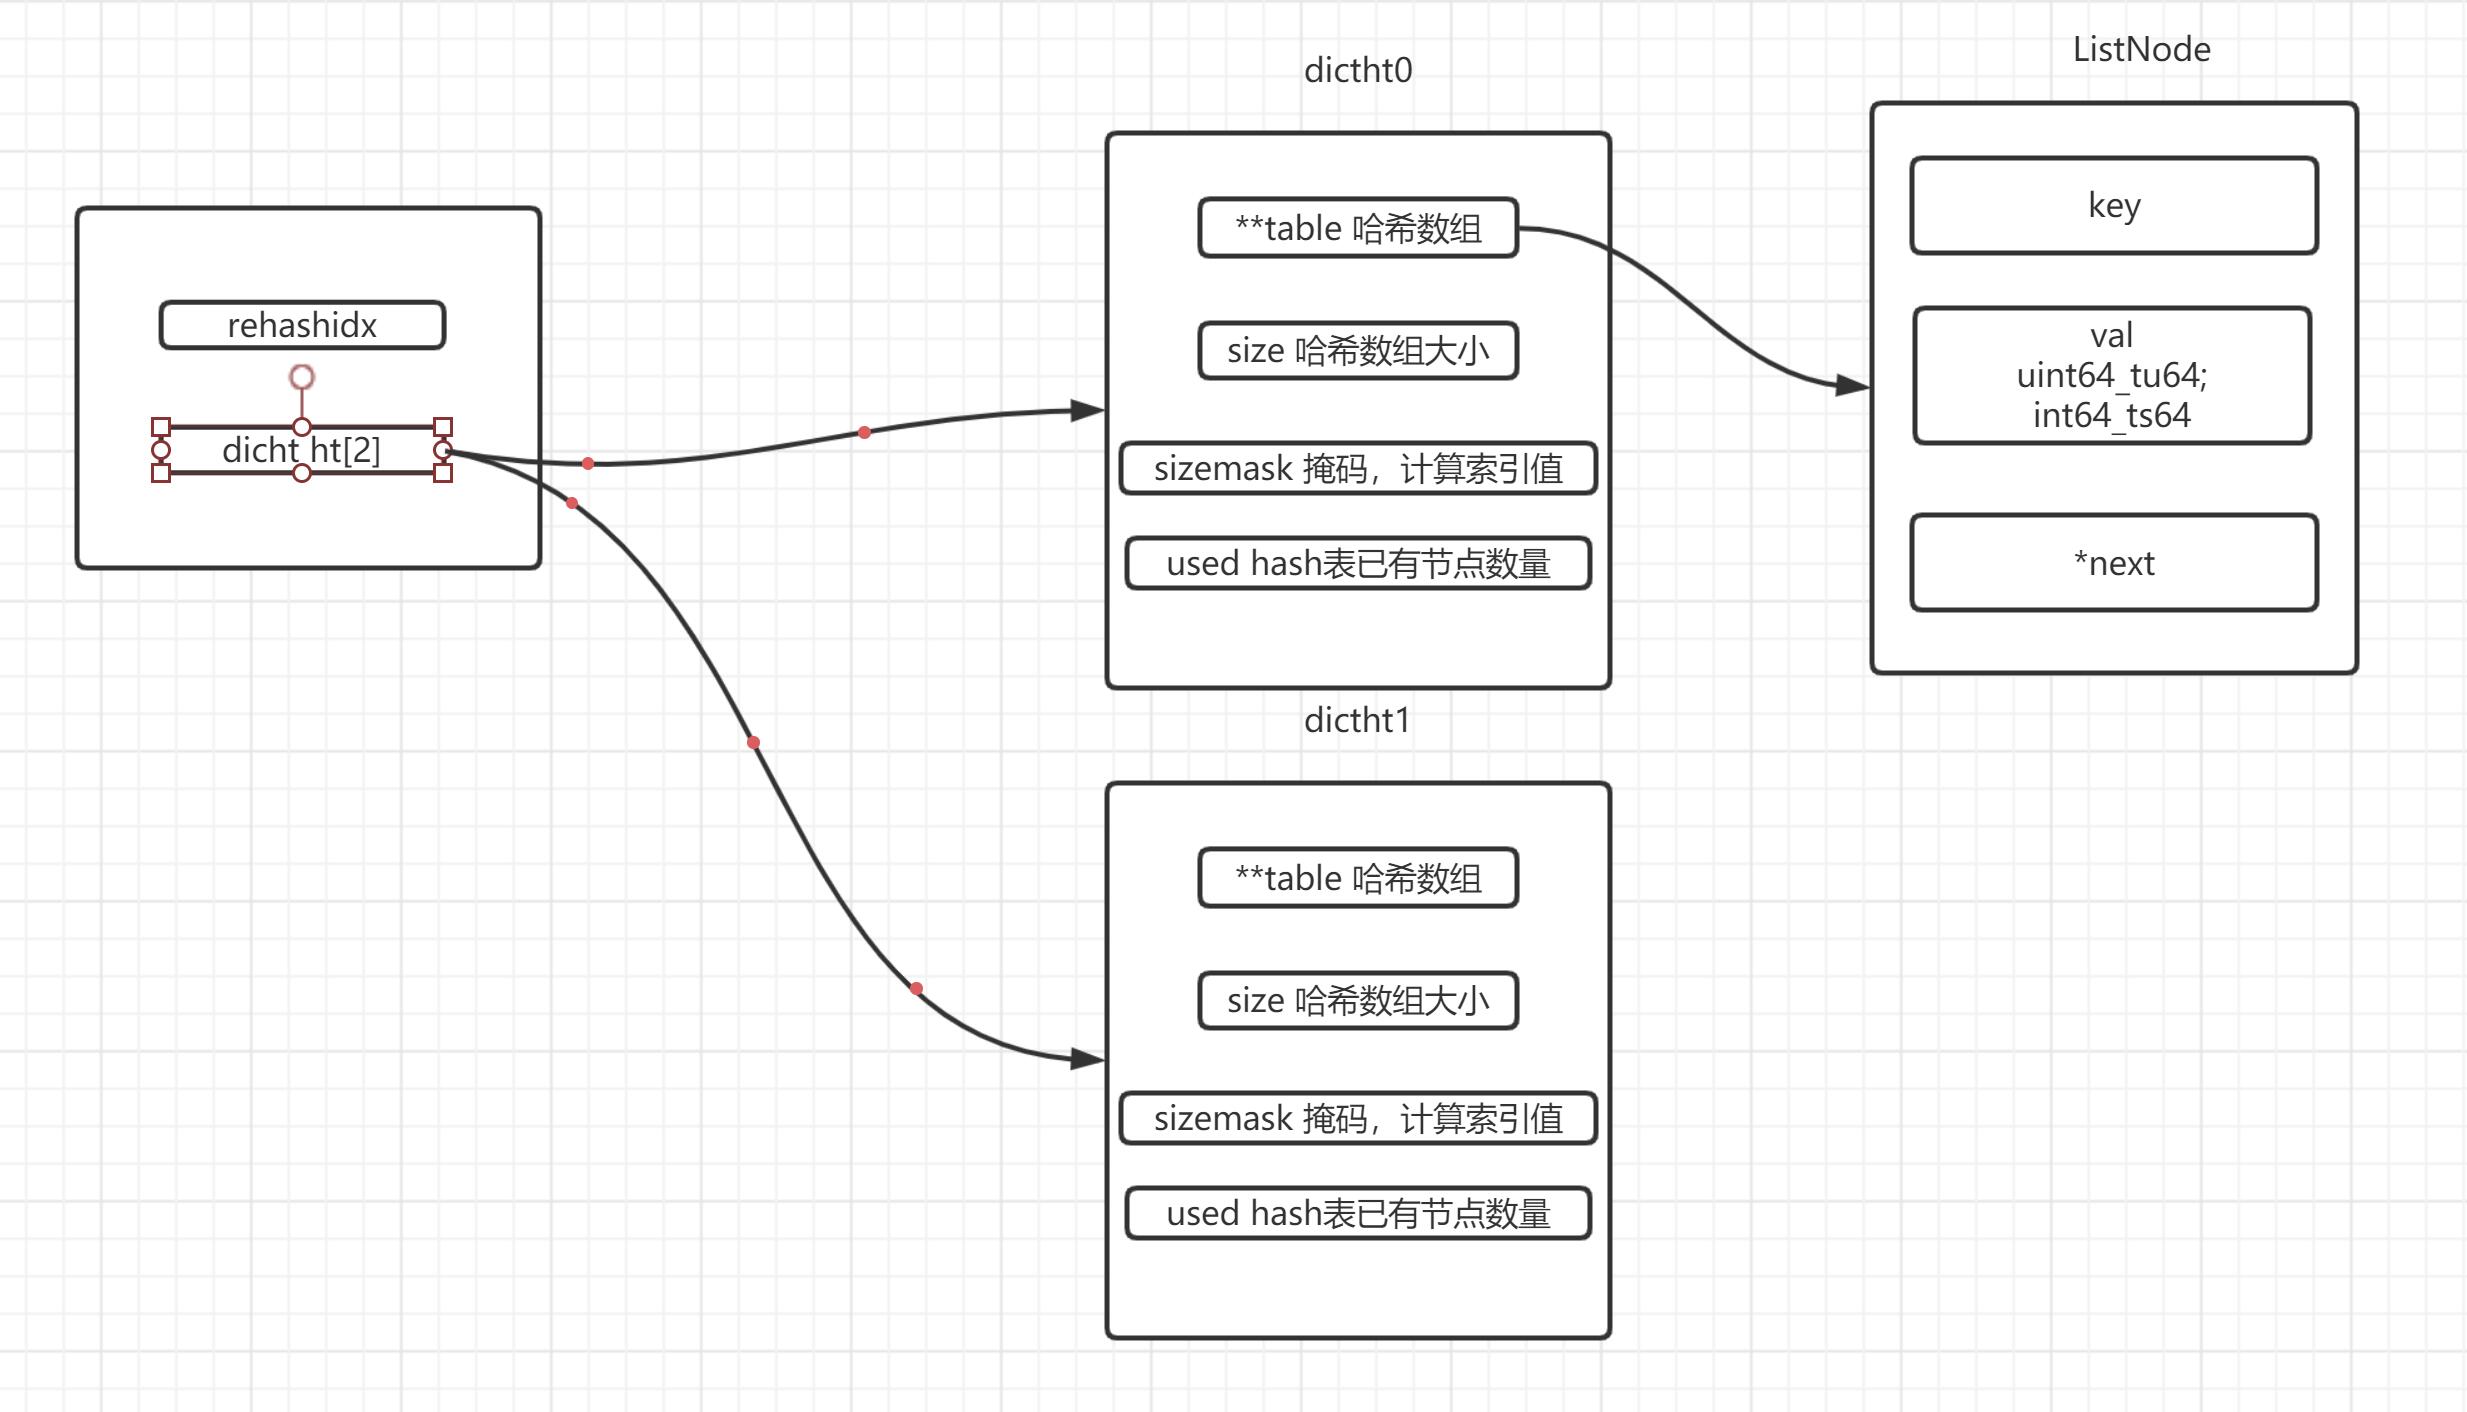
在字典中存在dictht数组,表明是两个hash表
ht[1]的容量是ht[0]的两倍
把ht[0]中的元素rehash复制到ht[1]中
+ set
+ zset
- 数据存储过程
> RedisObject -> 具体的数据类型
### Redis内存回收策略
+ noeviction:返回错误当内存限制达到并且客户端尝试执行会让更多内存被使用的命令(大部分的写入指令,但DEL和几个例外)
+ allkeys-lru:尝试回收最少使用的键(LRU) ,使得新添加的数据有空间存放。
+ volatile-lru:尝试回收最少使用的键(LRU) ,但仅限于在过期集合的键,使得新添加的数据有空间存放。
+ allkeys-random:回收随机的键使得新添加的数据有空间存放。
+ volatile-random:回收随机的键使得新添加的数据有空间存放,但仅限于在过期集合的键。
+ volatile-ttl:回收在过期集合的键,并且优先回收存活时间(TTL) 较短的键,使得新添加的数据有空间存放。
## Redis的原子性保证
+ 单指令原子性
> Redis是单线程的,一个线程只能执行一个指令,因此具有原子性
+ Lua原子性
> 官方解释来看,Lua脚本和Redis的事务一样,被exec/mutl包裹,redis保证每次只能执行一个lua脚本,别的lua脚本不会被执行,由此保证了原子性。
## 分布式锁
### 主要命令
+ setnx 不存在key才可以操作
+ set 与set相反
### 锁续期
> 利用**Redission**,当成功获取一个锁的时候,产生看门狗(watch dog)进行锁续期,一般来说是10s检查一次
> 核心在于Redission使用了Lua脚本
### 分布式锁的极端情况
> 当服务A从Master中获取锁,A获取锁成功后,还没来得及同步到从节点,master挂了,从节点
重新成为master,服务B过来后,发现该锁还未被获取,于是锁被重复获取
## Redis的冷备和热备
+ 热备 - AOF
- 数据文件比RDB更大
- 每秒都去持久化,数据丢失少
- 存储的文件是每条的指令
- 先执行命令,之后才存储到磁盘(由于redis不是完全维护,只有执行以后才知道结果,单纯的语法监测是无用的)
- bgrewriteaof 可以对aof的日志文件进行瘦身,也就是fork一个子进程把原来的日志全部转化成redis命令存到一个新的日志中执行
+ 冷备 - RDB
- 需要fork子进程,数据量大的话会导致几秒的延迟,对于秒杀场景危险
- 是段时间保存数据,一旦发生宕机,数据丢失较多
- RDB恢复的更快
## Redis集群
### 哨兵监控
+ 主观下线
> 从节点无法ping通master,则主观认为master挂了
+ 客观下线(主节点的下线)
> 多个从节点都无法ping通master,则从节点们客观认为master挂了,**需要重新选举**
+ 定时任务
+ 错误转移
- 过滤不健康的节点
- 选举出新的节点
- 让从节点成为主节点
- 让原来的master成为从节点
+ 哨兵选举
> Raft : 谁先申请成为主节点,谁就是主节点
## 主从同步的过程
1. 从节点向master发送slaveof获取主节点的信息
+ 定时任务获取主节点信息
+ 从节点去ping主节点,主节点则返回pang和runid等信息
2. 从节点根据保存的Master runid判断是不是第一次同步复制
3. 如果是第一次psync?-1,则进行全量复制
+ 全量复制址启用用RDB生成快照
- 启动RDB会fork子进程,则子进程运行期间,新命令进入到缓存区
+ RDB生成到磁盘,之后在读取到内存,再进行数据同步
- 快照内容同步完以后,再将缓存的命令缓存到从节点
4. 如果不是第一次,则进行部分复制,从节点向master发送Psync runid offset
5. Master收到命令后会查看,runid是否一致,之后查看偏移量offset是否超过复制积压缓存区
+ 如果偏移量超过复制积压缓存区,则err,进行全量复制
+ 如果未超过,则offset+偏移量+命令长度进行部分复制
### 复制积压缓存区
> 在主从同步的期间,仍然会有写命令在执行,这时命令在写入主节点的同时还会写入**复制积压缓存区**,同时记录偏移量,如果这期间缓存的命令过多,则没必要再进行部分复制,直接进行全量复制即可
## 缓存的常见问题
1. 缓存穿透
+ 恶意访问不存在的数据,导致打入数据库
+ 增加认证(接口访问功能)
2. 缓存击穿
+ 某热点数据突然失效,打入数据库
+ 设置null值
3. 缓存雪崩
+ 大量数据同时失效
+ 设置随机时间种子
## redis中的 HyperLogLog
### 场景分析
> 访问网站的独立访客UV,例如每个访客访问某网站,访问多次,其实只能算作一次。
> 那么带来的直接问题是,如果每个用户都占用一个key,那么就会产生数据量巨大的问题
### 解决方案拆分
+ 借鉴数据库的b+树
> 解决了插入和查找的问题,但是解决不了数据量大,占用内存的问题
+ bitmap
> 如果是一亿个数据,那么100_000_000(数据量)/ 8(字节)/ 1024(KB)/ 1024(MB) ≈ 12 M
### 概率统计
> 可以看到bitmap已经是属于极致的优化了,但是还是不够,不管怎么说,为了一个统计功能,单一个对象就是12M,但是再多一些还是会很多
> 则使用 “估计的方法可能会好一些”,则使用 **概率统计**
#### redis的实现
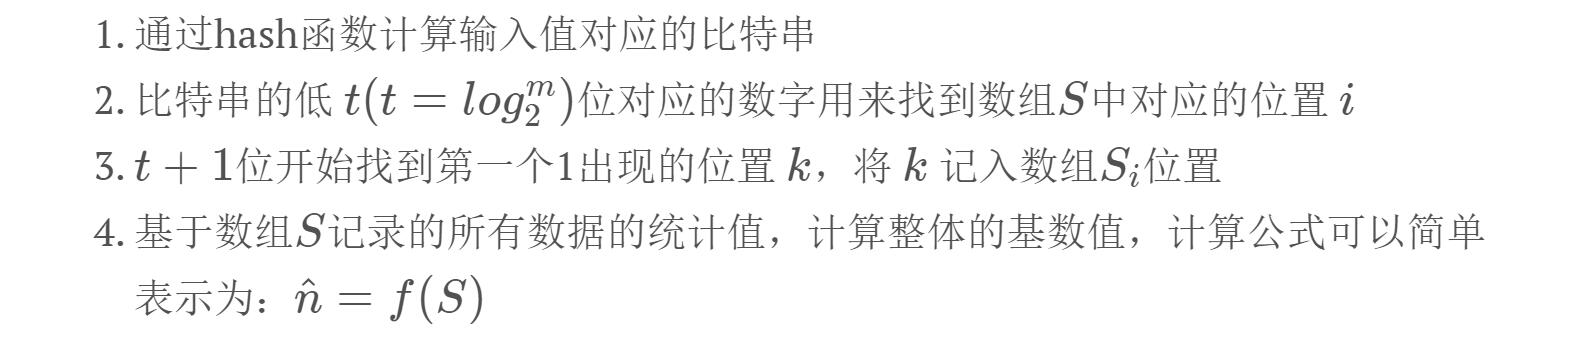
HLL中实际存储的是一个长度为mm的大数组SS,将待统计的数据集合划分成mm组,每组根据算法记录一个统计值存入数组中。数组的大小mm由算法实现方自己确定,redis中这个数组的大小是16834(2的14次方),m越大,基数统计的误差越小,但需要的内存空间也越大
#### hll的实现原理 - 伯努利试验
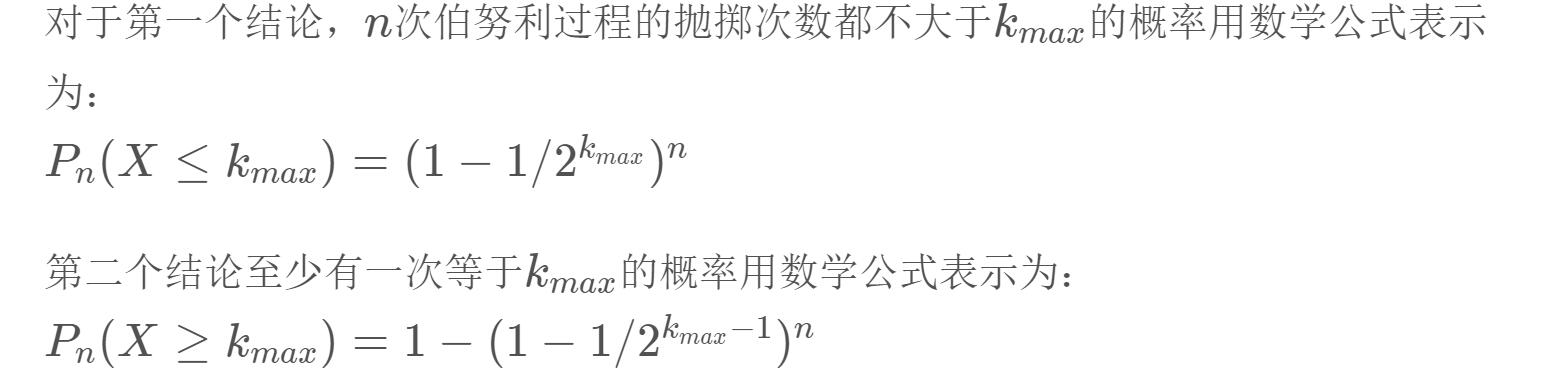
+ 伯努利实现也就是掷硬币实现,那么我们说假设存在第一次掷出正面所用的最多的次数为kmax,则可以提出假设
+ 假设:
- 掷出n次正面所用的次数一定少于n*kmax
- 掷出n次正面所用的次数一定有那么一次是等于kmax的(其实正好是1减去上面的概率)
+ 推断:
- 那么当n远大于kmax的时候,那么第一个不成立
- 那么当n远小于kmax的时候,那么第二个不成立
+ 继续推断
- 那么用kmax推断n的次数貌似是最好的情况
则 n = 2^kmax
+ 继续思考
- 如果很大的一段二进制,只用一个kmax误差比较大
- 那么把一段很大的分开估计就好了,因此有**分桶原理**,也就是redis过程中对应的数组S的m
### 稀疏存储和密集存储
1. 密集存储就是按照原来16834来存储
2. 稀疏存储就是连续两个0作为统计接下来的 6bit 整数值加 1
### hll对象头struct hllhdr {
char magic[4];      /* 魔术字符串"HYLL" */
uint8_t encoding;   /* 存储类型 HLL_DENSE or HLL_SPARSE. */
uint8_t notused[3]; /* 保留三个字节未来可能会使用 */
uint8_t card[8];    /* 总计数缓存 */
uint8_t registers[]; /* 所有桶的计数器 */
};
## 订阅与发布
### PubSub
#### 缺点
+ 没有ack确认信息,不能保证数据连续
+ 不持久化消息
#### PubSub
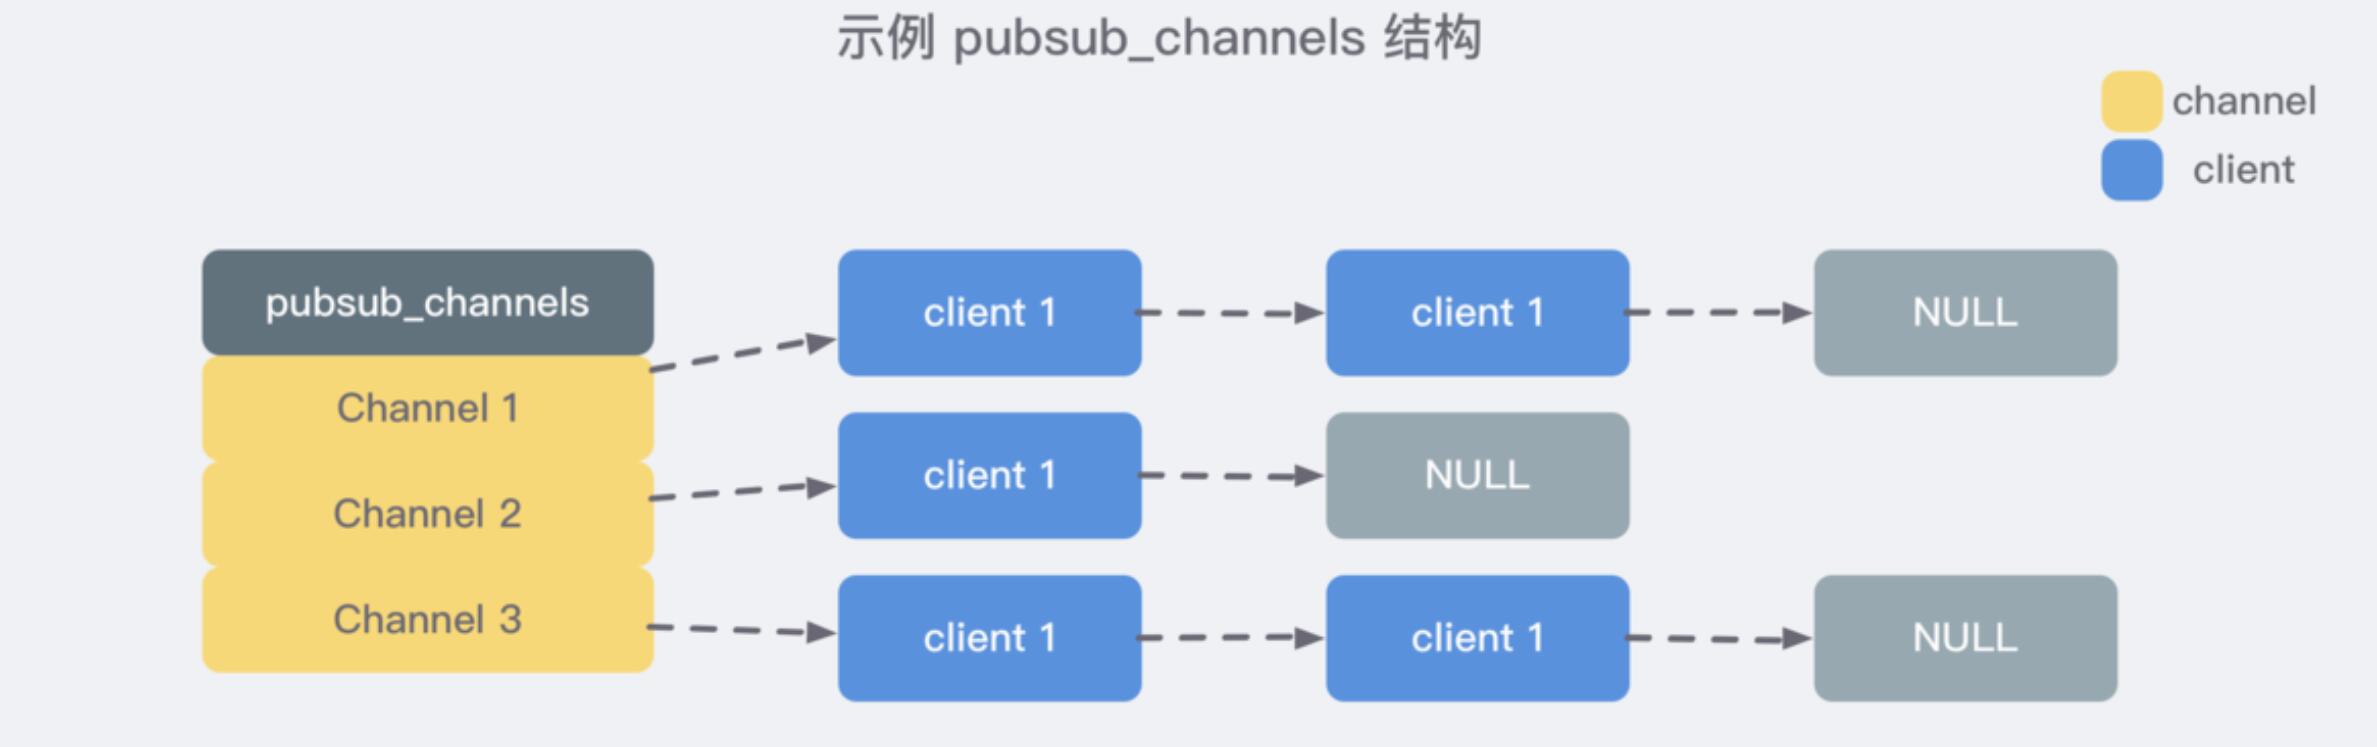
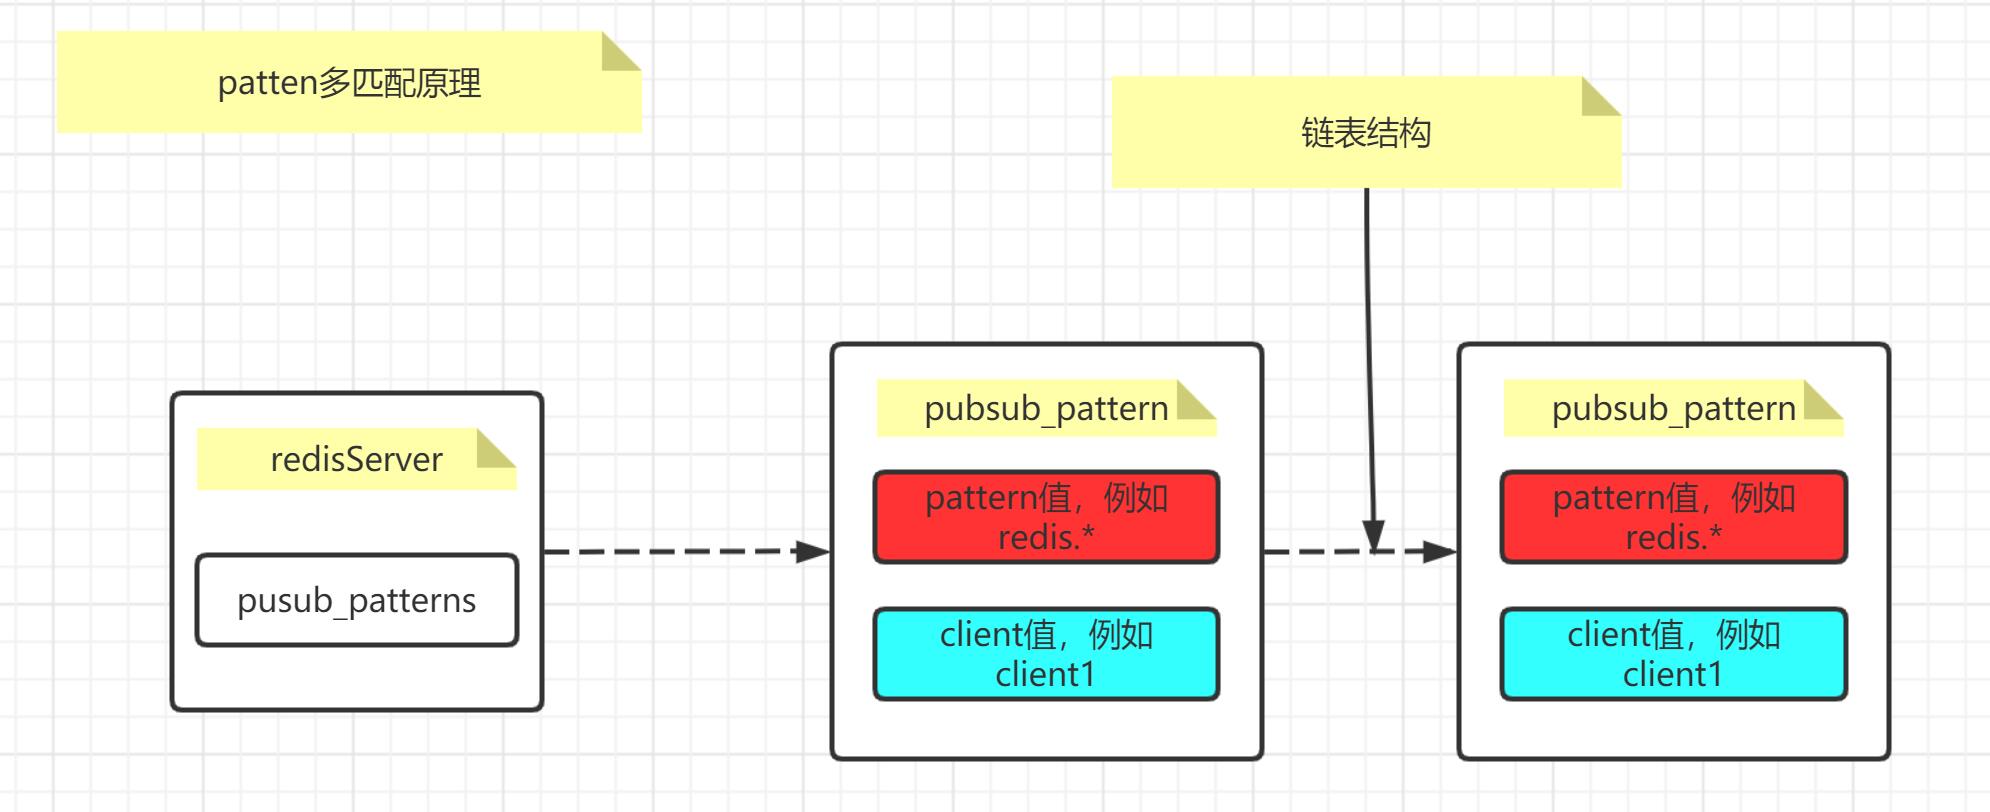
+ 精确匹配
> 订阅某个精确频道,则需要精确的知道这个频道的key值,才可以订阅,比如client订阅redis频道
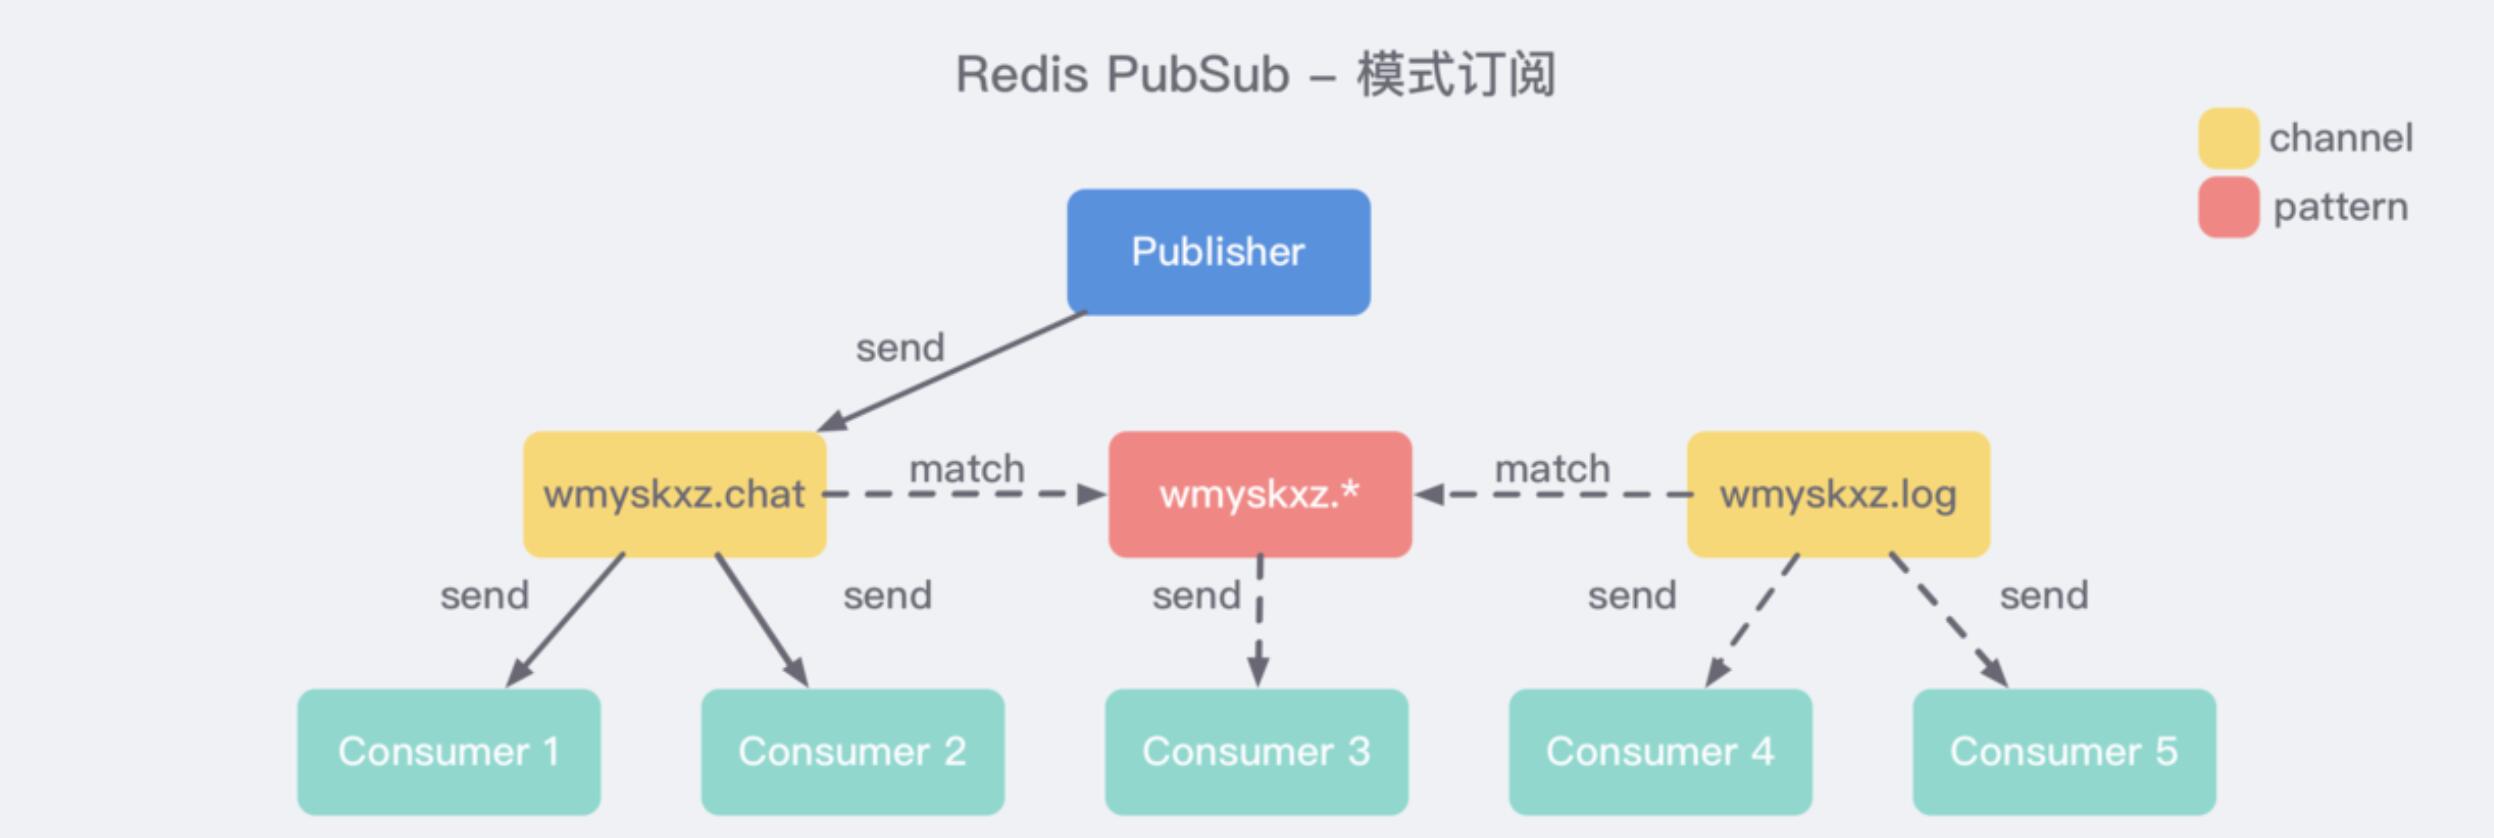
+ 前缀多匹配
> 订阅某种类型的全部频道,也就是说知道某频道类型的前缀,则可以订阅该类型下的全部频道,例如**client订阅redis.*的频道**,
> 则会**订阅redis.log,redis.rdb等一系列符合redis.*的一系列前缀频道**
#### steam
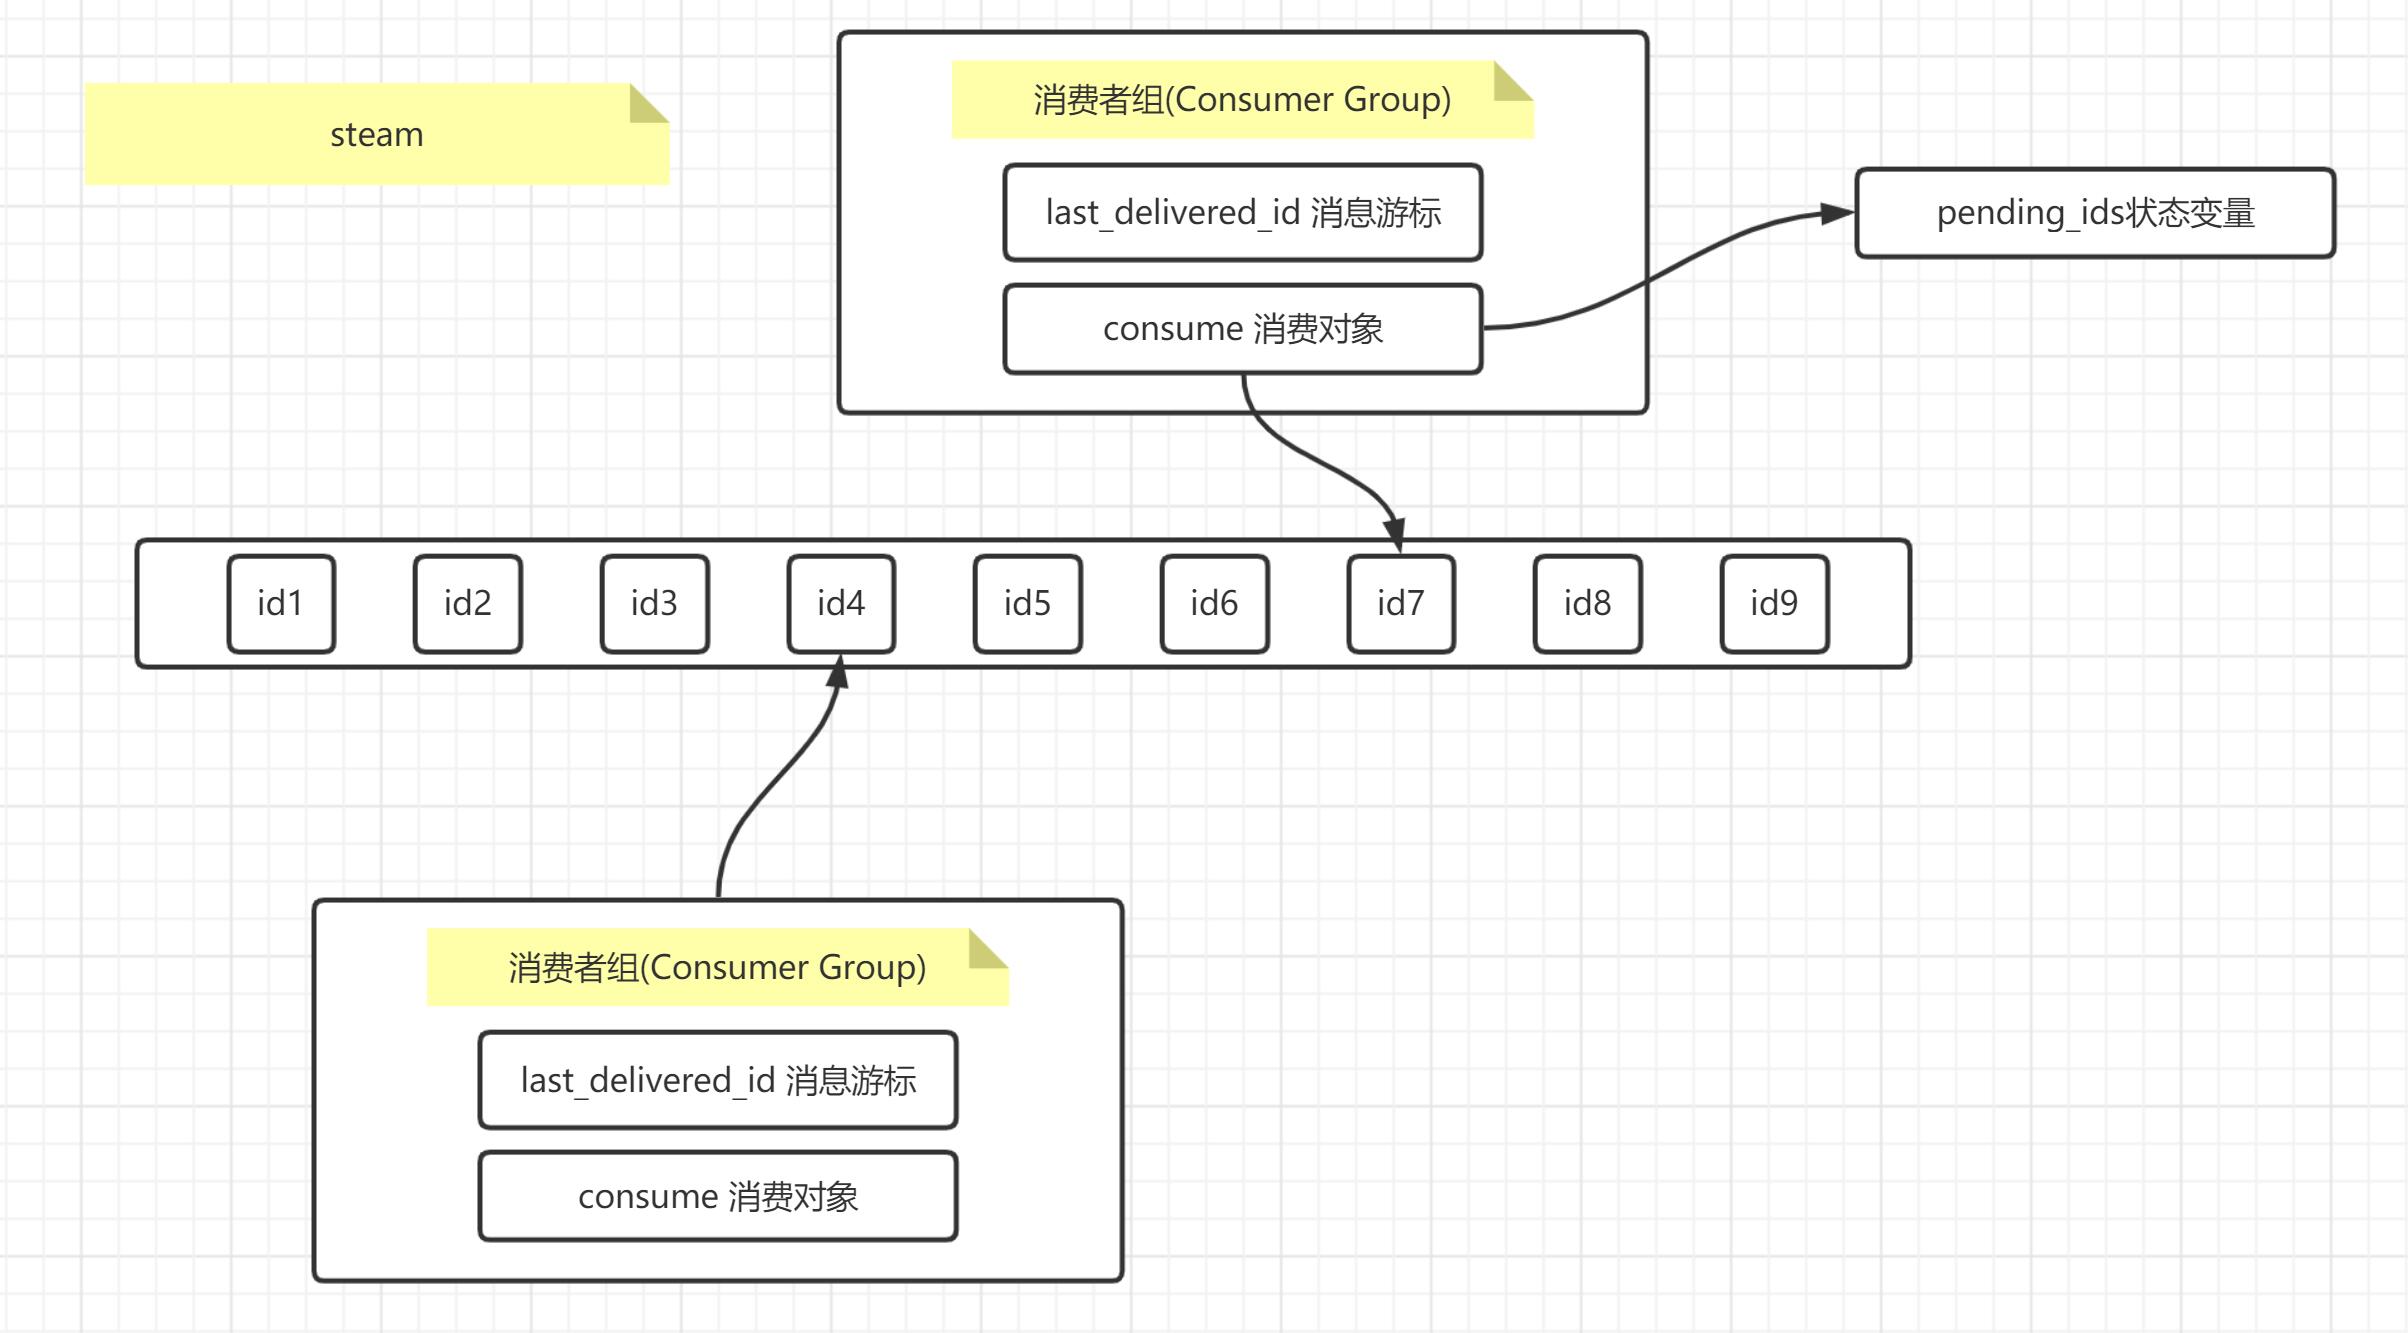
+ Consumer Group:消费者组
> 多个consumer需要某消息的一个群组
+ last_delivered_id:消息游标
> 群组需要哪个消息,则指向这个消息的id,消息 ID 如果是由 XADD 命令返回自动创建的话,那么它的格式会像这样:timestampInMillis-sequence (毫秒时间戳-序列号),例如 1527846880585-5,它表示当前的消息是在毫秒时间戳 1527846880585 时产生的,并且是该毫秒内产生的第 5 条消息。
+ pending_ids:状态数组
> 记录未确认ack的消息的数组,如果客户端发送ack则数组中的内容减少,如果不发送则会一直增加
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论