Storm消息处理可靠性保证

文章目录
Storm可以保证每一个从spout发出的消息能被完全处理。本章描述storm是如何完成这个保证以及用户如何从storm的可靠性能力获益的。
消息“完全处理”的含义
一个tuple从spout发出后可能会触发成千上万的tuple基于它而创建。以work count的topology为例考虑下:
TopologyBuilder builder = new TopologyBuilder();
builder.setSpout("sentences", new KestrelSpout("kestrel.backtype.com",
                                               22133,
                                               "sentence_queue",
                                               new StringScheme()));
builder.setBolt("split", new SplitSentence(), 10)
        .shuffleGrouping("sentences");
builder.setBolt("count", new WordCount(), 20)
        .fieldsGrouping("split", new Fields("word"));
这个topology从Kestrel queue中读取出句子(sentences)_【注:Kestrel为一个scala实现的消息队列组件,参考https://github.com/twitter-archive/kestrel】_, 拆分这些句子为单词,然后发射每一个单词,为了统计这些单词出现的次数。一个从spout发出的tuple会触发很多的基于他的tuple被创建,如代表句子中的每个单词的tuple,代表每个单词计数的tuple。tuple消息呈树的结构:
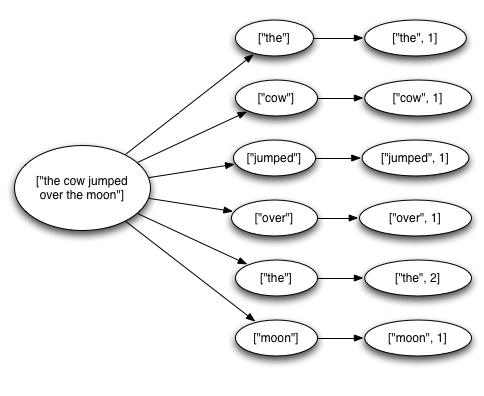
当tuple消息树已经遍历完,并且每一个消息都被处理,则storm认为tuple从spout发出后被完全处理。当tuple消息树上的消息在一个指定的超时时间内没有被完全处理则认为tuple处理失败。这个超时时间可以在topology创建时通过配置 Config.TOPOLOGY_MESSAGE_TIMEOUT_SECS 来指定,默认为30秒。
当一个消息被“完全处理”或“未完全处理”会发生什么呢
讨论这个问题之前,我们先来了解下tuple从spout发出后的生命周期。参考spout的接口实现:
public interface ISpout extends Serializable {
    void open(Map conf, TopologyContext context, SpoutOutputCollector collector);
    void close();
    void nextTuple();
    void ack(Object msgId);
    void fail(Object msgId);
}
首先,storm通过调用Spout的nextTuple()方法请求一个tuple,Spout通过open方法中提供的 SpoutOutputCollector 发射一个tuple到输出流。当发射tuple时spout提供了一个消息ID用于后续唯一标识这个tuple,例如KestrelSpout从kestrel消息队列中读取一条消息后发射时以Kestrel提供的消息id为tuple的消息ID_【KestrelSpout可参考https://github.com/nathanmarz/storm-kestrel/blob/master/src/jvm/backtype/storm/spout/KestrelThriftSpout.java】_。SpoutOutputCollector 发射消息如下:
_collector.emit(new Values("field1", "field2", 3) , msgId);
接下来tuple会被发送给消费的bolts,并且storm会注意跟踪这个被创建的消息树。如果storm检测到一个tuple被完全处理,则会调用原发射它的spout task中的ack方法并传入该tuple被spout发射时的消息ID作为参数。同样如果tuple处理超时,storm会调用spout中的fail方法。注意不管是ack还是fail,都是调用的原来创建该tuple的spout task的方法。所以当spout在集群中以多个并行task的形式执行时,一个tuple不会被除创建它的spout task以外的其他task调用ack或fail。
让我们再以KestrelSpout来看下spout要保证消息的处理该怎么做,当KestrelSpout从Kestrel队列中读取出一条消息,它“打开”了这条消息。这里的意思是这条消息没有真正从队列中脱离,而是被放置到了一个“挂起”的状态等待消息的完成确认。在此期间,该消息不会被其他的客户端消费。此外,如果客户端断开连接了,则该客户端的所有的挂起消息会被重新放回队列。当一条消息被打开,Kestrel提供给客户端消息数据和一个唯一的消息ID,KestrelSpout用这个ID作为storm中发射tuple时的“消息ID”。后续某时刻,当KestrelSpout的ack或fail方法被调用时,KestrelSpout会通过Kestrel客户端确认消息已经被消费或是重新放回消息队列。【注:这里涉及到Kestrel这个消息队列的一个机制: 当某个客户端消费一条消息后,消息会进入一个挂起状态,只有待调用“确认”或“取消”的操作后才能真正确定消息是否真正被消费还是重新回到队列继续被其他客户端消费。】
Storm的可靠性API是什么
作为用户想使用好storm的可靠性必须做到如下两点:
- 无论什么时候你在tuple消息树上创建了新的连接你都要告知storm;
- 当你完成某个独立的tuple的处理时你必须告知storm;
这样storm就能在tuple消息树被完全处理后检测到,并恰当的调用ack或fail。Storm API提供了一个简洁的方式去完成这两点。
指定一个连接在tuple消息树上被称作“锚定”,锚定是在新的tuple被发射后执行的。我们以wordcount中的SplitSentence为例,这个bolt拆分一个包含一条句子的tuple为包含每个单词的tuple:
public class SplitSentence extends BaseRichBolt {
        OutputCollector _collector;

        public void prepare(Map conf, TopologyContext context, OutputCollector collector) {
            _collector = collector;
        }

        public void execute(Tuple tuple) {
            String sentence = tuple.getString(0);
            for(String word: sentence.split(" ")) {
                _collector.emit(tuple, new Values(word));
            }
            _collector.ack(tuple);
        }

        public void declareOutputFields(OutputFieldsDeclarer declarer) {
            declarer.declare(new Fields("word"));
        }
    }
每个单词tuple被锚定是通过调用emit方法时将输入的tuple作为第一个参数。
看下源码注释说明:
/** * Emits a new tuple to the default stream anchored on a single tuple. The emitted values must be * immutable. * * @param anchor the tuple to anchor to * @param tuple the new output tuple from this bolt * @return the list of task ids that this new tuple was sent to */ public List emit(Tuple anchor, List
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论