抖音爬虫,数据采集:热搜、话题抓包分析
文章目录
短视频、直播数据服务,请查看文档: TiToData
免责声明:本文档仅供学习与参考,请勿用于非法用途!否则一切后果自负。
文章来源于互联网,非原创,若侵权,请私信联系我们处理。
我们准备实现的是抖音的热搜榜和话题的相关数据抓取。
抓包工具: charles
模拟器: 木木模拟器
抖音的热搜榜
一:可以直接通过抓包工具获取接口
将获取到的接口地址复制出来(简化后):
https://aweme-hl.snssdk.com/aweme/v1/hot/search/list/
接着就可以直接请求,来获取热搜数据了。
二:通过热搜的分享页面获取接口
点击右上角的分享选项,复制链接后,用浏览器打开。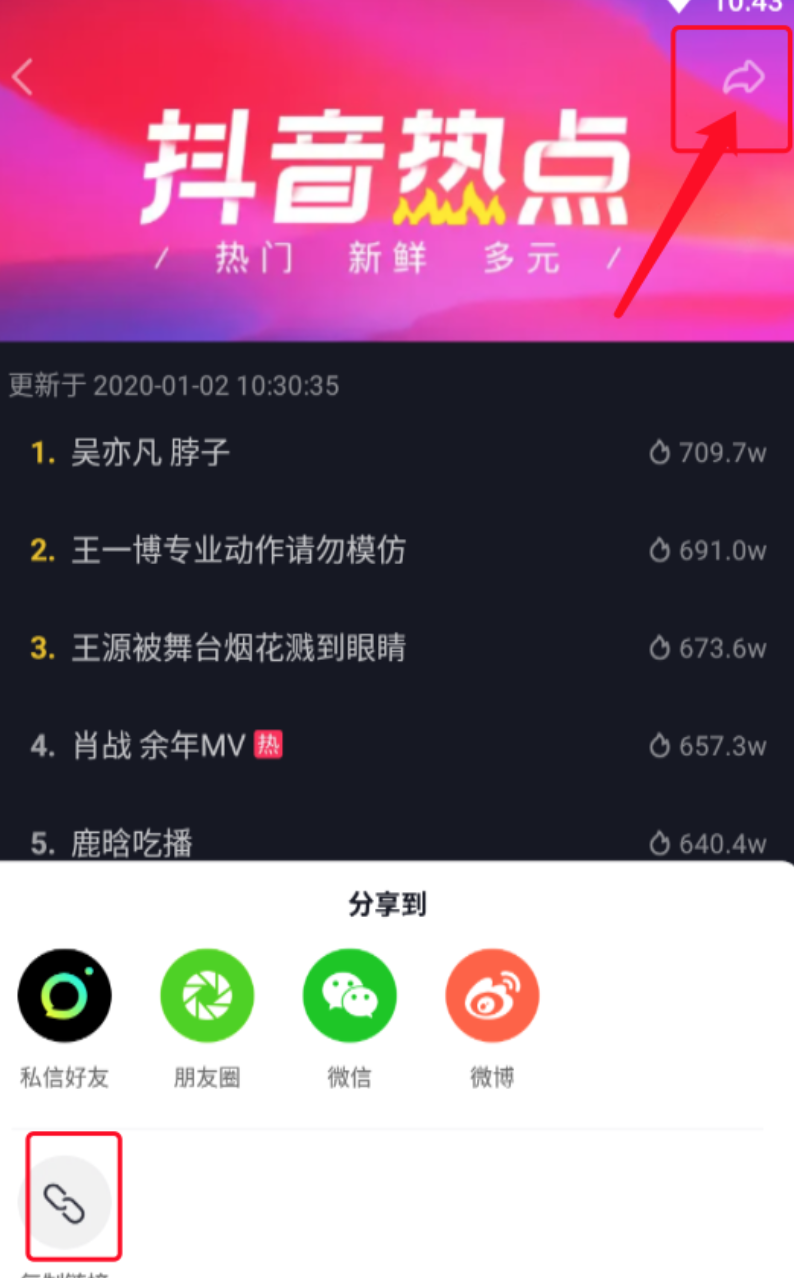
在浏览器中打开后 https://www.iesdouyin.com/share/billboard/
同样也可以获取到接口地址。可直接进行get请求
https://www.iesdouyin.com/web/api/v2/hotsearch/billboard/word/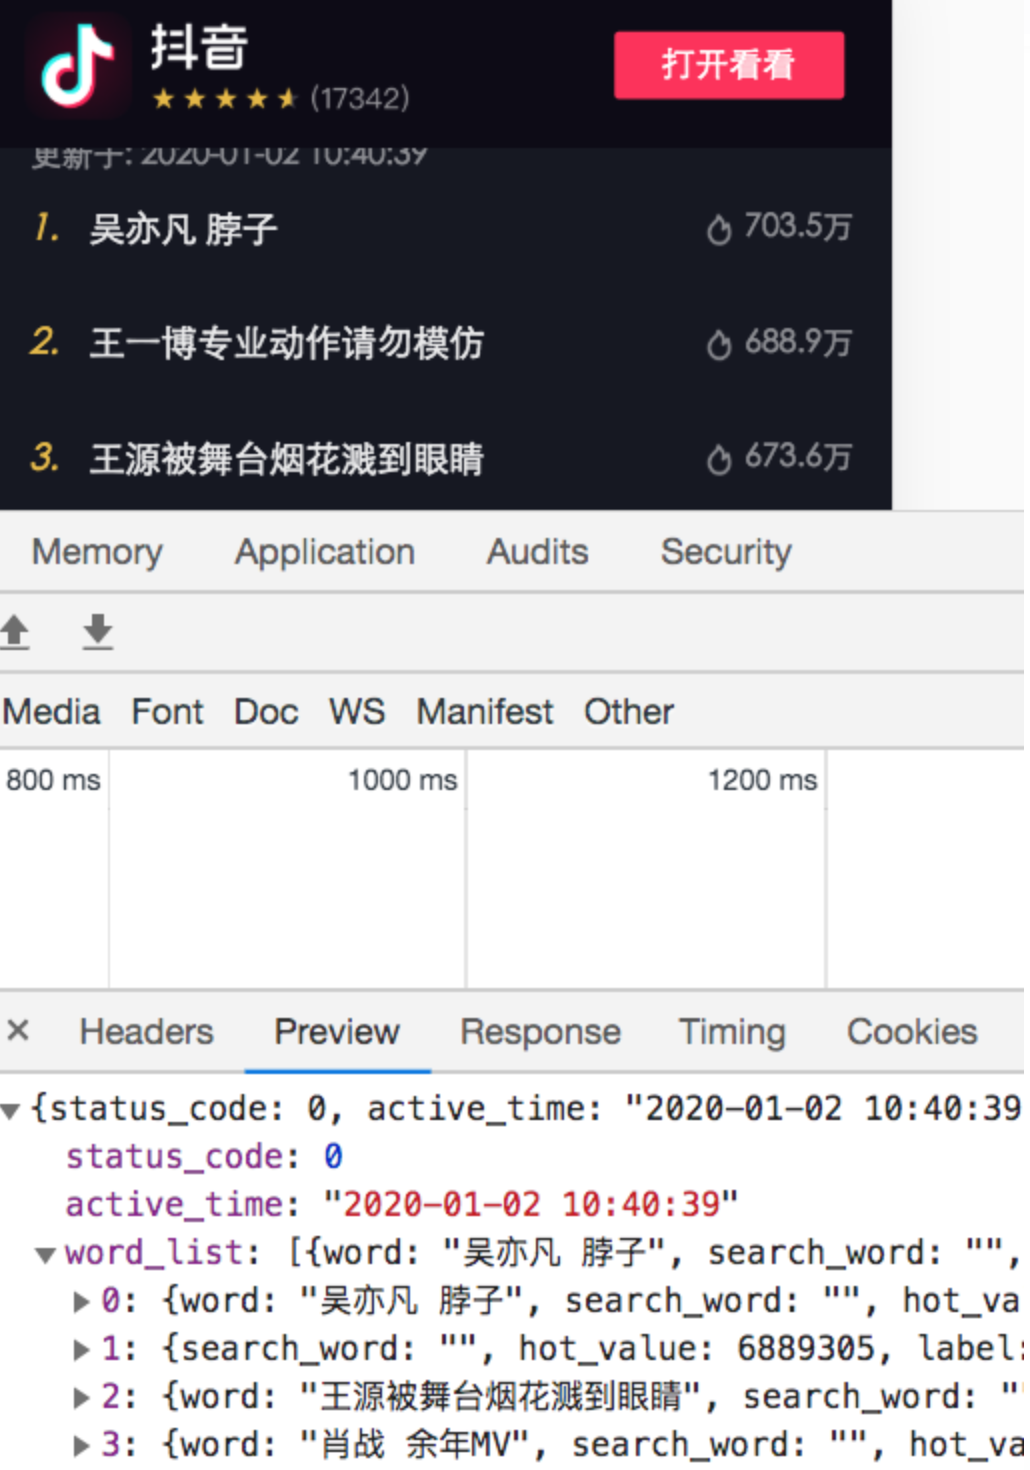
热搜下对应的话题数据
我们点击一个话题,来找一下热搜下对应的话题数据:
右上角的播放量数据在
https://aweme-hl.snssdk.com/aweme/v1/hot/search/list/?&source=3&os_api=23&version_code=860
我们通过寻找其他数据的接口,将链接复制下来(简化后):
https://aweme-hl.snssdk.com/aweme/v1/hot/search/video/list/?hotword=吴亦凡 脖子
想要的数据就有了,比如当前话题总参与人数,可以直接GET请求接口来解析数据。
热搜的数据很简单就可以获取到,
但是目前针对于指定话题,一些加密的参数还没有研究明白。欢迎大家留言交流
但是为了实现话题数据的抓取,不得不另寻他路,没想到还真找到了其他的接口。
指定话题的数据获取方法
以一个话题示例:
我们需要的是该话题对应的播放量和视频数量。
通过抓包,找到了如下接口:
https://aweme-hl.snssdk.com/aweme/v1/challenge/detail/?query_type=0&ch_id=1635753360881672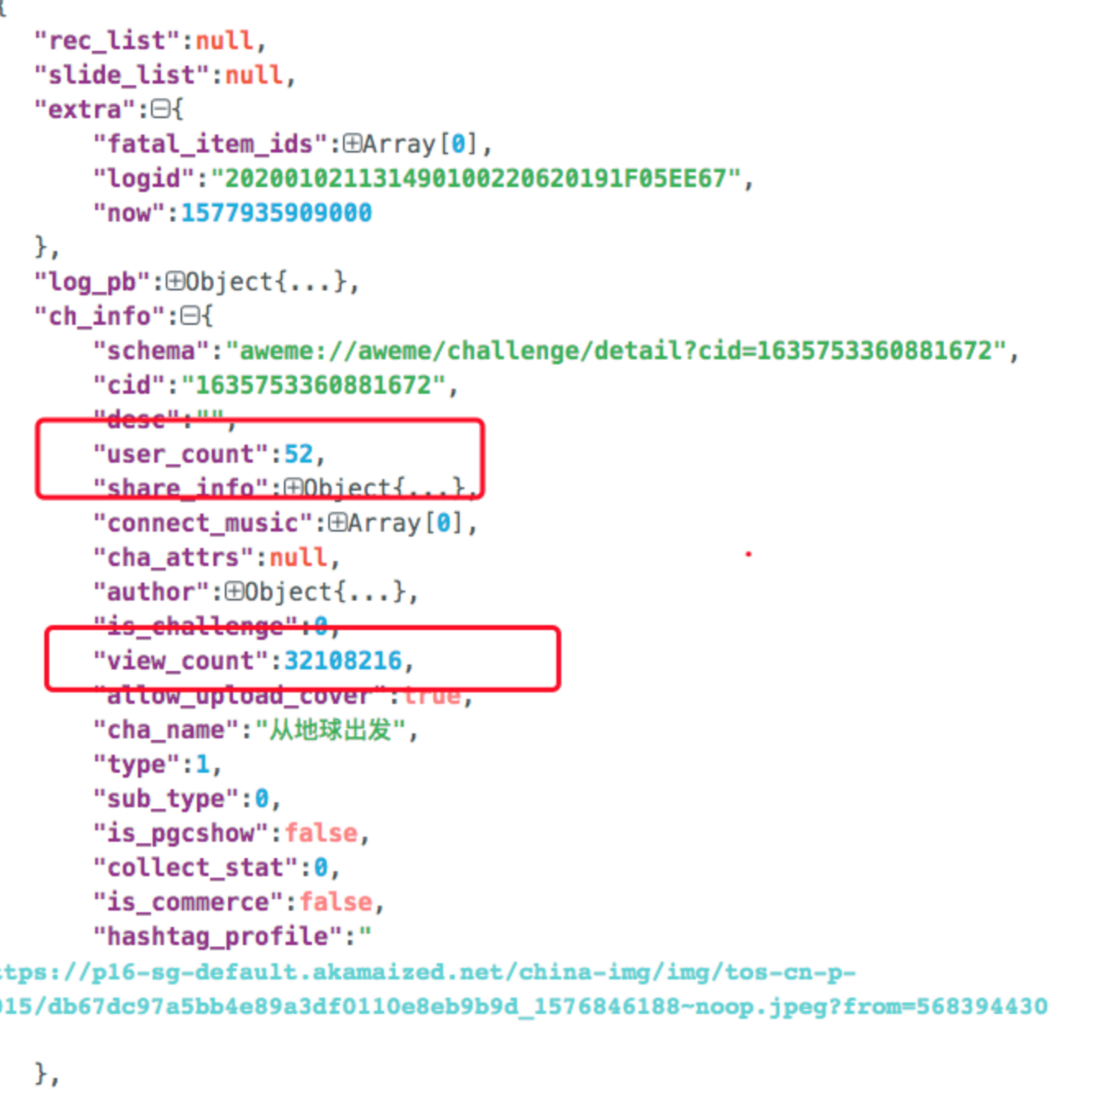
这里需要 ch_id 才能获取到我们需要的数据。
如何才能简单快捷的获取到这个ch_id呢,经过一段时间的分析。
我发现: 该话题《从地球出发》的ch_id:1635753360881672,
可以在该相关用户的详情中找到。
那么还是老方法,获取分享页面的链接,从浏览器打开
查看分享页面中的接口数据。
果不其然,找到了我们需要的id。
话题下的视频详情:
那么如何获取话题下的视频详情呢,回到模拟器,又发现了右上方的分享选项
将链接复制下来之后,使用浏览器打开,在接口中可以找到我们所需要的数据
https://www.iesdouyin.com/share/challenge/1635753360881672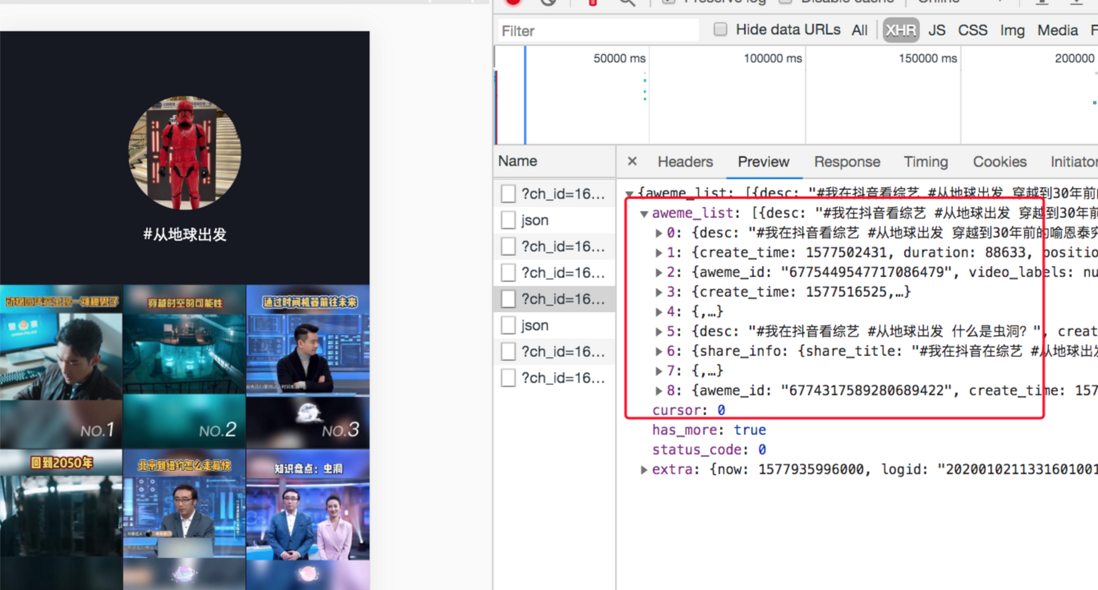
观察一下这个接口的参数
ch_id 已经知道了,
_signature 签名,在之前的文章中有讲解过。这里就不再重复了。
代码部分
案例代码,相对比较简介,需要大家自行完善。
热搜榜数据:
import requests
import pprint
# 抖音热搜榜
hot_search = 'https://aweme-hl.snssdk.com/aweme/v1/hot/search/list/?detail_list=1'
headers = {"User-Agent":"Mozilla/5.0 (Linux; Android 5.0; SM-G900P Build/LRX21T) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/79.0.3945.88 Mobile Safari/537.36"}
hot_json = requests.get(hot_search,headers=headers).json()
hot_list = []
for data in hot_json['data']['word_list']:
    item = {}
    keyword = data['word']
    hot_value = data['hot_value']
    item[keyword] = hot_value
    hot_list.append(item)
pprint.pprint(hot_list)
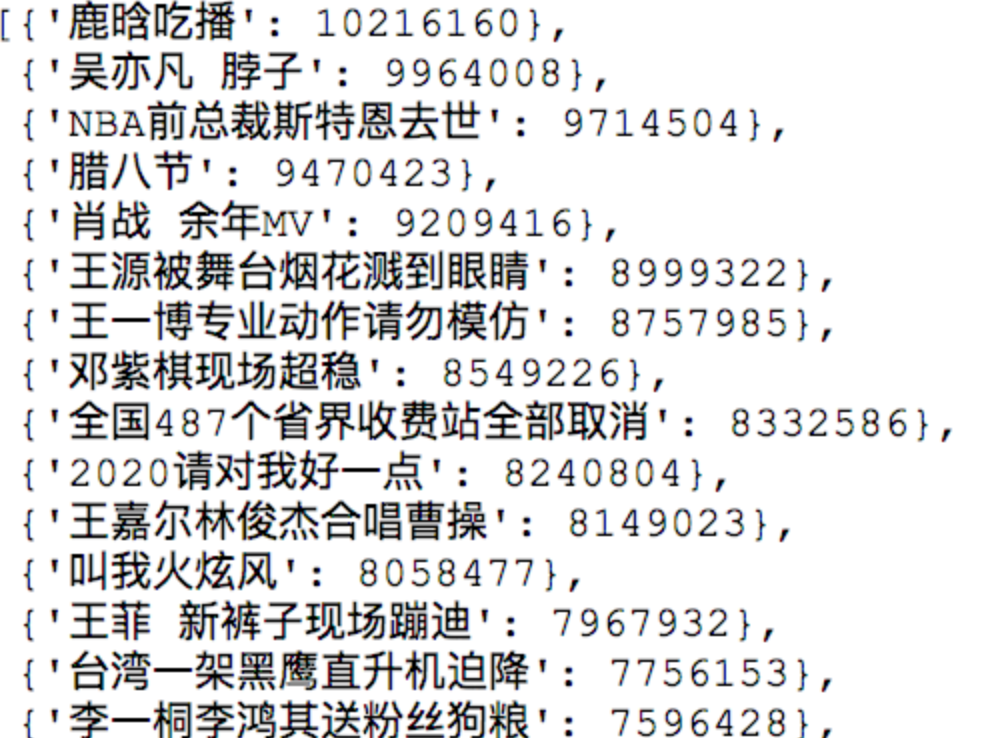
热搜词对应的阅读人数
这里取其中一个热搜词。
import requests
headers = {"User-Agent":"Mozilla/5.0 (Linux; Android 5.0; SM-G900P Build/LRX21T) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/79.0.3945.88 Mobile Safari/537.36"}
hot_word = '鹿晗吃播'
hot_reading = 'https://aweme-hl.snssdk.com/aweme/v1/hot/search/video/list/?hotword={}'.format(hot_word)
hot_json = requests.get(hot_reading,headers=headers).json()
print("持续时间:",hot_json['aweme_list'][2]['duration'])
print("热度值:",hot_json['aweme_list'][2]['hot_info']['value'])
print("当前排名:",hot_json['aweme_list'][2]['hot_info']['rank'])
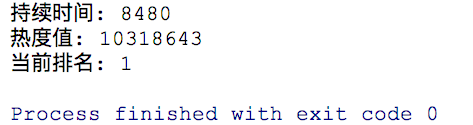
单个话题阅读量
import requests
dy_topic = 'https://aweme-hl.snssdk.com/aweme/v1/challenge/detail/?query_type=0&ch_id=1635753360881672'
headers = {"User-Agent":"Mozilla/5.0 (Linux; Android 5.0; SM-G900P Build/LRX21T) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/79.0.3945.88 Mobile Safari/537.36"}
topic_json = requests.get(dy_topic,headers=headers).json()
view_count = topic_json['ch_info']['view_count'] # 阅读量
print(view_count)
如果对大家有帮助或者有疑问,欢迎点赞👍留言!
更新
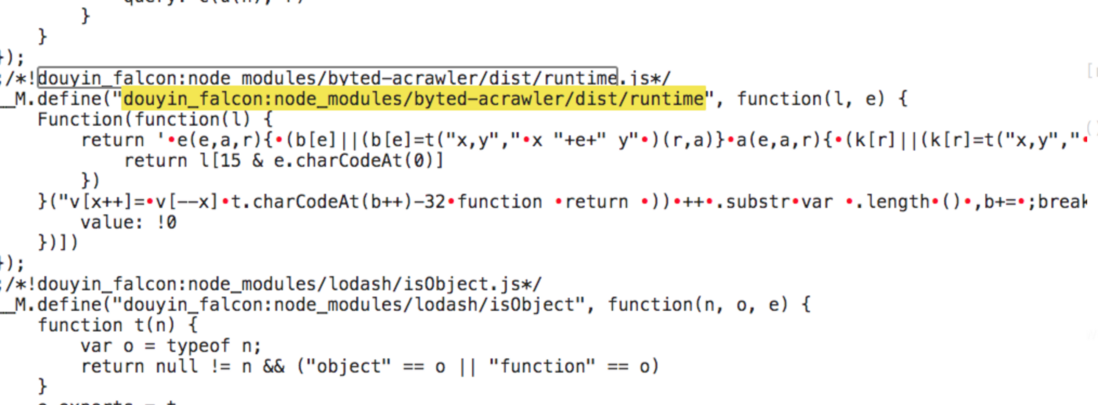
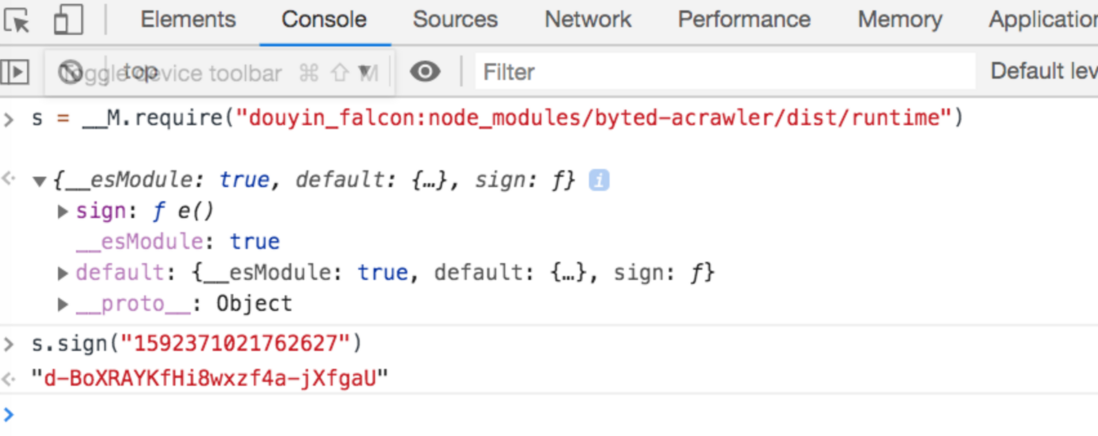
发现 分享页面中话题的 sign 和 个人主页的生成方法一样的。
并且话题视频的get请求中,不需要dytk,带上 ch_id 和 _sign即可。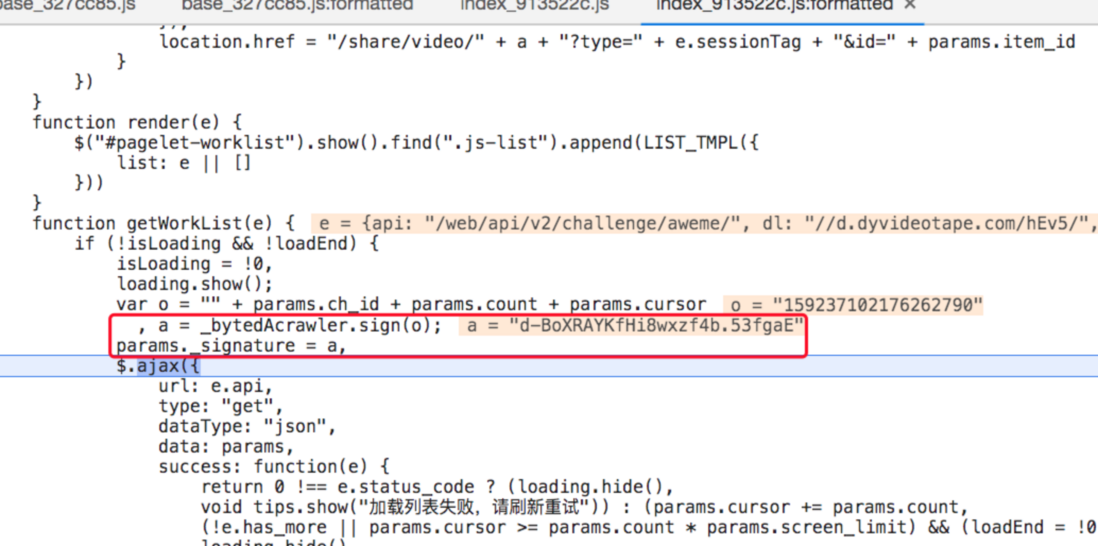

——————————————————————————————————————————
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论