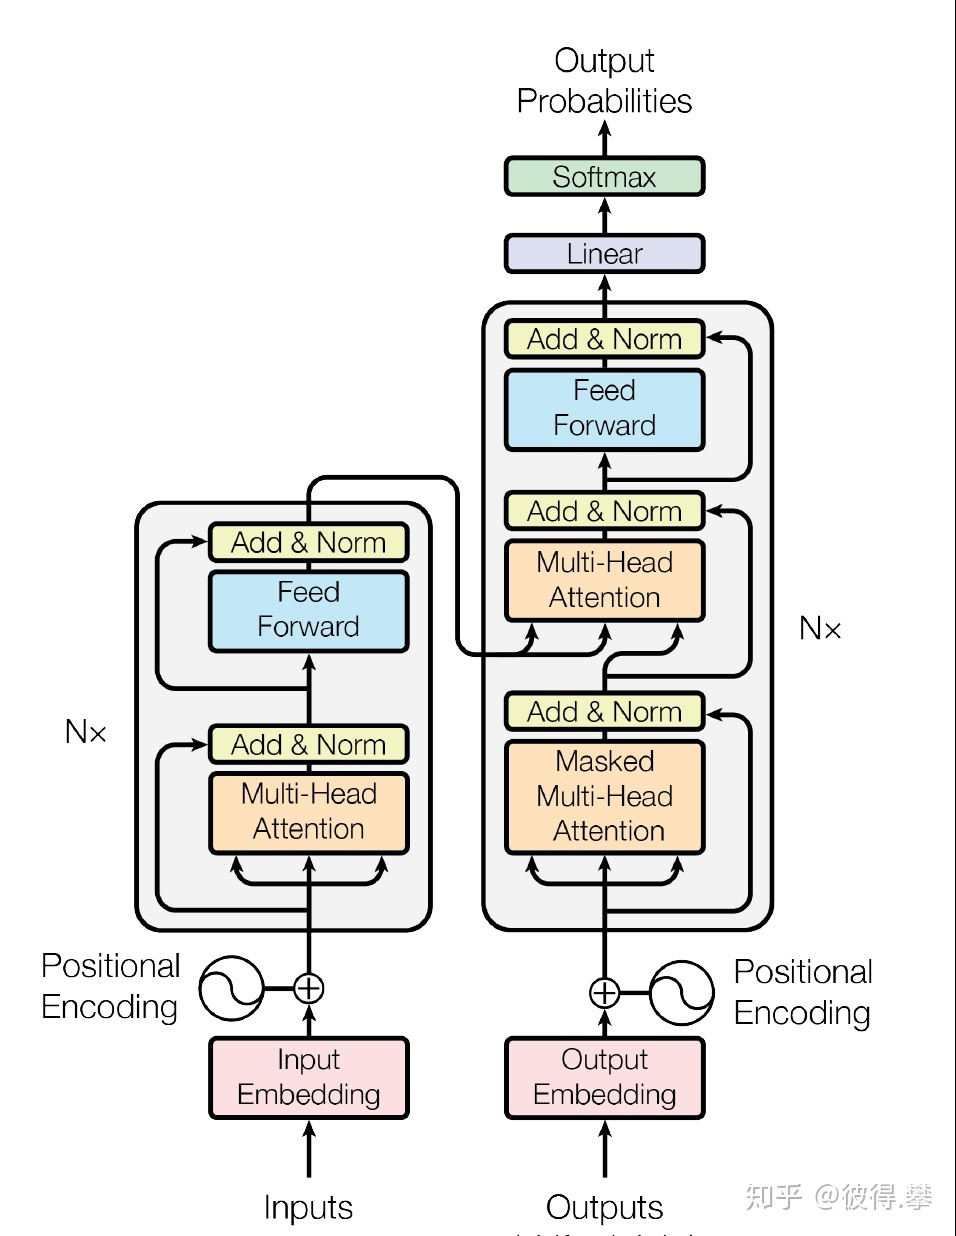
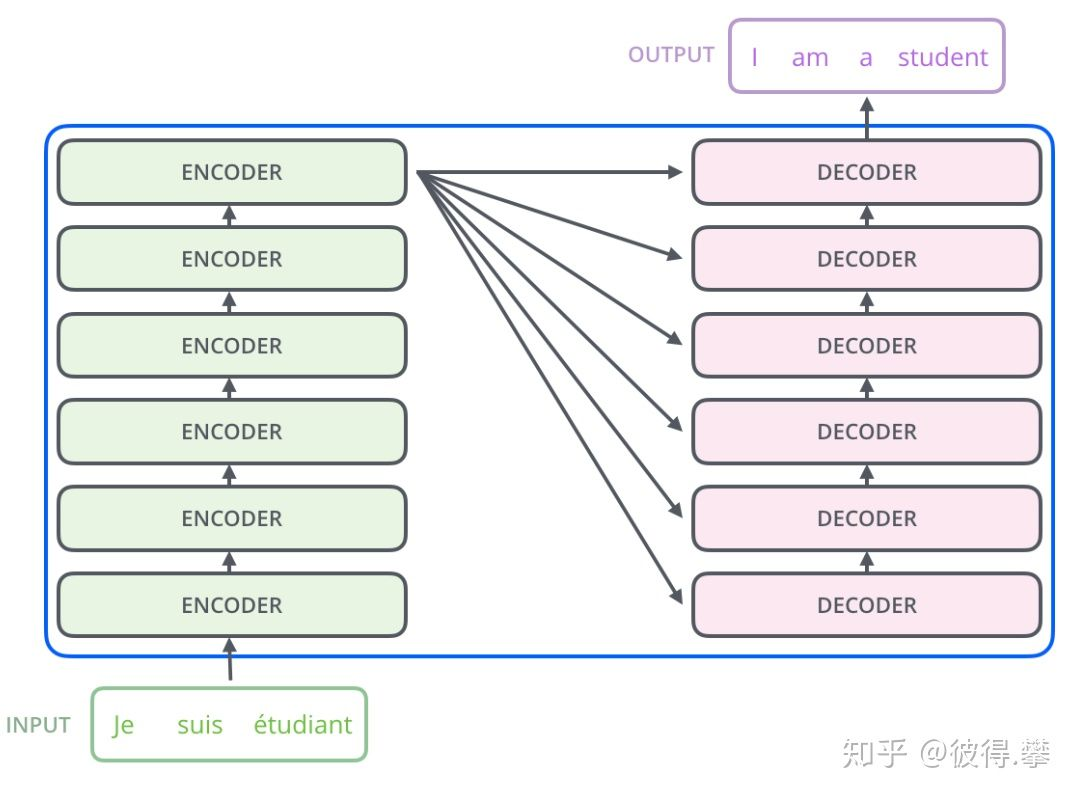
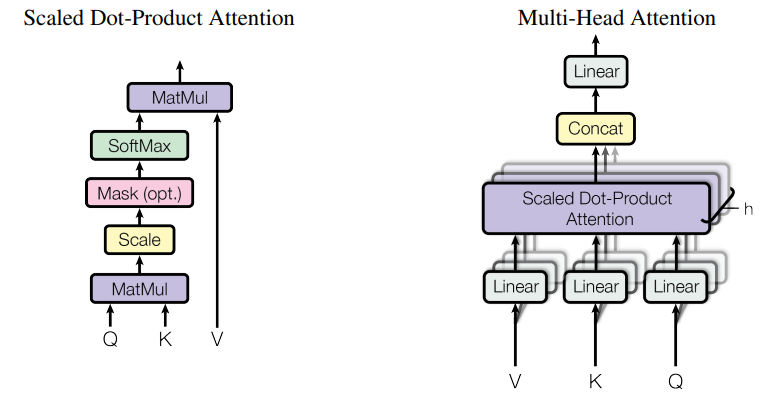
博客 / 机器学习Transformer相关代码浮梦人2022年2月23日775 阅读文章目录架构图注意点第一个点 为什么要用scaled attentionhttps://blog.csdn.net/qq_3743...Q,K的维度越高,QK的内积方差越大。QK的内积方差越大,softmax后,会出现有的维度接近1,其余接近0,的现象,这种情况下,梯度是最低的,接近0,学习效率低。第二个点 Multi-Head Attention# 机器学习# 算法
架构图注意点第一个点 为什么要用scaled attentionhttps://blog.csdn.net/qq_3743...Q,K的维度越高,QK的内积方差越大。QK的内积方差越大,softmax后,会出现有的维度接近1,其余接近0,的现象,这种情况下,梯度是最低的,接近0,学习效率低。第二个点 Multi-Head Attention
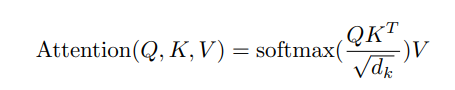

评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论