我所知道的算法之排序算法与时间复杂度与空间复杂度
文章目录
作者前言
大家好,我是阿濠,今篇内容跟大家分享的是算法里的排序算法介绍与算法的时间复杂度与空间复杂度,很高兴分享到segmentfault与大家一起学习交流,初次见面请大家多多关照,一起学习进步
一、排序算法的介绍
排序也称排序算法(Sort Algorithm), 排序是将一组数据,依指定的顺序进行排列的过程。
排序的分类
排序有内部排序和外部排序,内部排序是数据记录在内存中进行排序,而外部排序是因排序的数据很大,一次不能容纳全部的排序记录,在排序过程中需要访问外存。我们这里说说八大排序就是内部排序。

二、算法的效率的度量方法
我们设计算法的时候,要尽量提高效率,这里的效率指的是算法的执行时间
那么我们如何来度量一个算法的执行时间呢?
简单的方法则是把算法跑若干次,然后拿个计时器计时,求出平均时间,这是马拉松的求法,这是事后统计方法,当然我们也不需要真的那个计时器来算。因为我们可以使用计算机来帮我们算嘛
事后统计法:
1.准备好设计好的测试程序和数据
2.通过利用计算机计时器对不同算法编制的程序的运行时间
3.讲运行时间进行比较,从而确定算法的效率高低
但是这种方法是有很大的缺陷的
1.必须依据算法实现编制测试的程序,这就要花费大量时间和精力
2.测试完发现这是一个糟糕的算法,那不是功亏一篑了?
3.不同的测试环境(电脑性能等)差别不是一般的大!
为了对算法评估更为科学和便捷,有的前辈研究出了事前分析估算的方法
事前估算的法:
在计算机程序编写前,依据统计方法对算法进行估算,我们发现一个高级程序语言编写的程序在运行所消耗的时间取决于以下因素:
1.算法采用的策略、方案
2.编码产生的代码质量
3.问题的输入规模
由此可见,抛开这些因素于计算机硬件、软件相关的问题,一个程序的运行时间依赖于算法的好坏和问题的输入规模
举个高斯的求值方法1+2+3+4+5...+100案例
普通的第一种算法,一个一个的加
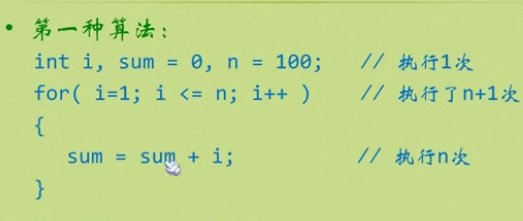
假设若是从1+2+3..+1000000的时候?那就需要1000000次
普通的第二算法,只需加一次
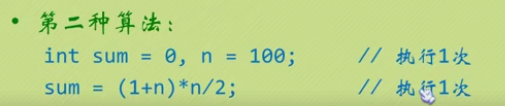
+1000000的时候,也只需要执行一次则可以得出答案
我们会发现,第一种算法与第二种算法进行比较的话
1.第一种算法执行了1+(n+1)+n次=2n+2次
2.第二种算法执行了1+1=2次
如果我们忽略头和尾,把循环看作一个整体,其实就是n和1的差距
我们再来看第二个列子
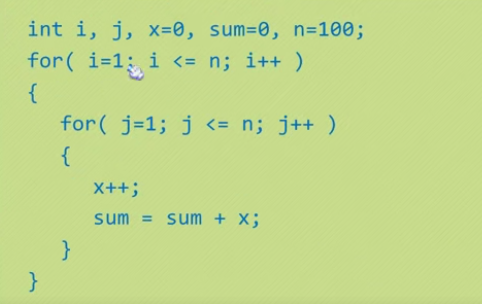
如果要让i从1走到100 那么需要每次都先让j从1走到100次,那么这种情况这是100^2次(100的平方)
最终不关心编写程序所用的语言、也不关心程序跑在什么计算机上,甚至不计较循环索引和终止循环的条件、声明变量、打印结果等等操作,只关心所设计的算法或一些列操作,再将基本操作的数量与输入模式关联起来
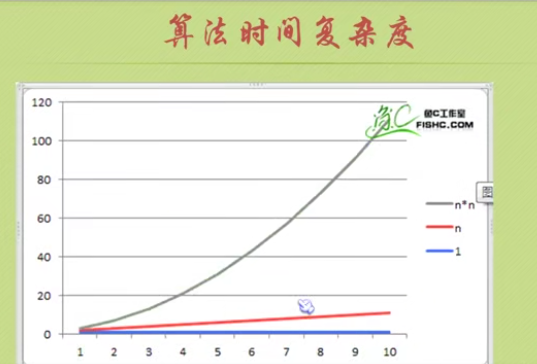
以刚刚的例子用图来解释一下

蓝线1则是无论数是多大,都将只执行一次
红线n则是数是多大,就执行多次
灰线则是数是多大,都将执行平方,比如所你输入1,则是 1*1 、输入 2则是2*2、求一百则是100*100
三、函数的渐近增长
做一个测试:以下两个算法A和B那个更好?
假设两个算法规模都是输入n
算法A要先做2n+3次,比如说先执行n次循环,执行完再做一次n次循环,最后再进行三次运算
算法B要先做3n+1次,比如说先执行n次循环,执行完再做一次n次循环,最后再做一次n次循环,再执行一次运算
你觉得是哪个更快呢?
我们来做一个表格图来比较一下

当n=1时,算法A1不如B1当n=2时,算法A1和B1两者效率相同,当n>2时,算法A1就比B1,且随着n增加,算法A和算法B就拉开差距了
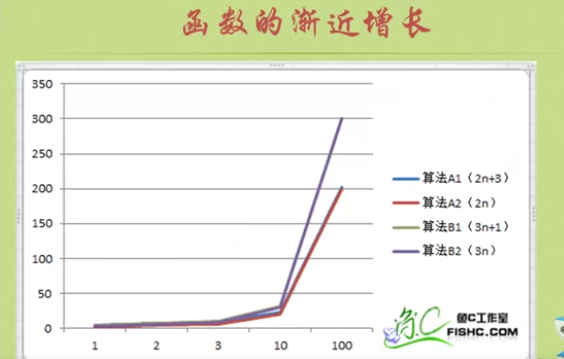
从刚才的对比中,我们发现随着n增大,后面的 +3或者+1 都不影响最终的算法变化曲线的,再图中,他们压根就被覆盖了,所以可以忽略这些常数
第二个测试,算法C是 4n+8 ,算法D是 2N^2+1
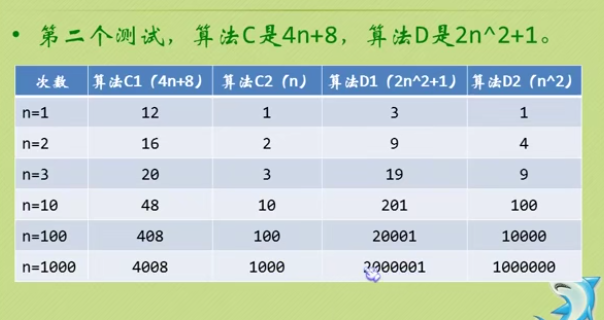
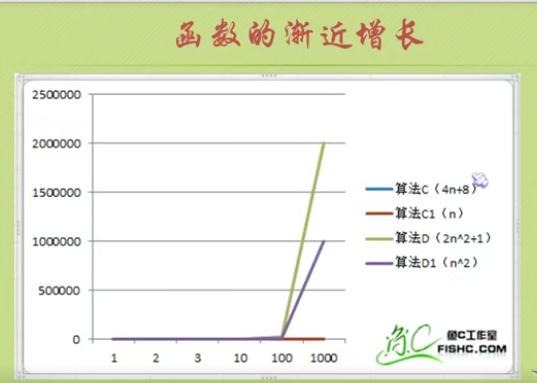
最终给我们发现哪怕是去掉常数,那么 4n+8 与 n 就看上去基本平行了,两者的结果还是没多大变化,与高次项相乘,常数即可忽略
第三个测试,算法E是2n^2+3n+1、算法F则是2n^3+3n+1

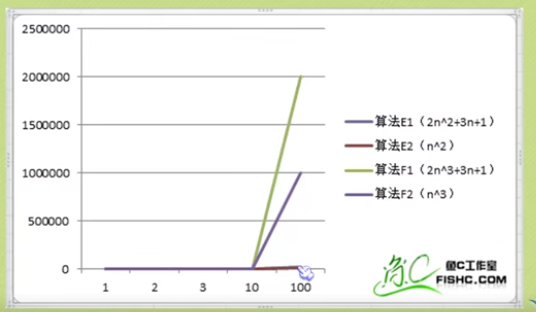
随着n的增大,我们可以看到 n^2 是比 n^3差别是非常大 的,这是不可取的
前三个测试,我们发现高次项的指数大的,随着n的增长,也会变得非常大,意思就是说n^3、n^2随着n得到的数会变得很大
第四个测试,算法G是2n^2、算法H是3n+1、算法I是2n^2+3n+1
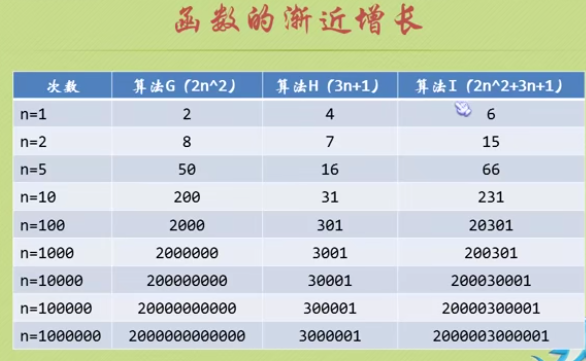
发现算法G和算法I,在n等于1000000的时候,执行的数非常的大,并且没有多少差距,而算法H差不多可以忽略,无法进行比较,那么我们将数字放小,做一个比较

于是我们得到一个结论函数中的常数和其他次要项常常可以忽略,所以主要关注的是主项(高次项)
比如说n^2+3n+1 里n^2是主项、 2n^3+3n+1里n^3是主项、3n+1里n是主项
四、算法的时间复杂度
有了前面的铺垫,那就好讲时间复杂度攻略。
算法时间复杂度的定义:
语句总的执行数T(n)是关于问题规模n的函数,进而分析T(n)随n的变化情况并确定T(n)的数量级。算法的时间复杂度,也就算法的时间量度记作:T(n)=O(f(n)),它表示随着问题规模n的的增大,算法执行时间的增长率相同,称作算法的渐近时间复杂度,简称为时间复杂度。其中f(n)是问题规模n的某个函数
我们用大写O来体现算法时间复杂度的记法,我们称为大O记法
根据前面的测试我们可知算法时间复杂度分别为O(1)、O(n)、O(n^2)
推倒大O阶方法
有以下思路:
1.用常数1取代运行时间中的所有加法常数
(比如说有三条加法常数指令、八条输出指令等等这些就用1来代替)就不用说O(几)多少多少
2.在修改后的运行次数函数中,只留最高次项比如说n^2/n^3
3.如果最高项存在且不是1,则去除与项相乘的常数(比如说3N^2,我们则只认O(N^2))
4.得到最后的结果大O阶
我们做几个错误的示范:
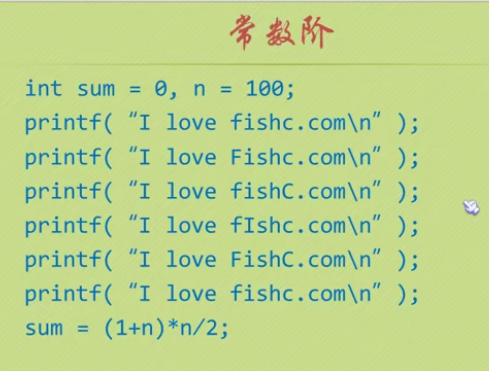
这段代码的大O是多少?O(8)?
O(8)是常犯的错误,上面思路提到,输出指令等等就用1代替,这是与问题规模无关的数据,所以使用O(1)就可以了

这段代码的大O是多少?
它的时间复杂度为O(n),因为循环体中代码需要执行n次

这段代码的大O是多少?
n等于100的时候,也就说外层循环执行一次,里面循环就要执行100次,那莪总共的执行时间则是100*100次,也就是说是n的平方,所以这段代码时间复杂度为O(n^2)
如果有三个嵌套循环呢?即是n^3啦,所以我们总结得出循环的时间复杂度等于循环体的复杂度乘以该循环运行的次数。

这段代码的大O是多少?
当i=0的时候,内嵌j则做了n次(100次)
当i=1的时候,内嵌j则做了n-1次(99次)1-99
当i-2的时候,内嵌j则做了n-2次(98次)1-98
....找到规律后则是
n+(n-1)+(n-2)+...+1=100+99+98+...+1
是不是很像1+2+3+4+...+100呢?
套用高斯算法后则是n(n+1)/2=(n^2)/2+n/2
按照思路保留最高次项所以n/2去掉,存在最高项且不是1,则去掉与项相乘的常数,最终得到O(n^2)

这段代码的大O是多少?
由于每次都是i=i\*2之后,就会离n越来越近,i=2、4、8、16、32....
有没有发现它好像是n的多少次方噢,假设有x个2相乘,那么最后会大于或者等于n的,就会结束循环。
由于2^x=n, x则是我们的循环次数,即得到x=log2n 所以循环的时间复杂度为O(log)n
那么就会有人问log2n是个什么东西,为什么2^x=n,x=log2n?
在数学中,log表示对数。
比如 2 的三次方=8,那么log2(8)=3就是求2的多少次方等于8
这样就不难理解了,刚刚我们的2^x=n,那么x=log2n,分解出来着是
假设x=1,2^1=2,那么反过来求x的时候即是x=log2(2),那么求2的多少次方等于2?答案是x=1
假设x=2,2^2=4,那么反过来求x的时候即是x=log2(4),那么求2的多少次方等于4?答案是x=2
假设x=3,2^3=8,那么反过来求x的时候即是x=log2(8),那么求2的多少次方等于8?答案是x=3
......
五、函数调用的时间复杂度分析
我们根据前面的内容,把东西更实际分析理解
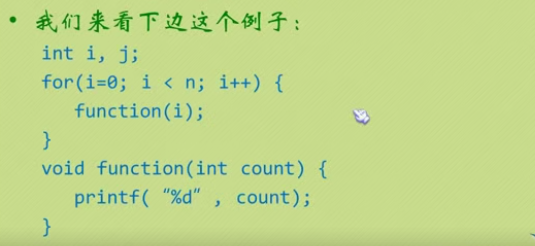
我们来分析一下:
1.function函数里方法体是输出语句,即使时间复杂度O(1),为什么?根据思路第一条,输出指令都通常为O(1)。
2.for循环则是n=多少就做多少次,所以总体得时间复杂度为O(n)
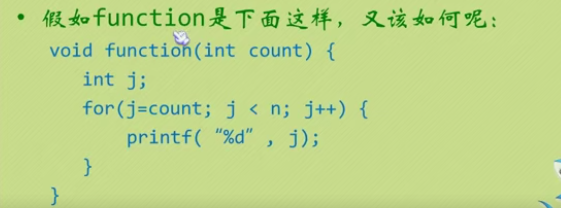
我们来分析一下:
1.function函数里面方法体有一个循环,即是O(n),那么外面又有一个循环,也做了O(n)次
2.但是外面的循环做一次,函数里就要做O(n)次,外面循环做n次,就是即n\*n了,所以总体的时间复杂度为O(n^2)
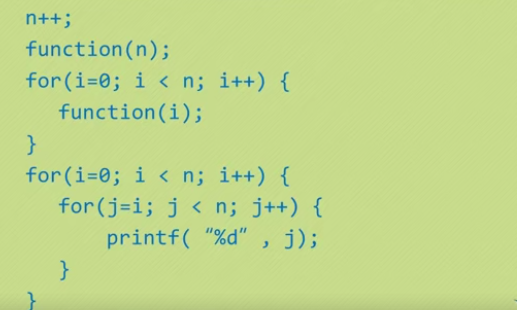
我们来分析一下:
1.n++ 按照思路则是O(1)
2.function(n)即是上一个例子里的O(n^2)
3.for循环里有fucntion那即是也是O(n^2)
4.两个for里即也是O(n^2)
并列起来即使3(n^2)+1,根据我们的思路则则是O(n^2)
为什么?保留最高次项数,去掉常数
六、常见时间复杂度
根据前面的思路,看看表格信息熟悉熟悉

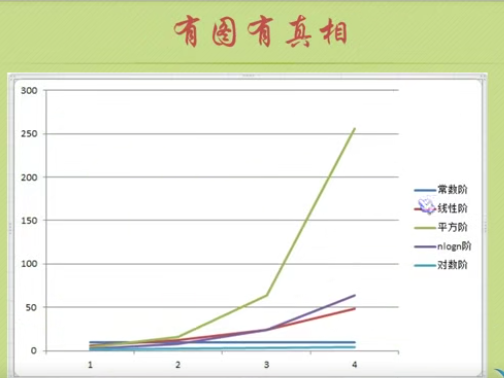
我们发现随着数据的增长,时间差距慢慢就出来了,那么数据变大的时候呢?

那么根据前面的列子总结时间复杂度信息,我们就会发现常见的从小到大顺序
O(1)<O(logn)<O(n)<O(nlogn)<O(n^2)
最坏情况与平均情况
比如说我们查找一个有n个随机数字数组中某个数字,那么最好的情况就是第一个数就是我们要找的,即是O(1),但也有可能需要查找n次才能找到,即是O(n),那么平均时间即是我们期望的运行时间
最坏时间即使我们的保证,通常除非特别指定,我们得到的运行时间都是最坏情况的运行时间
七、算法的空间复杂度
我们在写算法时,可以使用空间去换时间,或者时间换空间,举个例子来说我们判断某年是不是闰年,你可能花心思来,算每年的月份里的信息
另一种方法则是 事先建立一个有2050个数组,把所有年份按照下标的数字对应,如果是闰年就该数组的元素为1,如果不是则是0,这样所谓是否闰年就变成了某一个元素的值
这就所谓的空间换时间了,哪一种好?还要看你用在什么地方
算法的空间复杂度通过计算所需要的存储空间实现
算法的空间复杂度公式:S(n)=O(f(n))
通常我们使用时间复杂度来指运行时间的需求,使用空间复杂度指空间需求
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论