Machine Learning 这四个东西,你知道吗
文章目录
感谢平台分享-http://bjbsair.com/2020-04-10...
分类变量特征提取
分类数据的独热编码方法,分类变量特征提取(One-of-K or One-Hot Encoding): 通过二进制数来表示每个解释变量的特征
from sklearn.feature_extraction import DictVectorizer
onhot_encoder = DictVectorizer()
instances=[{'city':'New York'},{'city':'San Francisco'},{'city':'Chapel Hill'}]
print (onhot_encoder.fit_transform(instances).toarray())


[[0. 1. 0.]
 [0. 0. 1.]
 [1. 0. 0.]]
文字特征提取-词库模型
文字模型化最常用方法,可以看成是独热编码的一种扩展,它为每个单词设值一个特征值。依据是用类似单词的文章意思也差不多。可以通过有限的编码信息实现有效的文档分类和检索。
CountVectorizer 类会将文档全部转换成小写,然后将文档词块化(tokenize).文档词块化是把句子分割成词块(token)或有意义的字母序列的过程。词块大多是单词,但是他们也可能是一些短语,如标点符号和词缀。
CountVectorizer类通过正则表达式用空格分割句子,然后抽取长度大于等于2的字母序列。
 from sklearn.feature_extraction.text import CountVectorizer
corpus = [
   'UNC played Duke in basketball',
  'Duke lost the basketball game',
  'I ate a sandwich'
 ]
 vectorizer = CountVectorizer()
 print (vectorizer.fit_transform(corpus).todense())
print (vectorizer.vocabulary_)


[[0 1 1 0 1 0 1 0 0 1]
 [0 1 1 1 0 1 0 0 1 0]
 [1 0 0 0 0 0 0 1 0 0]]
{'unc': 9, 'played': 6, 'duke': 2, 'in': 4, 'basketball': 1, 'lost': 5, 'the': 8, 'game': 3, 'ate': 0, 'sandwich': 7}
对比文档的特征向量
对比文档的特征向量,会发现前两个文档相比第三个文档更相似。如果用欧氏距离(Euclidean distance)计算它们的特征向量会比其与第三个文档距离更接近。
两向量的欧氏距离就是两个向量欧氏范数(Euclidean norm)或L2范数差的绝对值:d=||x0-x1|| 向量的欧氏范数是其元素平方和的平方根: scikit-learn里面的euclidean_distances函数可以计算若干向量的距离,表示两个语义最相似的文档其向量在空间中也是最接近的。
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.metrics.pairwise import euclidean_distances
vectorizer = CountVectorizer()
corpus = [
     'UNC played Duke in basketball',
    'Duke lost the basketball game',
     'I ate a sandwich'
 ]
counts = vectorizer.fit_transform(corpus).todense()
for x,y in [[0,1],[0,2],[1,2]]:
    dist = euclidean_distances(counts[x],counts[y])
    print('文档{}与文档{}的距离{}'.format(x,y,dist))


文档0与文档1的距离[[2.44948974]]
文档0与文档2的距离[[2.64575131]]
文档1与文档2的距离[[2.64575131]]
图片特征的提取
数字图像通常是一张光栅图或像素图,将颜色映射到网格坐标里。 一张图片可以看成是一个每个元素都是颜色值的矩阵。 表示图像基本特征就是将矩阵每行连起来变成一个行向量。 光学文字识别(Optical character recognition,OCR)是机器学习的经典问题。
scikit-learn的digits数字集包括至少1700种0-9的手写数字图像。 每个图像都有8x8像像素构成。每个像素的值是0-16,白色是0,黑色是16。
# 通过像素提取特征值
from sklearn import datasets
import matplotlib.pyplot as plt
digits = datasets.load_digits()
print('Digit:',digits.target[0])
print (digits.images[0])
plt.figure()
plt.axis('off')
plt.imshow(digits.images[0], cmap=plt.cm.gray_r, interpolation='nearest')
plt.show()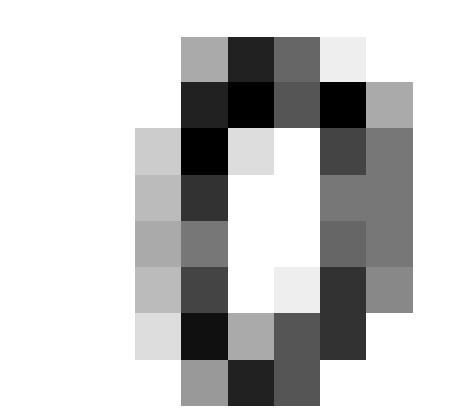
在这里插入图片描述感谢平台分享-http://bjbsair.com/2020-04-10...
分类变量特征提取
分类数据的独热编码方法,分类变量特征提取(One-of-K or One-Hot Encoding): 通过二进制数来表示每个解释变量的特征
from sklearn.feature_extraction import DictVectorizer
onhot_encoder = DictVectorizer()
instances=[{'city':'New York'},{'city':'San Francisco'},{'city':'Chapel Hill'}]
print (onhot_encoder.fit_transform(instances).toarray())


[[0. 1. 0.]
 [0. 0. 1.]
 [1. 0. 0.]]
文字特征提取-词库模型
文字模型化最常用方法,可以看成是独热编码的一种扩展,它为每个单词设值一个特征值。依据是用类似单词的文章意思也差不多。可以通过有限的编码信息实现有效的文档分类和检索。
CountVectorizer 类会将文档全部转换成小写,然后将文档词块化(tokenize).文档词块化是把句子分割成词块(token)或有意义的字母序列的过程。词块大多是单词,但是他们也可能是一些短语,如标点符号和词缀。
CountVectorizer类通过正则表达式用空格分割句子,然后抽取长度大于等于2的字母序列。
 from sklearn.feature_extraction.text import CountVectorizer
corpus = [
   'UNC played Duke in basketball',
  'Duke lost the basketball game',
  'I ate a sandwich'
 ]
 vectorizer = CountVectorizer()
 print (vectorizer.fit_transform(corpus).todense())
print (vectorizer.vocabulary_)


[[0 1 1 0 1 0 1 0 0 1]
 [0 1 1 1 0 1 0 0 1 0]
 [1 0 0 0 0 0 0 1 0 0]]
{'unc': 9, 'played': 6, 'duke': 2, 'in': 4, 'basketball': 1, 'lost': 5, 'the': 8, 'game': 3, 'ate': 0, 'sandwich': 7}
对比文档的特征向量
对比文档的特征向量,会发现前两个文档相比第三个文档更相似。如果用欧氏距离(Euclidean distance)计算它们的特征向量会比其与第三个文档距离更接近。
两向量的欧氏距离就是两个向量欧氏范数(Euclidean norm)或L2范数差的绝对值:d=||x0-x1|| 向量的欧氏范数是其元素平方和的平方根: scikit-learn里面的euclidean_distances函数可以计算若干向量的距离,表示两个语义最相似的文档其向量在空间中也是最接近的。
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.metrics.pairwise import euclidean_distances
vectorizer = CountVectorizer()
corpus = [
     'UNC played Duke in basketball',
    'Duke lost the basketball game',
     'I ate a sandwich'
 ]
counts = vectorizer.fit_transform(corpus).todense()
for x,y in [[0,1],[0,2],[1,2]]:
    dist = euclidean_distances(counts[x],counts[y])
    print('文档{}与文档{}的距离{}'.format(x,y,dist))


文档0与文档1的距离[[2.44948974]]
文档0与文档2的距离[[2.64575131]]
文档1与文档2的距离[[2.64575131]]
图片特征的提取
数字图像通常是一张光栅图或像素图,将颜色映射到网格坐标里。 一张图片可以看成是一个每个元素都是颜色值的矩阵。 表示图像基本特征就是将矩阵每行连起来变成一个行向量。 光学文字识别(Optical character recognition,OCR)是机器学习的经典问题。
scikit-learn的digits数字集包括至少1700种0-9的手写数字图像。 每个图像都有8x8像像素构成。每个像素的值是0-16,白色是0,黑色是16。
# 通过像素提取特征值
from sklearn import datasets
import matplotlib.pyplot as plt
digits = datasets.load_digits()
print('Digit:',digits.target[0])
print (digits.images[0])
plt.figure()
plt.axis('off')
plt.imshow(digits.images[0], cmap=plt.cm.gray_r, interpolation='nearest')
plt.show()
在这里插入图片描述感谢平台分享-http://bjbsair.com/2020-04-10...
分类变量特征提取
分类数据的独热编码方法,分类变量特征提取(One-of-K or One-Hot Encoding): 通过二进制数来表示每个解释变量的特征
from sklearn.feature_extraction import DictVectorizer
onhot_encoder = DictVectorizer()
instances=[{'city':'New York'},{'city':'San Francisco'},{'city':'Chapel Hill'}]
print (onhot_encoder.fit_transform(instances).toarray())


[[0. 1. 0.]
 [0. 0. 1.]
 [1. 0. 0.]]
文字特征提取-词库模型
文字模型化最常用方法,可以看成是独热编码的一种扩展,它为每个单词设值一个特征值。依据是用类似单词的文章意思也差不多。可以通过有限的编码信息实现有效的文档分类和检索。
CountVectorizer 类会将文档全部转换成小写,然后将文档词块化(tokenize).文档词块化是把句子分割成词块(token)或有意义的字母序列的过程。词块大多是单词,但是他们也可能是一些短语,如标点符号和词缀。
CountVectorizer类通过正则表达式用空格分割句子,然后抽取长度大于等于2的字母序列。
 from sklearn.feature_extraction.text import CountVectorizer
corpus = [
   'UNC played Duke in basketball',
  'Duke lost the basketball game',
  'I ate a sandwich'
 ]
 vectorizer = CountVectorizer()
 print (vectorizer.fit_transform(corpus).todense())
print (vectorizer.vocabulary_)


[[0 1 1 0 1 0 1 0 0 1]
 [0 1 1 1 0 1 0 0 1 0]
 [1 0 0 0 0 0 0 1 0 0]]
{'unc': 9, 'played': 6, 'duke': 2, 'in': 4, 'basketball': 1, 'lost': 5, 'the': 8, 'game': 3, 'ate': 0, 'sandwich': 7}
对比文档的特征向量
对比文档的特征向量,会发现前两个文档相比第三个文档更相似。如果用欧氏距离(Euclidean distance)计算它们的特征向量会比其与第三个文档距离更接近。
两向量的欧氏距离就是两个向量欧氏范数(Euclidean norm)或L2范数差的绝对值:d=||x0-x1|| 向量的欧氏范数是其元素平方和的平方根: scikit-learn里面的euclidean_distances函数可以计算若干向量的距离,表示两个语义最相似的文档其向量在空间中也是最接近的。
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.metrics.pairwise import euclidean_distances
vectorizer = CountVectorizer()
corpus = [
     'UNC played Duke in basketball',
    'Duke lost the basketball game',
     'I ate a sandwich'
 ]
counts = vectorizer.fit_transform(corpus).todense()
for x,y in [[0,1],[0,2],[1,2]]:
    dist = euclidean_distances(counts[x],counts[y])
    print('文档{}与文档{}的距离{}'.format(x,y,dist))


文档0与文档1的距离[[2.44948974]]
文档0与文档2的距离[[2.64575131]]
文档1与文档2的距离[[2.64575131]]
图片特征的提取
数字图像通常是一张光栅图或像素图,将颜色映射到网格坐标里。 一张图片可以看成是一个每个元素都是颜色值的矩阵。 表示图像基本特征就是将矩阵每行连起来变成一个行向量。 光学文字识别(Optical character recognition,OCR)是机器学习的经典问题。
scikit-learn的digits数字集包括至少1700种0-9的手写数字图像。 每个图像都有8x8像像素构成。每个像素的值是0-16,白色是0,黑色是16。
# 通过像素提取特征值
from sklearn import datasets
import matplotlib.pyplot as plt
digits = datasets.load_digits()
print('Digit:',digits.target[0])
print (digits.images[0])
plt.figure()
plt.axis('off')
plt.imshow(digits.images[0], cmap=plt.cm.gray_r, interpolation='nearest')
plt.show()
在这里插入图片描述感谢平台分享-http://bjbsair.com/2020-04-10...
分类变量特征提取
分类数据的独热编码方法,分类变量特征提取(One-of-K or One-Hot Encoding): 通过二进制数来表示每个解释变量的特征
from sklearn.feature_extraction import DictVectorizer
onhot_encoder = DictVectorizer()
instances=[{'city':'New York'},{'city':'San Francisco'},{'city':'Chapel Hill'}]
print (onhot_encoder.fit_transform(instances).toarray())


[[0. 1. 0.]
 [0. 0. 1.]
 [1. 0. 0.]]
文字特征提取-词库模型
文字模型化最常用方法,可以看成是独热编码的一种扩展,它为每个单词设值一个特征值。依据是用类似单词的文章意思也差不多。可以通过有限的编码信息实现有效的文档分类和检索。
CountVectorizer 类会将文档全部转换成小写,然后将文档词块化(tokenize).文档词块化是把句子分割成词块(token)或有意义的字母序列的过程。词块大多是单词,但是他们也可能是一些短语,如标点符号和词缀。
CountVectorizer类通过正则表达式用空格分割句子,然后抽取长度大于等于2的字母序列。
 from sklearn.feature_extraction.text import CountVectorizer
corpus = [
   'UNC played Duke in basketball',
  'Duke lost the basketball game',
  'I ate a sandwich'
 ]
 vectorizer = CountVectorizer()
 print (vectorizer.fit_transform(corpus).todense())
print (vectorizer.vocabulary_)


[[0 1 1 0 1 0 1 0 0 1]
 [0 1 1 1 0 1 0 0 1 0]
 [1 0 0 0 0 0 0 1 0 0]]
{'unc': 9, 'played': 6, 'duke': 2, 'in': 4, 'basketball': 1, 'lost': 5, 'the': 8, 'game': 3, 'ate': 0, 'sandwich': 7}
对比文档的特征向量
对比文档的特征向量,会发现前两个文档相比第三个文档更相似。如果用欧氏距离(Euclidean distance)计算它们的特征向量会比其与第三个文档距离更接近。
两向量的欧氏距离就是两个向量欧氏范数(Euclidean norm)或L2范数差的绝对值:d=||x0-x1|| 向量的欧氏范数是其元素平方和的平方根: scikit-learn里面的euclidean_distances函数可以计算若干向量的距离,表示两个语义最相似的文档其向量在空间中也是最接近的。
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.metrics.pairwise import euclidean_distances
vectorizer = CountVectorizer()
corpus = [
     'UNC played Duke in basketball',
    'Duke lost the basketball game',
     'I ate a sandwich'
 ]
counts = vectorizer.fit_transform(corpus).todense()
for x,y in [[0,1],[0,2],[1,2]]:
    dist = euclidean_distances(counts[x],counts[y])
    print('文档{}与文档{}的距离{}'.format(x,y,dist))


文档0与文档1的距离[[2.44948974]]
文档0与文档2的距离[[2.64575131]]
文档1与文档2的距离[[2.64575131]]
图片特征的提取
数字图像通常是一张光栅图或像素图,将颜色映射到网格坐标里。 一张图片可以看成是一个每个元素都是颜色值的矩阵。 表示图像基本特征就是将矩阵每行连起来变成一个行向量。 光学文字识别(Optical character recognition,OCR)是机器学习的经典问题。
scikit-learn的digits数字集包括至少1700种0-9的手写数字图像。 每个图像都有8x8像像素构成。每个像素的值是0-16,白色是0,黑色是16。
# 通过像素提取特征值
from sklearn import datasets
import matplotlib.pyplot as plt
digits = datasets.load_digits()
print('Digit:',digits.target[0])
print (digits.images[0])
plt.figure()
plt.axis('off')
plt.imshow(digits.images[0], cmap=plt.cm.gray_r, interpolation='nearest')
plt.show()
在这里插入图片描述感谢平台分享-http://bjbsair.com/2020-04-10...
分类变量特征提取
分类数据的独热编码方法,分类变量特征提取(One-of-K or One-Hot Encoding): 通过二进制数来表示每个解释变量的特征
from sklearn.feature_extraction import DictVectorizer
onhot_encoder = DictVectorizer()
instances=[{'city':'New York'},{'city':'San Francisco'},{'city':'Chapel Hill'}]
print (onhot_encoder.fit_transform(instances).toarray())


[[0. 1. 0.]
 [0. 0. 1.]
 [1. 0. 0.]]
文字特征提取-词库模型
文字模型化最常用方法,可以看成是独热编码的一种扩展,它为每个单词设值一个特征值。依据是用类似单词的文章意思也差不多。可以通过有限的编码信息实现有效的文档分类和检索。
CountVectorizer 类会将文档全部转换成小写,然后将文档词块化(tokenize).文档词块化是把句子分割成词块(token)或有意义的字母序列的过程。词块大多是单词,但是他们也可能是一些短语,如标点符号和词缀。
CountVectorizer类通过正则表达式用空格分割句子,然后抽取长度大于等于2的字母序列。
 from sklearn.feature_extraction.text import CountVectorizer
corpus = [
   'UNC played Duke in basketball',
  'Duke lost the basketball game',
  'I ate a sandwich'
 ]
 vectorizer = CountVectorizer()
 print (vectorizer.fit_transform(corpus).todense())
print (vectorizer.vocabulary_)


[[0 1 1 0 1 0 1 0 0 1]
 [0 1 1 1 0 1 0 0 1 0]
 [1 0 0 0 0 0 0 1 0 0]]
{'unc': 9, 'played': 6, 'duke': 2, 'in': 4, 'basketball': 1, 'lost': 5, 'the': 8, 'game': 3, 'ate': 0, 'sandwich': 7}
对比文档的特征向量
对比文档的特征向量,会发现前两个文档相比第三个文档更相似。如果用欧氏距离(Euclidean distance)计算它们的特征向量会比其与第三个文档距离更接近。
两向量的欧氏距离就是两个向量欧氏范数(Euclidean norm)或L2范数差的绝对值:d=||x0-x1|| 向量的欧氏范数是其元素平方和的平方根: scikit-learn里面的euclidean_distances函数可以计算若干向量的距离,表示两个语义最相似的文档其向量在空间中也是最接近的。
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.metrics.pairwise import euclidean_distances
vectorizer = CountVectorizer()
corpus = [
     'UNC played Duke in basketball',
    'Duke lost the basketball game',
     'I ate a sandwich'
 ]
counts = vectorizer.fit_transform(corpus).todense()
for x,y in [[0,1],[0,2],[1,2]]:
    dist = euclidean_distances(counts[x],counts[y])
    print('文档{}与文档{}的距离{}'.format(x,y,dist))


文档0与文档1的距离[[2.44948974]]
文档0与文档2的距离[[2.64575131]]
文档1与文档2的距离[[2.64575131]]
图片特征的提取
数字图像通常是一张光栅图或像素图,将颜色映射到网格坐标里。 一张图片可以看成是一个每个元素都是颜色值的矩阵。 表示图像基本特征就是将矩阵每行连起来变成一个行向量。 光学文字识别(Optical character recognition,OCR)是机器学习的经典问题。
scikit-learn的digits数字集包括至少1700种0-9的手写数字图像。 每个图像都有8x8像像素构成。每个像素的值是0-16,白色是0,黑色是16。
# 通过像素提取特征值
from sklearn import datasets
import matplotlib.pyplot as plt
digits = datasets.load_digits()
print('Digit:',digits.target[0])
print (digits.images[0])
plt.figure()
plt.axis('off')
plt.imshow(digits.images[0], cmap=plt.cm.gray_r, interpolation='nearest')
plt.show()
在这里插入图片描述感谢平台分享-http://bjbsair.com/2020-04-10...
分类变量特征提取
分类数据的独热编码方法,分类变量特征提取(One-of-K or One-Hot Encoding): 通过二进制数来表示每个解释变量的特征
from sklearn.feature_extraction import DictVectorizer
onhot_encoder = DictVectorizer()
instances=[{'city':'New York'},{'city':'San Francisco'},{'city':'Chapel Hill'}]
print (onhot_encoder.fit_transform(instances).toarray())


[[0. 1. 0.]
 [0. 0. 1.]
 [1. 0. 0.]]
文字特征提取-词库模型
文字模型化最常用方法,可以看成是独热编码的一种扩展,它为每个单词设值一个特征值。依据是用类似单词的文章意思也差不多。可以通过有限的编码信息实现有效的文档分类和检索。
CountVectorizer 类会将文档全部转换成小写,然后将文档词块化(tokenize).文档词块化是把句子分割成词块(token)或有意义的字母序列的过程。词块大多是单词,但是他们也可能是一些短语,如标点符号和词缀。
CountVectorizer类通过正则表达式用空格分割句子,然后抽取长度大于等于2的字母序列。
 from sklearn.feature_extraction.text import CountVectorizer
corpus = [
   'UNC played Duke in basketball',
  'Duke lost the basketball game',
  'I ate a sandwich'
 ]
 vectorizer = CountVectorizer()
 print (vectorizer.fit_transform(corpus).todense())
print (vectorizer.vocabulary_)


[[0 1 1 0 1 0 1 0 0 1]
 [0 1 1 1 0 1 0 0 1 0]
 [1 0 0 0 0 0 0 1 0 0]]
{'unc': 9, 'played': 6, 'duke': 2, 'in': 4, 'basketball': 1, 'lost': 5, 'the': 8, 'game': 3, 'ate': 0, 'sandwich': 7}
对比文档的特征向量
对比文档的特征向量,会发现前两个文档相比第三个文档更相似。如果用欧氏距离(Euclidean distance)计算它们的特征向量会比其与第三个文档距离更接近。
两向量的欧氏距离就是两个向量欧氏范数(Euclidean norm)或L2范数差的绝对值:d=||x0-x1|| 向量的欧氏范数是其元素平方和的平方根: scikit-learn里面的euclidean_distances函数可以计算若干向量的距离,表示两个语义最相似的文档其向量在空间中也是最接近的。
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.metrics.pairwise import euclidean_distances
vectorizer = CountVectorizer()
corpus = [
     'UNC played Duke in basketball',
    'Duke lost the basketball game',
     'I ate a sandwich'
 ]
counts = vectorizer.fit_transform(corpus).todense()
for x,y in [[0,1],[0,2],[1,2]]:
    dist = euclidean_distances(counts[x],counts[y])
    print('文档{}与文档{}的距离{}'.format(x,y,dist))


文档0与文档1的距离[[2.44948974]]
文档0与文档2的距离[[2.64575131]]
文档1与文档2的距离[[2.64575131]]
图片特征的提取
数字图像通常是一张光栅图或像素图,将颜色映射到网格坐标里。 一张图片可以看成是一个每个元素都是颜色值的矩阵。 表示图像基本特征就是将矩阵每行连起来变成一个行向量。 光学文字识别(Optical character recognition,OCR)是机器学习的经典问题。
scikit-learn的digits数字集包括至少1700种0-9的手写数字图像。 每个图像都有8x8像像素构成。每个像素的值是0-16,白色是0,黑色是16。
# 通过像素提取特征值
from sklearn import datasets
import matplotlib.pyplot as plt
digits = datasets.load_digits()
print('Digit:',digits.target[0])
print (digits.images[0])
plt.figure()
plt.axis('off')
plt.imshow(digits.images[0], cmap=plt.cm.gray_r, interpolation='nearest')
plt.show()
在这里插入图片描述感谢平台分享-http://bjbsair.com/2020-04-10...
分类变量特征提取
分类数据的独热编码方法,分类变量特征提取(One-of-K or One-Hot Encoding): 通过二进制数来表示每个解释变量的特征
from sklearn.feature_extraction import DictVectorizer
onhot_encoder = DictVectorizer()
instances=[{'city':'New York'},{'city':'San Francisco'},{'city':'Chapel Hill'}]
print (onhot_encoder.fit_transform(instances).toarray())


[[0. 1. 0.]
 [0. 0. 1.]
 [1. 0. 0.]]
文字特征提取-词库模型
文字模型化最常用方法,可以看成是独热编码的一种扩展,它为每个单词设值一个特征值。依据是用类似单词的文章意思也差不多。可以通过有限的编码信息实现有效的文档分类和检索。
CountVectorizer 类会将文档全部转换成小写,然后将文档词块化(tokenize).文档词块化是把句子分割成词块(token)或有意义的字母序列的过程。词块大多是单词,但是他们也可能是一些短语,如标点符号和词缀。
CountVectorizer类通过正则表达式用空格分割句子,然后抽取长度大于等于2的字母序列。
 from sklearn.feature_extraction.text import CountVectorizer
corpus = [
   'UNC played Duke in basketball',
  'Duke lost the basketball game',
  'I ate a sandwich'
 ]
 vectorizer = CountVectorizer()
 print (vectorizer.fit_transform(corpus).todense())
print (vectorizer.vocabulary_)


[[0 1 1 0 1 0 1 0 0 1]
 [0 1 1 1 0 1 0 0 1 0]
 [1 0 0 0 0 0 0 1 0 0]]
{'unc': 9, 'played': 6, 'duke': 2, 'in': 4, 'basketball': 1, 'lost': 5, 'the': 8, 'game': 3, 'ate': 0, 'sandwich': 7}
对比文档的特征向量
对比文档的特征向量,会发现前两个文档相比第三个文档更相似。如果用欧氏距离(Euclidean distance)计算它们的特征向量会比其与第三个文档距离更接近。
两向量的欧氏距离就是两个向量欧氏范数(Euclidean norm)或L2范数差的绝对值:d=||x0-x1|| 向量的欧氏范数是其元素平方和的平方根: scikit-learn里面的euclidean_distances函数可以计算若干向量的距离,表示两个语义最相似的文档其向量在空间中也是最接近的。
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.metrics.pairwise import euclidean_distances
vectorizer = CountVectorizer()
corpus = [
     'UNC played Duke in basketball',
    'Duke lost the basketball game',
     'I ate a sandwich'
 ]
counts = vectorizer.fit_transform(corpus).todense()
for x,y in [[0,1],[0,2],[1,2]]:
    dist = euclidean_distances(counts[x],counts[y])
    print('文档{}与文档{}的距离{}'.format(x,y,dist))


文档0与文档1的距离[[2.44948974]]
文档0与文档2的距离[[2.64575131]]
文档1与文档2的距离[[2.64575131]]
图片特征的提取
数字图像通常是一张光栅图或像素图,将颜色映射到网格坐标里。 一张图片可以看成是一个每个元素都是颜色值的矩阵。 表示图像基本特征就是将矩阵每行连起来变成一个行向量。 光学文字识别(Optical character recognition,OCR)是机器学习的经典问题。
scikit-learn的digits数字集包括至少1700种0-9的手写数字图像。 每个图像都有8x8像像素构成。每个像素的值是0-16,白色是0,黑色是16。
# 通过像素提取特征值
from sklearn import datasets
import matplotlib.pyplot as plt
digits = datasets.load_digits()
print('Digit:',digits.target[0])
print (digits.images[0])
plt.figure()
plt.axis('off')
plt.imshow(digits.images[0], cmap=plt.cm.gray_r, interpolation='nearest')
plt.show()
在这里插入图片描述感谢平台分享-http://bjbsair.com/2020-04-10...
分类变量特征提取
分类数据的独热编码方法,分类变量特征提取(One-of-K or One-Hot Encoding): 通过二进制数来表示每个解释变量的特征
from sklearn.feature_extraction import DictVectorizer
onhot_encoder = DictVectorizer()
instances=[{'city':'New York'},{'city':'San Francisco'},{'city':'Chapel Hill'}]
print (onhot_encoder.fit_transform(instances).toarray())


[[0. 1. 0.]
 [0. 0. 1.]
 [1. 0. 0.]]
文字特征提取-词库模型
文字模型化最常用方法,可以看成是独热编码的一种扩展,它为每个单词设值一个特征值。依据是用类似单词的文章意思也差不多。可以通过有限的编码信息实现有效的文档分类和检索。
CountVectorizer 类会将文档全部转换成小写,然后将文档词块化(tokenize).文档词块化是把句子分割成词块(token)或有意义的字母序列的过程。词块大多是单词,但是他们也可能是一些短语,如标点符号和词缀。
CountVectorizer类通过正则表达式用空格分割句子,然后抽取长度大于等于2的字母序列。
 from sklearn.feature_extraction.text import CountVectorizer
corpus = [
   'UNC played Duke in basketball',
  'Duke lost the basketball game',
  'I ate a sandwich'
 ]
 vectorizer = CountVectorizer()
 print (vectorizer.fit_transform(corpus).todense())
print (vectorizer.vocabulary_)


[[0 1 1 0 1 0 1 0 0 1]
 [0 1 1 1 0 1 0 0 1 0]
 [1 0 0 0 0 0 0 1 0 0]]
{'unc': 9, 'played': 6, 'duke': 2, 'in': 4, 'basketball': 1, 'lost': 5, 'the': 8, 'game': 3, 'ate': 0, 'sandwich': 7}
对比文档的特征向量
对比文档的特征向量,会发现前两个文档相比第三个文档更相似。如果用欧氏距离(Euclidean distance)计算它们的特征向量会比其与第三个文档距离更接近。
两向量的欧氏距离就是两个向量欧氏范数(Euclidean norm)或L2范数差的绝对值:d=||x0-x1|| 向量的欧氏范数是其元素平方和的平方根: scikit-learn里面的euclidean_distances函数可以计算若干向量的距离,表示两个语义最相似的文档其向量在空间中也是最接近的。
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.metrics.pairwise import euclidean_distances
vectorizer = CountVectorizer()
corpus = [
     'UNC played Duke in basketball',
    'Duke lost the basketball game',
     'I ate a sandwich'
 ]
counts = vectorizer.fit_transform(corpus).todense()
for x,y in [[0,1],[0,2],[1,2]]:
    dist = euclidean_distances(counts[x],counts[y])
    print('文档{}与文档{}的距离{}'.format(x,y,dist))


文档0与文档1的距离[[2.44948974]]
文档0与文档2的距离[[2.64575131]]
文档1与文档2的距离[[2.64575131]]
图片特征的提取
数字图像通常是一张光栅图或像素图,将颜色映射到网格坐标里。 一张图片可以看成是一个每个元素都是颜色值的矩阵。 表示图像基本特征就是将矩阵每行连起来变成一个行向量。 光学文字识别(Optical character recognition,OCR)是机器学习的经典问题。
scikit-learn的digits数字集包括至少1700种0-9的手写数字图像。 每个图像都有8x8像像素构成。每个像素的值是0-16,白色是0,黑色是16。
# 通过像素提取特征值
from sklearn import datasets
import matplotlib.pyplot as plt
digits = datasets.load_digits()
print('Digit:',digits.target[0])
print (digits.images[0])
plt.figure()
plt.axis('off')
plt.imshow(digits.images[0], cmap=plt.cm.gray_r, interpolation='nearest')
plt.show()
在这里插入图片描述感谢平台分享-http://bjbsair.com/2020-04-10...
分类变量特征提取
分类数据的独热编码方法,分类变量特征提取(One-of-K or One-Hot Encoding): 通过二进制数来表示每个解释变量的特征
from sklearn.feature_extraction import DictVectorizer
onhot_encoder = DictVectorizer()
instances=[{'city':'New York'},{'city':'San Francisco'},{'city':'Chapel Hill'}]
print (onhot_encoder.fit_transform(instances).toarray())


[[0. 1. 0.]
 [0. 0. 1.]
 [1. 0. 0.]]
文字特征提取-词库模型
文字模型化最常用方法,可以看成是独热编码的一种扩展,它为每个单词设值一个特征值。依据是用类似单词的文章意思也差不多。可以通过有限的编码信息实现有效的文档分类和检索。
CountVectorizer 类会将文档全部转换成小写,然后将文档词块化(tokenize).文档词块化是把句子分割成词块(token)或有意义的字母序列的过程。词块大多是单词,但是他们也可能是一些短语,如标点符号和词缀。
CountVectorizer类通过正则表达式用空格分割句子,然后抽取长度大于等于2的字母序列。
 from sklearn.feature_extraction.text import CountVectorizer
corpus = [
   'UNC played Duke in basketball',
  'Duke lost the basketball game',
  'I ate a sandwich'
 ]
 vectorizer = CountVectorizer()
 print (vectorizer.fit_transform(corpus).todense())
print (vectorizer.vocabulary_)


[[0 1 1 0 1 0 1 0 0 1]
 [0 1 1 1 0 1 0 0 1 0]
 [1 0 0 0 0 0 0 1 0 0]]
{'unc': 9, 'played': 6, 'duke': 2, 'in': 4, 'basketball': 1, 'lost': 5, 'the': 8, 'game': 3, 'ate': 0, 'sandwich': 7}
对比文档的特征向量
对比文档的特征向量,会发现前两个文档相比第三个文档更相似。如果用欧氏距离(Euclidean distance)计算它们的特征向量会比其与第三个文档距离更接近。
两向量的欧氏距离就是两个向量欧氏范数(Euclidean norm)或L2范数差的绝对值:d=||x0-x1|| 向量的欧氏范数是其元素平方和的平方根: scikit-learn里面的euclidean_distances函数可以计算若干向量的距离,表示两个语义最相似的文档其向量在空间中也是最接近的。
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.metrics.pairwise import euclidean_distances
vectorizer = CountVectorizer()
corpus = [
     'UNC played Duke in basketball',
    'Duke lost the basketball game',
     'I ate a sandwich'
 ]
counts = vectorizer.fit_transform(corpus).todense()
for x,y in [[0,1],[0,2],[1,2]]:
    dist = euclidean_distances(counts[x],counts[y])
    print('文档{}与文档{}的距离{}'.format(x,y,dist))


文档0与文档1的距离[[2.44948974]]
文档0与文档2的距离[[2.64575131]]
文档1与文档2的距离[[2.64575131]]
图片特征的提取
数字图像通常是一张光栅图或像素图,将颜色映射到网格坐标里。 一张图片可以看成是一个每个元素都是颜色值的矩阵。 表示图像基本特征就是将矩阵每行连起来变成一个行向量。 光学文字识别(Optical character recognition,OCR)是机器学习的经典问题。
scikit-learn的digits数字集包括至少1700种0-9的手写数字图像。 每个图像都有8x8像像素构成。每个像素的值是0-16,白色是0,黑色是16。
# 通过像素提取特征值
from sklearn import datasets
import matplotlib.pyplot as plt
digits = datasets.load_digits()
print('Digit:',digits.target[0])
print (digits.images[0])
plt.figure()
plt.axis('off')
plt.imshow(digits.images[0], cmap=plt.cm.gray_r, interpolation='nearest')
plt.show()
在这里插入图片描述感谢平台分享-http://bjbsair.com/2020-04-10...
分类变量特征提取
分类数据的独热编码方法,分类变量特征提取(One-of-K or One-Hot Encoding): 通过二进制数来表示每个解释变量的特征
from sklearn.feature_extraction import DictVectorizer
onhot_encoder = DictVectorizer()
instances=[{'city':'New York'},{'city':'San Francisco'},{'city':'Chapel Hill'}]
print (onhot_encoder.fit_transform(instances).toarray())


[[0. 1. 0.]
 [0. 0. 1.]
 [1. 0. 0.]]
文字特征提取-词库模型
文字模型化最常用方法,可以看成是独热编码的一种扩展,它为每个单词设值一个特征值。依据是用类似单词的文章意思也差不多。可以通过有限的编码信息实现有效的文档分类和检索。
CountVectorizer 类会将文档全部转换成小写,然后将文档词块化(tokenize).文档词块化是把句子分割成词块(token)或有意义的字母序列的过程。词块大多是单词,但是他们也可能是一些短语,如标点符号和词缀。
CountVectorizer类通过正则表达式用空格分割句子,然后抽取长度大于等于2的字母序列。
 from sklearn.feature_extraction.text import CountVectorizer
corpus = [
   'UNC played Duke in basketball',
  'Duke lost the basketball game',
  'I ate a sandwich'
 ]
 vectorizer = CountVectorizer()
 print (vectorizer.fit_transform(corpus).todense())
print (vectorizer.vocabulary_)


[[0 1 1 0 1 0 1 0 0 1]
 [0 1 1 1 0 1 0 0 1 0]
 [1 0 0 0 0 0 0 1 0 0]]
{'unc': 9, 'played': 6, 'duke': 2, 'in': 4, 'basketball': 1, 'lost': 5, 'the': 8, 'game': 3, 'ate': 0, 'sandwich': 7}
对比文档的特征向量
对比文档的特征向量,会发现前两个文档相比第三个文档更相似。如果用欧氏距离(Euclidean distance)计算它们的特征向量会比其与第三个文档距离更接近。
两向量的欧氏距离就是两个向量欧氏范数(Euclidean norm)或L2范数差的绝对值:d=||x0-x1|| 向量的欧氏范数是其元素平方和的平方根: scikit-learn里面的euclidean_distances函数可以计算若干向量的距离,表示两个语义最相似的文档其向量在空间中也是最接近的。
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.metrics.pairwise import euclidean_distances
vectorizer = CountVectorizer()
corpus = [
     'UNC played Duke in basketball',
    'Duke lost the basketball game',
     'I ate a sandwich'
 ]
counts = vectorizer.fit_transform(corpus).todense()
for x,y in [[0,1],[0,2],[1,2]]:
    dist = euclidean_distances(counts[x],counts[y])
    print('文档{}与文档{}的距离{}'.format(x,y,dist))


文档0与文档1的距离[[2.44948974]]
文档0与文档2的距离[[2.64575131]]
文档1与文档2的距离[[2.64575131]]
图片特征的提取
数字图像通常是一张光栅图或像素图,将颜色映射到网格坐标里。 一张图片可以看成是一个每个元素都是颜色值的矩阵。 表示图像基本特征就是将矩阵每行连起来变成一个行向量。 光学文字识别(Optical character recognition,OCR)是机器学习的经典问题。
scikit-learn的digits数字集包括至少1700种0-9的手写数字图像。 每个图像都有8x8像像素构成。每个像素的值是0-16,白色是0,黑色是16。
# 通过像素提取特征值
from sklearn import datasets
import matplotlib.pyplot as plt
digits = datasets.load_digits()
print('Digit:',digits.target[0])
print (digits.images[0])
plt.figure()
plt.axis('off')
plt.imshow(digits.images[0], cmap=plt.cm.gray_r, interpolation='nearest')
plt.show()
在这里插入图片描述感谢平台分享-http://bjbsair.com/2020-04-10...
分类变量特征提取
分类数据的独热编码方法,分类变量特征提取(One-of-K or One-Hot Encoding): 通过二进制数来表示每个解释变量的特征
from sklearn.feature_extraction import DictVectorizer
onhot_encoder = DictVectorizer()
instances=[{'city':'New York'},{'city':'San Francisco'},{'city':'Chapel Hill'}]
print (onhot_encoder.fit_transform(instances).toarray())


[[0. 1. 0.]
 [0. 0. 1.]
 [1. 0. 0.]]
文字特征提取-词库模型
文字模型化最常用方法,可以看成是独热编码的一种扩展,它为每个单词设值一个特征值。依据是用类似单词的文章意思也差不多。可以通过有限的编码信息实现有效的文档分类和检索。
CountVectorizer 类会将文档全部转换成小写,然后将文档词块化(tokenize).文档词块化是把句子分割成词块(token)或有意义的字母序列的过程。词块大多是单词,但是他们也可能是一些短语,如标点符号和词缀。
CountVectorizer类通过正则表达式用空格分割句子,然后抽取长度大于等于2的字母序列。
 from sklearn.feature_extraction.text import CountVectorizer
corpus = [
   'UNC played Duke in basketball',
  'Duke lost the basketball game',
  'I ate a sandwich'
 ]
 vectorizer = CountVectorizer()
 print (vectorizer.fit_transform(corpus).todense())
print (vectorizer.vocabulary_)


[[0 1 1 0 1 0 1 0 0 1]
 [0 1 1 1 0 1 0 0 1 0]
 [1 0 0 0 0 0 0 1 0 0]]
{'unc': 9, 'played': 6, 'duke': 2, 'in': 4, 'basketball': 1, 'lost': 5, 'the': 8, 'game': 3, 'ate': 0, 'sandwich': 7}
对比文档的特征向量
对比文档的特征向量,会发现前两个文档相比第三个文档更相似。如果用欧氏距离(Euclidean distance)计算它们的特征向量会比其与第三个文档距离更接近。
两向量的欧氏距离就是两个向量欧氏范数(Euclidean norm)或L2范数差的绝对值:d=||x0-x1|| 向量的欧氏范数是其元素平方和的平方根: scikit-learn里面的euclidean_distances函数可以计算若干向量的距离,表示两个语义最相似的文档其向量在空间中也是最接近的。
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.metrics.pairwise import euclidean_distances
vectorizer = CountVectorizer()
corpus = [
     'UNC played Duke in basketball',
    'Duke lost the basketball game',
     'I ate a sandwich'
 ]
counts = vectorizer.fit_transform(corpus).todense()
for x,y in [[0,1],[0,2],[1,2]]:
    dist = euclidean_distances(counts[x],counts[y])
    print('文档{}与文档{}的距离{}'.format(x,y,dist))


文档0与文档1的距离[[2.44948974]]
文档0与文档2的距离[[2.64575131]]
文档1与文档2的距离[[2.64575131]]
图片特征的提取
数字图像通常是一张光栅图或像素图,将颜色映射到网格坐标里。 一张图片可以看成是一个每个元素都是颜色值的矩阵。 表示图像基本特征就是将矩阵每行连起来变成一个行向量。 光学文字识别(Optical character recognition,OCR)是机器学习的经典问题。
scikit-learn的digits数字集包括至少1700种0-9的手写数字图像。 每个图像都有8x8像像素构成。每个像素的值是0-16,白色是0,黑色是16。
# 通过像素提取特征值
from sklearn import datasets
import matplotlib.pyplot as plt
digits = datasets.load_digits()
print('Digit:',digits.target[0])
print (digits.images[0])
plt.figure()
plt.axis('off')
plt.imshow(digits.images[0], cmap=plt.cm.gray_r, interpolation='nearest')
plt.show()
在这里插入图片描述感谢平台分享-http://bjbsair.com/2020-04-10...
分类变量特征提取
分类数据的独热编码方法,分类变量特征提取(One-of-K or One-Hot Encoding): 通过二进制数来表示每个解释变量的特征
from sklearn.feature_extraction import DictVectorizer
onhot_encoder = DictVectorizer()
instances=[{'city':'New York'},{'city':'San Francisco'},{'city':'Chapel Hill'}]
print (onhot_encoder.fit_transform(instances).toarray())


[[0. 1. 0.]
 [0. 0. 1.]
 [1. 0. 0.]]
文字特征提取-词库模型
文字模型化最常用方法,可以看成是独热编码的一种扩展,它为每个单词设值一个特征值。依据是用类似单词的文章意思也差不多。可以通过有限的编码信息实现有效的文档分类和检索。
CountVectorizer 类会将文档全部转换成小写,然后将文档词块化(tokenize).文档词块化是把句子分割成词块(token)或有意义的字母序列的过程。词块大多是单词,但是他们也可能是一些短语,如标点符号和词缀。
CountVectorizer类通过正则表达式用空格分割句子,然后抽取长度大于等于2的字母序列。
 from sklearn.feature_extraction.text import CountVectorizer
corpus = [
   'UNC played Duke in basketball',
  'Duke lost the basketball game',
  'I ate a sandwich'
 ]
 vectorizer = CountVectorizer()
 print (vectorizer.fit_transform(corpus).todense())
print (vectorizer.vocabulary_)


[[0 1 1 0 1 0 1 0 0 1]
 [0 1 1 1 0 1 0 0 1 0]
 [1 0 0 0 0 0 0 1 0 0]]
{'unc': 9, 'played': 6, 'duke': 2, 'in': 4, 'basketball': 1, 'lost': 5, 'the': 8, 'game': 3, 'ate': 0, 'sandwich': 7}
对比文档的特征向量
对比文档的特征向量,会发现前两个文档相比第三个文档更相似。如果用欧氏距离(Euclidean distance)计算它们的特征向量会比其与第三个文档距离更接近。
两向量的欧氏距离就是两个向量欧氏范数(Euclidean norm)或L2范数差的绝对值:d=||x0-x1|| 向量的欧氏范数是其元素平方和的平方根: scikit-learn里面的euclidean_distances函数可以计算若干向量的距离,表示两个语义最相似的文档其向量在空间中也是最接近的。
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.metrics.pairwise import euclidean_distances
vectorizer = CountVectorizer()
corpus = [
     'UNC played Duke in basketball',
    'Duke lost the basketball game',
     'I ate a sandwich'
 ]
counts = vectorizer.fit_transform(corpus).todense()
for x,y in [[0,1],[0,2],[1,2]]:
    dist = euclidean_distances(counts[x],counts[y])
    print('文档{}与文档{}的距离{}'.format(x,y,dist))


文档0与文档1的距离[[2.44948974]]
文档0与文档2的距离[[2.64575131]]
文档1与文档2的距离[[2.64575131]]
图片特征的提取
数字图像通常是一张光栅图或像素图,将颜色映射到网格坐标里。 一张图片可以看成是一个每个元素都是颜色值的矩阵。 表示图像基本特征就是将矩阵每行连起来变成一个行向量。 光学文字识别(Optical character recognition,OCR)是机器学习的经典问题。
scikit-learn的digits数字集包括至少1700种0-9的手写数字图像。 每个图像都有8x8像像素构成。每个像素的值是0-16,白色是0,黑色是16。
# 通过像素提取特征值
from sklearn import datasets
import matplotlib.pyplot as plt
digits = datasets.load_digits()
print('Digit:',digits.target[0])
print (digits.images[0])
plt.figure()
plt.axis('off')
plt.imshow(digits.images[0], cmap=plt.cm.gray_r, interpolation='nearest')
plt.show()
在这里插入图片描述感谢平台分享-http://bjbsair.com/2020-04-10...
分类变量特征提取
分类数据的独热编码方法,分类变量特征提取(One-of-K or One-Hot Encoding): 通过二进制数来表示每个解释变量的特征
from sklearn.feature_extraction import DictVectorizer
onhot_encoder = DictVectorizer()
instances=[{'city':'New York'},{'city':'San Francisco'},{'city':'Chapel Hill'}]
print (onhot_encoder.fit_transform(instances).toarray())


[[0. 1. 0.]
 [0. 0. 1.]
 [1. 0. 0.]]
文字特征提取-词库模型
文字模型化最常用方法,可以看成是独热编码的一种扩展,它为每个单词设值一个特征值。依据是用类似单词的文章意思也差不多。可以通过有限的编码信息实现有效的文档分类和检索。
CountVectorizer 类会将文档全部转换成小写,然后将文档词块化(tokenize).文档词块化是把句子分割成词块(token)或有意义的字母序列的过程。词块大多是单词,但是他们也可能是一些短语,如标点符号和词缀。
CountVectorizer类通过正则表达式用空格分割句子,然后抽取长度大于等于2的字母序列。
 from sklearn.feature_extraction.text import CountVectorizer
corpus = [
   'UNC played Duke in basketball',
  'Duke lost the basketball game',
  'I ate a sandwich'
 ]
 vectorizer = CountVectorizer()
 print (vectorizer.fit_transform(corpus).todense())
print (vectorizer.vocabulary_)


[[0 1 1 0 1 0 1 0 0 1]
 [0 1 1 1 0 1 0 0 1 0]
 [1 0 0 0 0 0 0 1 0 0]]
{'unc': 9, 'played': 6, 'duke': 2, 'in': 4, 'basketball': 1, 'lost': 5, 'the': 8, 'game': 3, 'ate': 0, 'sandwich': 7}
对比文档的特征向量
对比文档的特征向量,会发现前两个文档相比第三个文档更相似。如果用欧氏距离(Euclidean distance)计算它们的特征向量会比其与第三个文档距离更接近。
两向量的欧氏距离就是两个向量欧氏范数(Euclidean norm)或L2范数差的绝对值:d=||x0-x1|| 向量的欧氏范数是其元素平方和的平方根: scikit-learn里面的euclidean_distances函数可以计算若干向量的距离,表示两个语义最相似的文档其向量在空间中也是最接近的。
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.metrics.pairwise import euclidean_distances
vectorizer = CountVectorizer()
corpus = [
     'UNC played Duke in basketball',
    'Duke lost the basketball game',
     'I ate a sandwich'
 ]
counts = vectorizer.fit_transform(corpus).todense()
for x,y in [[0,1],[0,2],[1,2]]:
    dist = euclidean_distances(counts[x],counts[y])
    print('文档{}与文档{}的距离{}'.format(x,y,dist))


文档0与文档1的距离[[2.44948974]]
文档0与文档2的距离[[2.64575131]]
文档1与文档2的距离[[2.64575131]]
图片特征的提取
数字图像通常是一张光栅图或像素图,将颜色映射到网格坐标里。 一张图片可以看成是一个每个元素都是颜色值的矩阵。 表示图像基本特征就是将矩阵每行连起来变成一个行向量。 光学文字识别(Optical character recognition,OCR)是机器学习的经典问题。
scikit-learn的digits数字集包括至少1700种0-9的手写数字图像。 每个图像都有8x8像像素构成。每个像素的值是0-16,白色是0,黑色是16。
# 通过像素提取特征值
from sklearn import datasets
import matplotlib.pyplot as plt
digits = datasets.load_digits()
print('Digit:',digits.target[0])
print (digits.images[0])
plt.figure()
plt.axis('off')
plt.imshow(digits.images[0], cmap=plt.cm.gray_r, interpolation='nearest')
plt.show()
在这里插入图片描述感谢平台分享-http://bjbsair.com/2020-04-10...
分类变量特征提取
分类数据的独热编码方法,分类变量特征提取(One-of-K or One-Hot Encoding): 通过二进制数来表示每个解释变量的特征
from sklearn.feature_extraction import DictVectorizer
onhot_encoder = DictVectorizer()
instances=[{'city':'New York'},{'city':'San Francisco'},{'city':'Chapel Hill'}]
print (onhot_encoder.fit_transform(instances).toarray())


[[0. 1. 0.]
 [0. 0. 1.]
 [1. 0. 0.]]
文字特征提取-词库模型
文字模型化最常用方法,可以看成是独热编码的一种扩展,它为每个单词设值一个特征值。依据是用类似单词的文章意思也差不多。可以通过有限的编码信息实现有效的文档分类和检索。
CountVectorizer 类会将文档全部转换成小写,然后将文档词块化(tokenize).文档词块化是把句子分割成词块(token)或有意义的字母序列的过程。词块大多是单词,但是他们也可能是一些短语,如标点符号和词缀。
CountVectorizer类通过正则表达式用空格分割句子,然后抽取长度大于等于2的字母序列。
 from sklearn.feature_extraction.text import CountVectorizer
corpus = [
   'UNC played Duke in basketball',
  'Duke lost the basketball game',
  'I ate a sandwich'
 ]
 vectorizer = CountVectorizer()
 print (vectorizer.fit_transform(corpus).todense())
print (vectorizer.vocabulary_)


[[0 1 1 0 1 0 1 0 0 1]
 [0 1 1 1 0 1 0 0 1 0]
 [1 0 0 0 0 0 0 1 0 0]]
{'unc': 9, 'played': 6, 'duke': 2, 'in': 4, 'basketball': 1, 'lost': 5, 'the': 8, 'game': 3, 'ate': 0, 'sandwich': 7}
对比文档的特征向量
对比文档的特征向量,会发现前两个文档相比第三个文档更相似。如果用欧氏距离(Euclidean distance)计算它们的特征向量会比其与第三个文档距离更接近。
两向量的欧氏距离就是两个向量欧氏范数(Euclidean norm)或L2范数差的绝对值:d=||x0-x1|| 向量的欧氏范数是其元素平方和的平方根: scikit-learn里面的euclidean_distances函数可以计算若干向量的距离,表示两个语义最相似的文档其向量在空间中也是最接近的。
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.metrics.pairwise import euclidean_distances
vectorizer = CountVectorizer()
corpus = [
     'UNC played Duke in basketball',
    'Duke lost the basketball game',
     'I ate a sandwich'
 ]
counts = vectorizer.fit_transform(corpus).todense()
for x,y in [[0,1],[0,2],[1,2]]:
    dist = euclidean_distances(counts[x],counts[y])
    print('文档{}与文档{}的距离{}'.format(x,y,dist))


文档0与文档1的距离[[2.44948974]]
文档0与文档2的距离[[2.64575131]]
文档1与文档2的距离[[2.64575131]]
图片特征的提取
数字图像通常是一张光栅图或像素图,将颜色映射到网格坐标里。 一张图片可以看成是一个每个元素都是颜色值的矩阵。 表示图像基本特征就是将矩阵每行连起来变成一个行向量。 光学文字识别(Optical character recognition,OCR)是机器学习的经典问题。
scikit-learn的digits数字集包括至少1700种0-9的手写数字图像。 每个图像都有8x8像像素构成。每个像素的值是0-16,白色是0,黑色是16。
# 通过像素提取特征值
from sklearn import datasets
import matplotlib.pyplot as plt
digits = datasets.load_digits()
print('Digit:',digits.target[0])
print (digits.images[0])
plt.figure()
plt.axis('off')
plt.imshow(digits.images[0], cmap=plt.cm.gray_r, interpolation='nearest')
plt.show()
在这里插入图片描述感谢平台分享-http://bjbsair.com/2020-04-10...
分类变量特征提取
分类数据的独热编码方法,分类变量特征提取(One-of-K or One-Hot Encoding): 通过二进制数来表示每个解释变量的特征
from sklearn.feature_extraction import DictVectorizer
onhot_encoder = DictVectorizer()
instances=[{'city':'New York'},{'city':'San Francisco'},{'city':'Chapel Hill'}]
print (onhot_encoder.fit_transform(instances).toarray())


[[0. 1. 0.]
 [0. 0. 1.]
 [1. 0. 0.]]
文字特征提取-词库模型
文字模型化最常用方法,可以看成是独热编码的一种扩展,它为每个单词设值一个特征值。依据是用类似单词的文章意思也差不多。可以通过有限的编码信息实现有效的文档分类和检索。
CountVectorizer 类会将文档全部转换成小写,然后将文档词块化(tokenize).文档词块化是把句子分割成词块(token)或有意义的字母序列的过程。词块大多是单词,但是他们也可能是一些短语,如标点符号和词缀。
CountVectorizer类通过正则表达式用空格分割句子,然后抽取长度大于等于2的字母序列。
 from sklearn.feature_extraction.text import CountVectorizer
corpus = [
   'UNC played Duke in basketball',
  'Duke lost the basketball game',
  'I ate a sandwich'
 ]
 vectorizer = CountVectorizer()
 print (vectorizer.fit_transform(corpus).todense())
print (vectorizer.vocabulary_)


[[0 1 1 0 1 0 1 0 0 1]
 [0 1 1 1 0 1 0 0 1 0]
 [1 0 0 0 0 0 0 1 0 0]]
{'unc': 9, 'played': 6, 'duke': 2, 'in': 4, 'basketball': 1, 'lost': 5, 'the': 8, 'game': 3, 'ate': 0, 'sandwich': 7}
对比文档的特征向量
对比文档的特征向量,会发现前两个文档相比第三个文档更相似。如果用欧氏距离(Euclidean distance)计算它们的特征向量会比其与第三个文档距离更接近。
两向量的欧氏距离就是两个向量欧氏范数(Euclidean norm)或L2范数差的绝对值:d=||x0-x1|| 向量的欧氏范数是其元素平方和的平方根: scikit-learn里面的euclidean_distances函数可以计算若干向量的距离,表示两个语义最相似的文档其向量在空间中也是最接近的。
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.metrics.pairwise import euclidean_distances
vectorizer = CountVectorizer()
corpus = [
     'UNC played Duke in basketball',
    'Duke lost the basketball game',
     'I ate a sandwich'
 ]
counts = vectorizer.fit_transform(corpus).todense()
for x,y in [[0,1],[0,2],[1,2]]:
    dist = euclidean_distances(counts[x],counts[y])
    print('文档{}与文档{}的距离{}'.format(x,y,dist))


文档0与文档1的距离[[2.44948974]]
文档0与文档2的距离[[2.64575131]]
文档1与文档2的距离[[2.64575131]]
图片特征的提取
数字图像通常是一张光栅图或像素图,将颜色映射到网格坐标里。 一张图片可以看成是一个每个元素都是颜色值的矩阵。 表示图像基本特征就是将矩阵每行连起来变成一个行向量。 光学文字识别(Optical character recognition,OCR)是机器学习的经典问题。
scikit-learn的digits数字集包括至少1700种0-9的手写数字图像。 每个图像都有8x8像像素构成。每个像素的值是0-16,白色是0,黑色是16。
# 通过像素提取特征值
from sklearn import datasets
import matplotlib.pyplot as plt
digits = datasets.load_digits()
print('Digit:',digits.target[0])
print (digits.images[0])
plt.figure()
plt.axis('off')
plt.imshow(digits.images[0], cmap=plt.cm.gray_r, interpolation='nearest')
plt.show()
在这里插入图片描述
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论