无监督学习之auto encoder(未完成)
文章目录
encoder&decoder
encoder其实就是把文本或者图片经过神经网络转换为向量.
decoder就是把向量转换为文本或图片等。
例如翻译系统,encoder可以理解为将源语言文本转换为语义(向量表示)然后decoder将语义转换为目标语言。
什么是auto encoder
auto encode其实就是 “我编码我自己”,然后还原出“我自己”
将输入的文本,图片进行编码,映射到低纬度的向量里,这里可以将向量理解为文本图片的各个抽象特征,然后根据这些抽象特征来还原自己。
什么是Variational Autoencoder(Vae)

相比于auto encoder. vae加了一些噪音e 并且乘以权重σ(学出来的)
为什么这样?

这个地方不是太懂。简单说一下。例如我们本来对输入的半个月亮进行编码,然后编码后的code落在了空间某处,然后对该code decode 解码出原有的图片。假如我们加了一些噪音,那么原来code附近的code 也会被还原成半个月亮。假如此时又有一个满月图片进行类似的操作,那么很有可能加入噪音后的code和之前半个月亮code重叠了,那么模型训练就会要求他即像半个月亮又像满月。就可以学习出介于两者之间的图片。
而且我认为这样做生成似乎更容易,更稳健了,因为对于decoder来说,code的要求没那么严格了。
问题1:假如模型学到把σ都设置为0 从而得到更好的学习结果,该怎么办?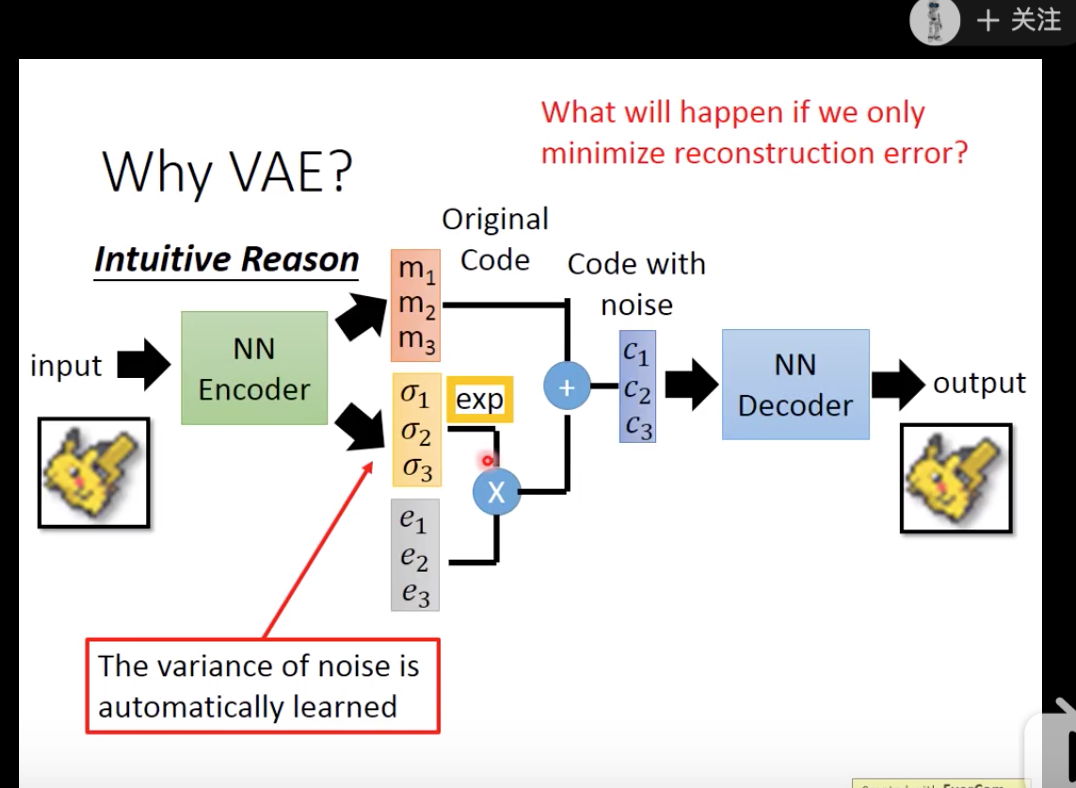
什么是高斯混合模型
要知道什么是高斯混合模型。首先要知道什么是高斯模型。
当样本数据 X 是一维数据(Univariate)时,高斯分布遵从下方概率密度函数(Probability Density Function):
,。
(公式来自知乎:https://zhuanlan.zhihu.com/p/...)
那么高斯混合模型就是把多个单高斯模型混合到一起。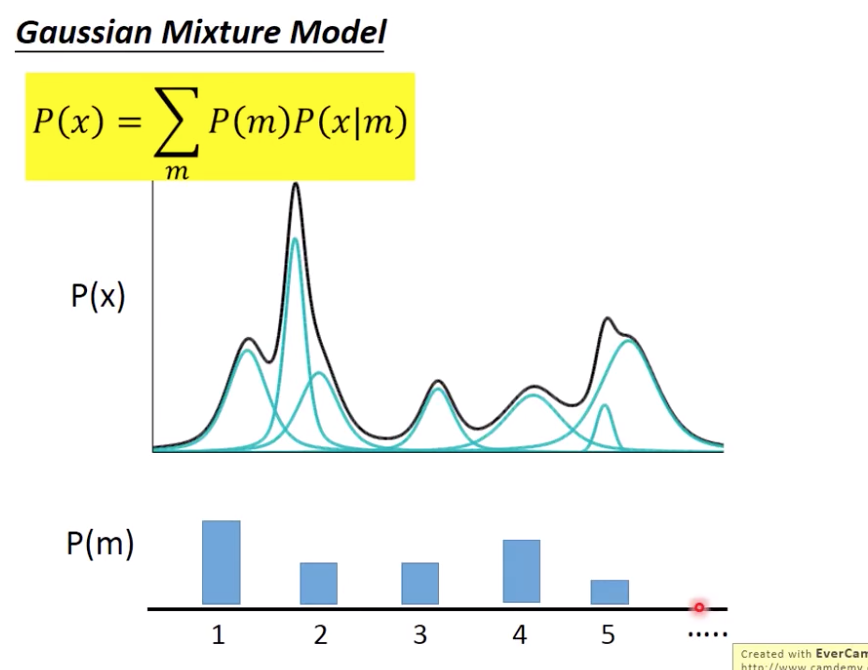
这种情况比较多见,比如数据中可能会有多种子类型数据,而每种数据都服从高斯分布。
概率计算如上图黄色部分。
ps:还没完成,以后在修改
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论