<六>rabbitmq高可用集群
文章目录
集群搭建
RabbitMQ的集群节点包括内存节点、磁盘节点。内存节点将所有的队列,交换器,绑定关系,用户,权限,和
vhost的元数据信息保存在内存中。磁盘节点将这些信息保存在磁盘中,但是内存节点的性能更高,为了保证集群
的高可用性,必须保证集群中有两个以上的磁盘节点,来保证当有一个磁盘节点崩溃了,集群还能对外提供访问服
务. 所以最合适的方案就是既有多内存节点,又有双磁盘节点。
rabbitmq 集群搭建
主备模式
实现RabbitMQ的高可用集群,一般在并发和数据量不高的情况下,这种模式非常的好且简单。主备模式也称
为Warren模式
主备模式:就是warren(兔子窝)模式,就是一个主/备方案(主节点如果挂了,从节点提供服务而已,和
activemq利用zookeeper做主/备一样)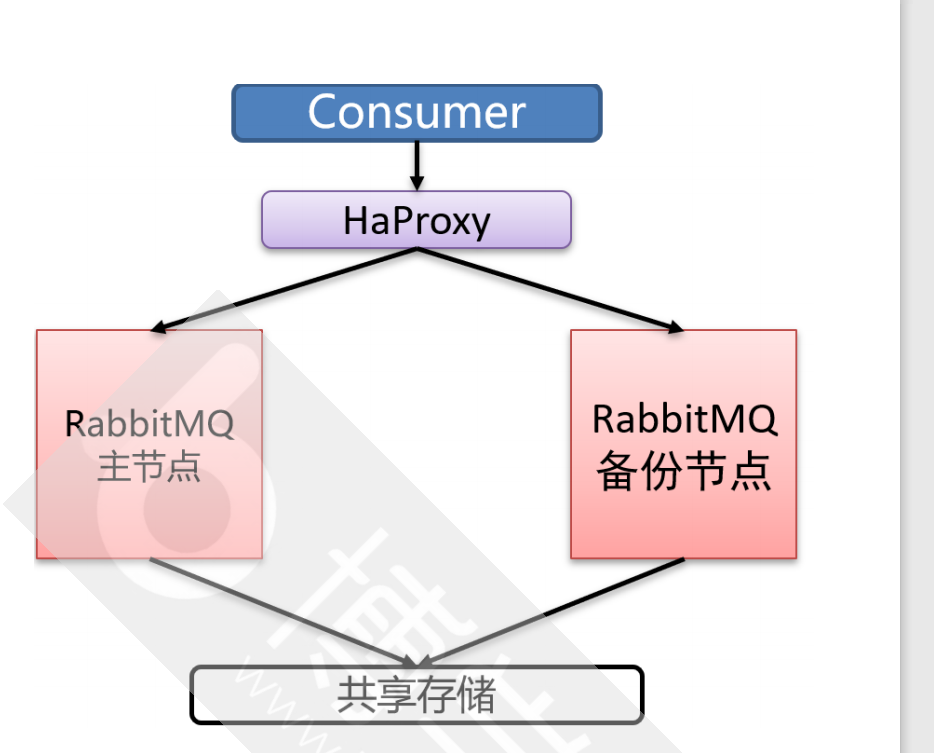
HAProxy是一个使用C语言编写的自由及开放源代码软件,其提供高可用性、负载均衡,以及基TCP和HTTP
的应用程序代理。
HAProxy特别适用于那些负载特大的web站点, 完全可以支持数以万计的并发连接.同时可以保护web服务器不
被暴露到网络上。
- 远程模式
远程模式:远距离通信和复制,所谓Shovel就是我们可以把消息进行不同数据中心的复制工作,我们可以跨
地域的让两个MQ集群互联。 分摊服务器压力,并且在使用了shovel插件后,模型变成了 近端同步确认 , 远端 异步确认 方式,大大提高了消息确认速度,并且还能保证可靠性。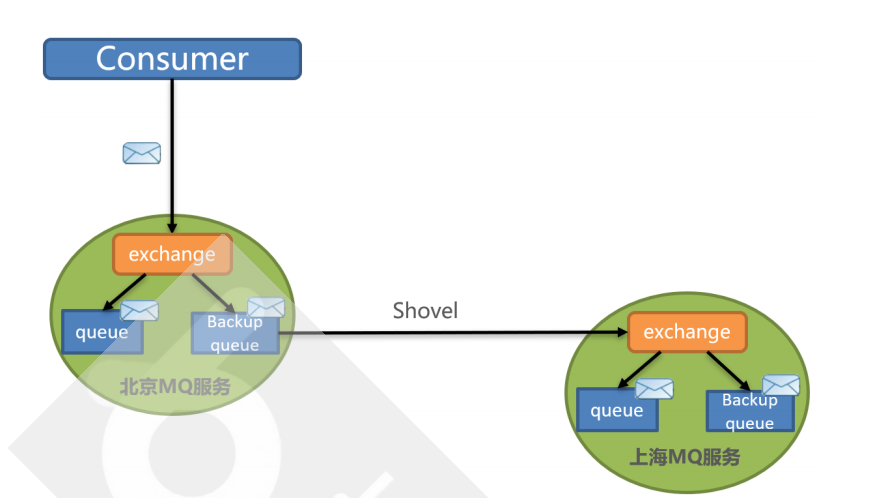

镜像模式(常用)
镜像模式:集群模式非常经典的就是Mirror镜像模式,保证100%数据不丢失,在实际工作中用的最多
的。并且实现集群非常的简单,一般互联网大厂都会构建这种镜像集群模式。
Mirror镜像队列,目的是为了保证rabbitmq数据的高可靠性解决方案,主要就是实现数据的同步,一般
来讲是2-3个实现数据同步(对于100%数据可靠性解决方案一般是3个节点)集群架构如下: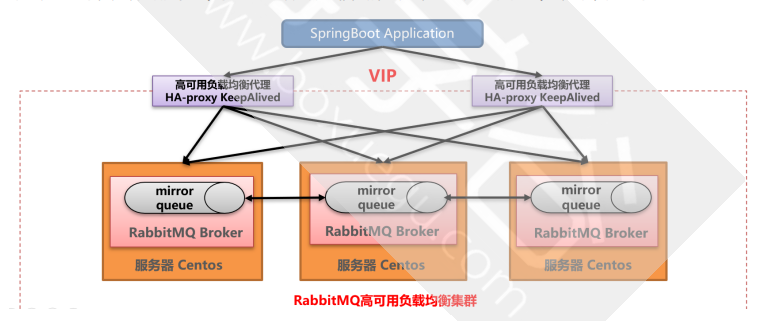
Keepalived的作用是检测服务器的状态,如果有一台web服务器宕机,或工作出现故障,Keepalived将
检测到,并将有故障的服务器从系统中剔除,同时使用其他服务器代替该服务器的工作,当服务器工作
正常后Keepalived自动将服务器加入到服务器群中,这些工作全部自动完成,不需要人工干涉,需要人
工做的只是修复故障的服务器。 多活模式
多活模式:这种模式也是实现异地数据复制的主流模式,因为Shovel模式配置比较复杂,所以一般来说
实现异地集群都是使用双活或者多活模式来实现的。这种模式需要依赖rabbitmq的federation插件,可
以实现继续的可靠AMQP数据通信,多活模式在实际配置与应用非常的简单。
RabbitMQ部署架构采用双中心模式(多中心),那么在两套(或多套)数据中心中各部署一套
RabbitMQ集群,各中心之间还需要实现队列消息共享。多活集群架构如下
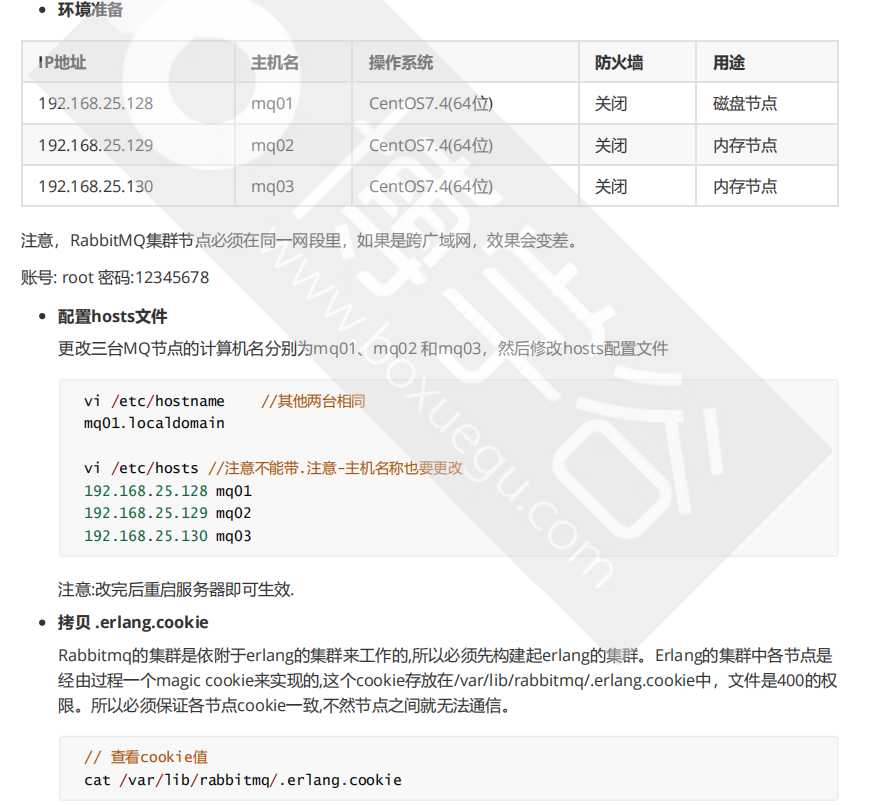
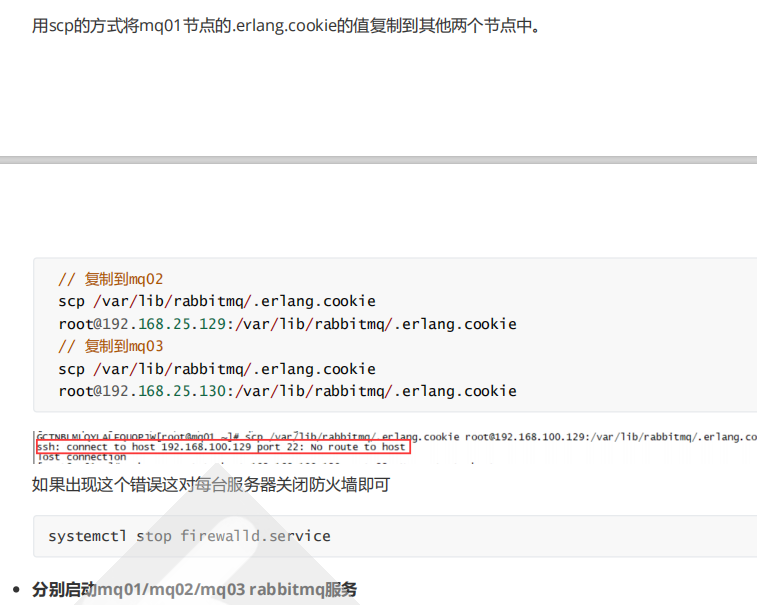
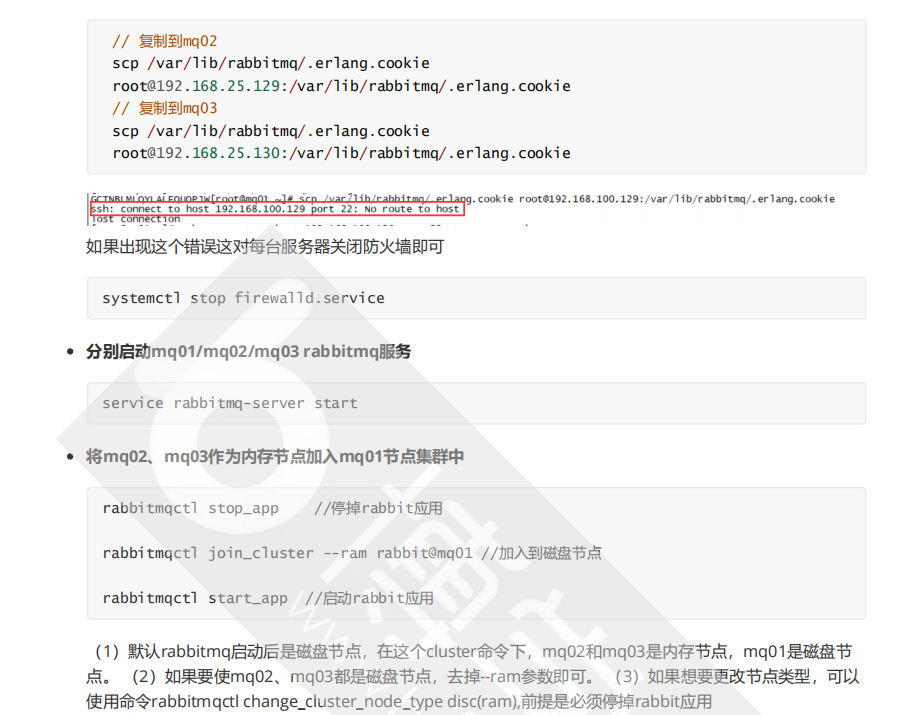

实际操作的三台rabbitmq服务器的ip
192.168.200.140
192.168.200.141
192.168.200.142镜像队列

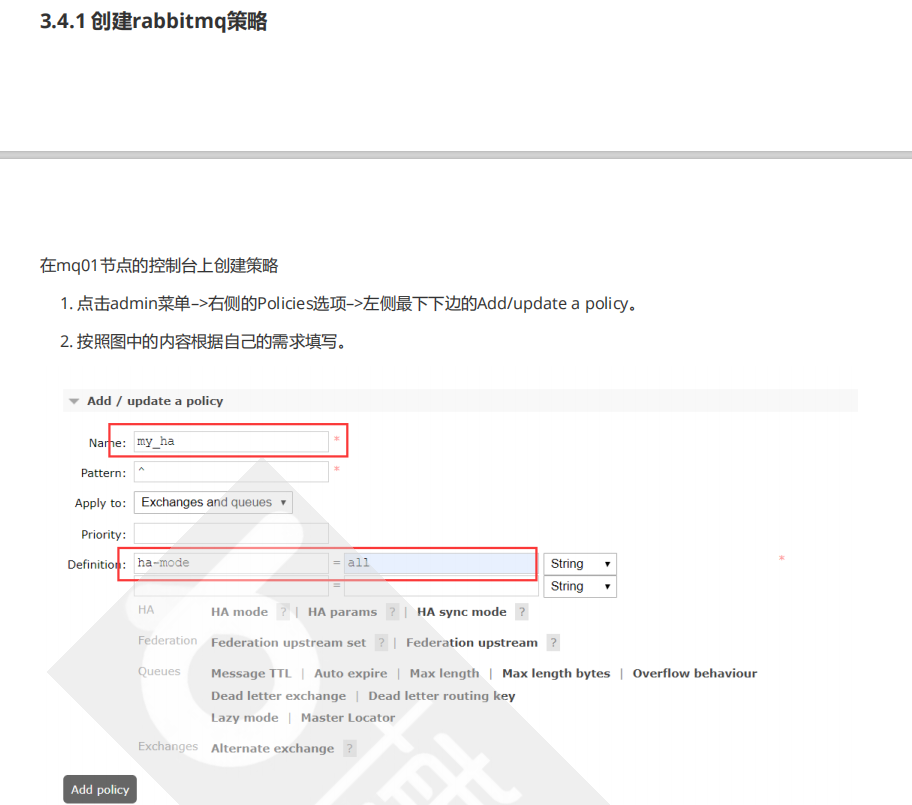


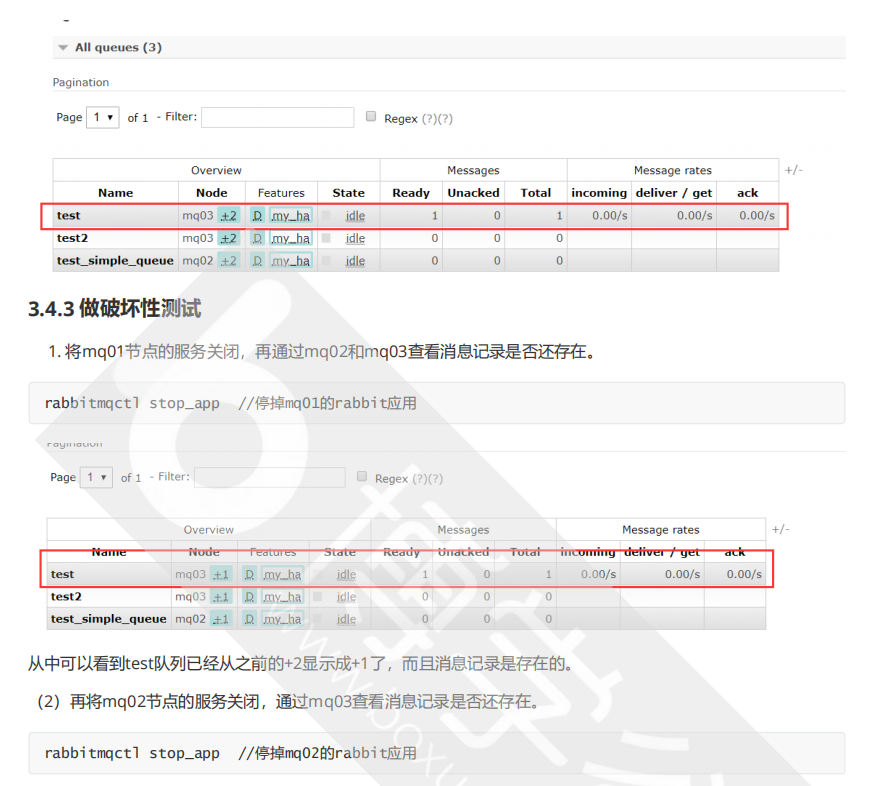

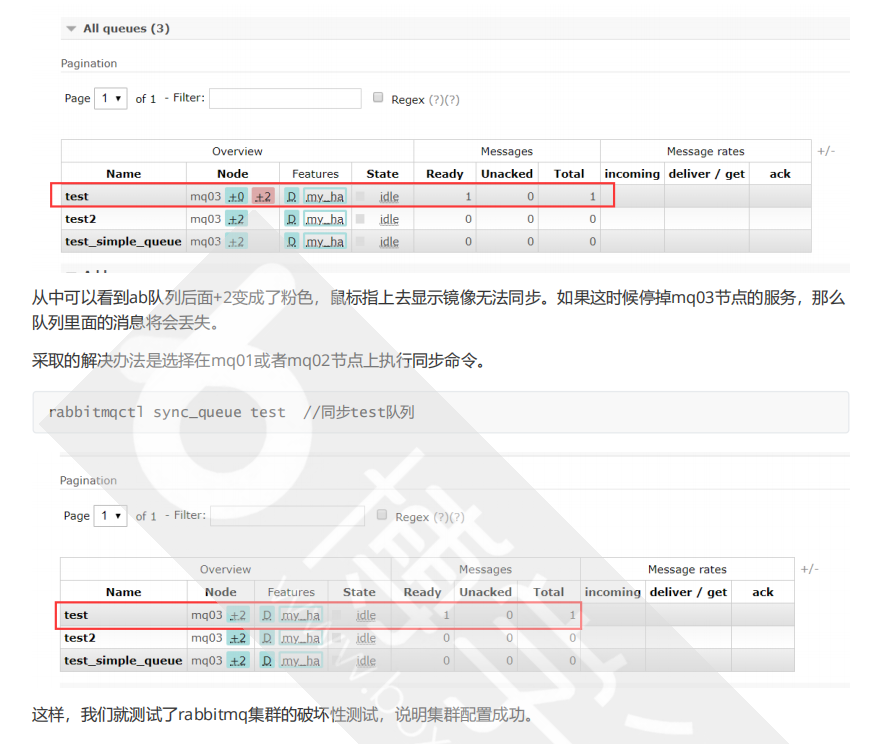
Haproxy负载代理
使用haproxy做负载均衡的代理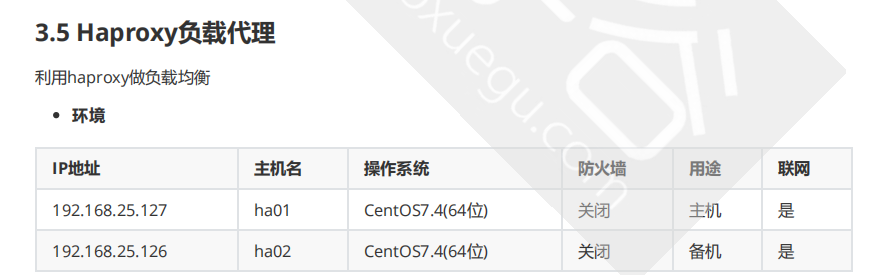
更正为
192.168.25.125(192.168.200.143)
192.168.25.126(192.168.200.144)
安装haproxy
yum install haproxy编辑配置文件
vim /etc/haproxy/haproxy.cfg修改配置文件,添加以下内容
#配置haproxy mq监控
listen rabbitmq_local_cluster 0.0.0.0:5672
#配置TCP模式
    mode tcp
    option tcplog
    #简单的轮询
    balance roundrobin
    #rabbitmq集群节点配置
    server rabbit1 192.168.200.140:5672 check inter 5000 rise 2 fall 2
    server rabbit2 192.168.200.141:5672 check inter 5000 rise 2 fall 2
    server rabbit3 192.168.200.142:5672 check inter 5000 rise 2 fall 2
#配置haproxy web监控,查看统计信息
listen private_monitoring :8100
    mode http
    option httplog
    stats enable
    #设置haproxy监控地址为http://IP:8100/stats
    stats uri /stats
    stats refresh 30s
    #添加用户名密码认证
    stats auth admin:1234
#配置haproxy mqweb监控,查看管理控制台
listen rabbitmq_web_local_cluster 0.0.0.0:15672
    #配置HTTP模式
    mode http
    option httplog
    #简单的轮询
    balance roundrobin
    #rabbitmq集群节点配置
    server web_rabbit1 192.168.200.140:15672 check inter 5000 rise 2 fall 2
    server web_rabbit2 192.168.200.141:15672 check inter 5000 rise 2 fall 2
    server web_rabbit3 192.168.200.142:15672 check inter 5000 rise 2 fall 2
启动
haproxy -f /etc/haproxy/haproxy.cfg启动成功以后访问不了请关闭防火墙
systemctl stop firewalld.servicekeepalived检测
安装keepalived
yum install keepalived打开配置文件
vi /etc/keepalived/keepalived.conf完成主备机的切换
主文件配置
覆盖keepalived.conf
! Configuration File for keepalived
# 全局配置,配置收件人
global_defs {
    notification_email {
        ##通知机制,收件人
        464164213@qq.com
    }
    notification_email_from keepalived@domain.com ####发件人
    smtp_server 192.168.200.143 ##发件服务器
    smtp_connect_timeout 30 ##服务器连接超时时间
    router_id LVS_DEVEL ##路由器标志
}
# 集群资源监控,组合track_script进行
vrrp_script check_haproxy {
    script "killall -0 haproxy"
    interval 2
}
vrrp_instance HAPROXY_HA {
    # 设置当前主机为主节点,如果是备用节点,则设置为BACKUP
    # 备用节点时,设置为:
    # state BACKUP
    state MASTER
    # 指定HA监测网络接口,可以用ifconfig查看来决定设置哪一个
    interface ens33
    # 虚拟路由标识,同一个VRRP实例要使用同一个标识,主备机
    virtual_router_id 80
    # 因为当前环境中VRRP组播有问题,改为使用单播发送VRRP报文
    # 这个地方需要关注,之前未做此设置,结果主备节点互相不能发现,因此主备节点都升级成了 MASTER,并且绑定了VIP
    # 主节点时,内容为:
    unicast_src_ip 192.168.200.143
        unicast_peer {
        192.168.200.144
    }
    # 备节点时,内容为:
    #unicast_src_ip 192.168.200.144
    #unicast_peer {
        #192.168.20.143
    #}
    # 设置优先级,确保主节点的优先级高过备用节点
    # 主节点时,设置为:
    priority 100
    # 备节点时,设置为:
    #priority 80
    # 用于设定主备节点间同步检查时间间隔
    advert_int 2
    # 设置高可用集群中不抢占功能,在主机down后,从机接管,当主机重新恢复后,设置此功能,备 机将继续提供服务,从而避免因切换导致的隐患
    nopreempt
    # 设置主备节点间的通信验证类型及密码,同一个VRRP实例中需一致
    authentication {
        auth_type PASS
        auth_pass 1234
    }
    #下面这些脚本都是写入日志,需要的话可以打开,自己写一个shell
    # 当keepalived切换状态到MASTER时,执行脚本
    #notify_master "/etc/keepalived/master.sh"
    # 当keepalived切换状态到BACKUP时,执行脚本
    #notify_backup "/etc/keepalived/backup.sh"
    # 当keepalived切换状态到FAULT时,执行脚本
    #notify_fault "/etc/keepalived/fault.sh"
    # 当keepalived切换状态到STOP时,执行脚本 #notify_fault "/etc/keepalived/stop.sh"
    # 集群资源监控,组合vrrp_script进行
    track_script {
        check_haproxy
    }
    # 设置虚拟IP地址,当keepalived状态切换为MASTER时,此IP会自动添加到系统中
    # 当状态切换到BACKUP时,此IP会自动从系统中删除
    # 可以通过命令ip add查看切换后的状态
    virtual_ipaddress {
        192.168.200.145 #虚拟ip配置完之后就用它访问
    }
}
备用机配置
! Configuration File for keepalived
# 全局配置,配置收件人
global_defs {
    notification_email {
        ##通知机制,收件人
        464164213@qq.com
    }
    notification_email_from keepalived@domain.com ####发件人
    smtp_server 192.168.200.144 ##发件服务器
    smtp_connect_timeout 30 ##服务器连接超时时间
    router_id LVS_DEVEL ##路由器标志
}
# 集群资源监控,组合track_script进行
vrrp_script check_haproxy {
    script "killall -0 haproxy"
    interval 2
}
vrrp_instance HAPROXY_HA {
    # 设置当前主机为主节点,如果是备用节点,则设置为BACKUP
    # 备用节点时,设置为:
    state BACKUP
    # 指定HA监测网络接口,可以用ifconfig查看来决定设置哪一个
    interface ens33
    # 虚拟路由标识,同一个VRRP实例要使用同一个标识,主备机
    virtual_router_id 80
    # 因为当前环境中VRRP组播有问题,改为使用单播发送VRRP报文
    # 这个地方需要关注,之前未做此设置,结果主备节点互相不能发现,因此主备节点都升级成了 MASTER,并且绑定了VIP
    # 备节点时,内容为:
    unicast_src_ip 192.168.200.144
        unicast_peer {
            192.168.20.143
        }
    # 设置优先级,确保主节点的优先级高过备用节点
    # 备节点时,设置为:
    priority 80
    # 用于设定主备节点间同步检查时间间隔
    advert_int 2
    # 设置高可用集群中不抢占功能,在主机down后,从机接管,当主机重新恢复后,设置此功能,备 机将继续提供服务,从而避免因切换导致的隐患
    nopreempt
    # 设置主备节点间的通信验证类型及密码,同一个VRRP实例中需一致
    authentication {
        auth_type PASS
        auth_pass 1234
    }
    #下面这些脚本都是写入日志,需要的话可以打开,自己写一个shell
    # 当keepalived切换状态到MASTER时,执行脚本
    #notify_master "/etc/keepalived/master.sh"
    # 当keepalived切换状态到BACKUP时,执行脚本
    #notify_backup "/etc/keepalived/backup.sh"
    # 当keepalived切换状态到FAULT时,执行脚本
    #notify_fault "/etc/keepalived/fault.sh"
    # 当keepalived切换状态到STOP时,执行脚本 #notify_fault "/etc/keepalived/stop.sh"
    # 集群资源监控,组合vrrp_script进行
    track_script {
        check_haproxy
    }
    # 设置虚拟IP地址,当keepalived状态切换为MASTER时,此IP会自动添加到系统中
    # 当状态切换到BACKUP时,此IP会自动从系统中删除
    # 可以通过命令ip add查看切换后的状态
    virtual_ipaddress {
        192.168.200.145 #虚拟ip配置完之后就用它访问
    }
}
启动
systemctl start keepalived.service查看是否启动成功
ps -ef | grep keepalived在主节点上查查看网卡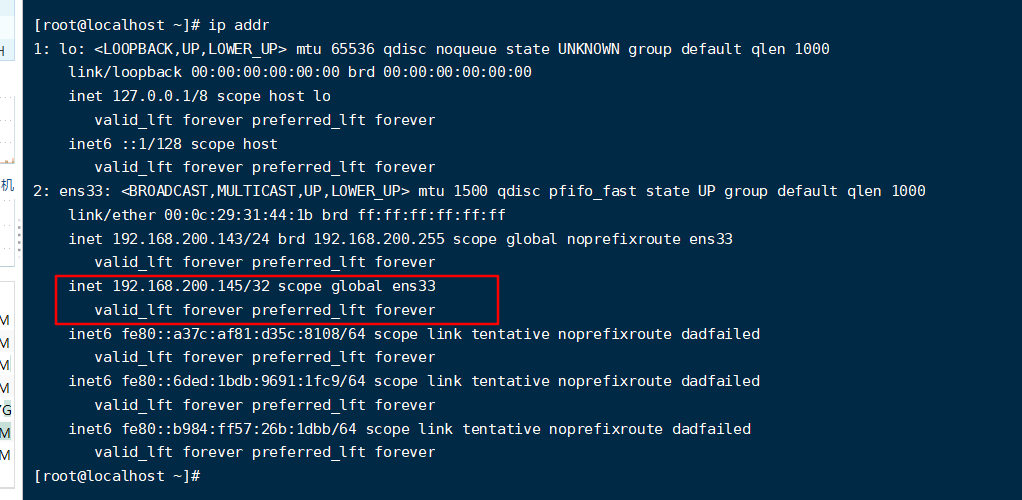
在备用机节点找不到虚拟的ip
然后访问192.168.200:145:8100/stats admin 1234
192.168.200:145:15672
关闭主节点
查看备用机的网卡发现虚拟ip
此时做到了ip漂移到备用节点
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论