YOLO V2
文章目录
原文1:https://zhuanlan.zhihu.com/p/...
原文2:https://zhuanlan.zhihu.com/p/...
YOLO V2 概述
先解释概念:Yolov2和Yolo9000算法内核相同,区别是训练方式不同:Yolov2用coco数据集训练后,可以识别80个种类。而Yolo9000可以使用coco数据集 + ImageNet数据集联合训练,可以识别9000多个种类。图一为Yolo9000的检测效果图,可以看到图片中的人,被分为了leader、American、skin-diver、athlete。
预测更准确
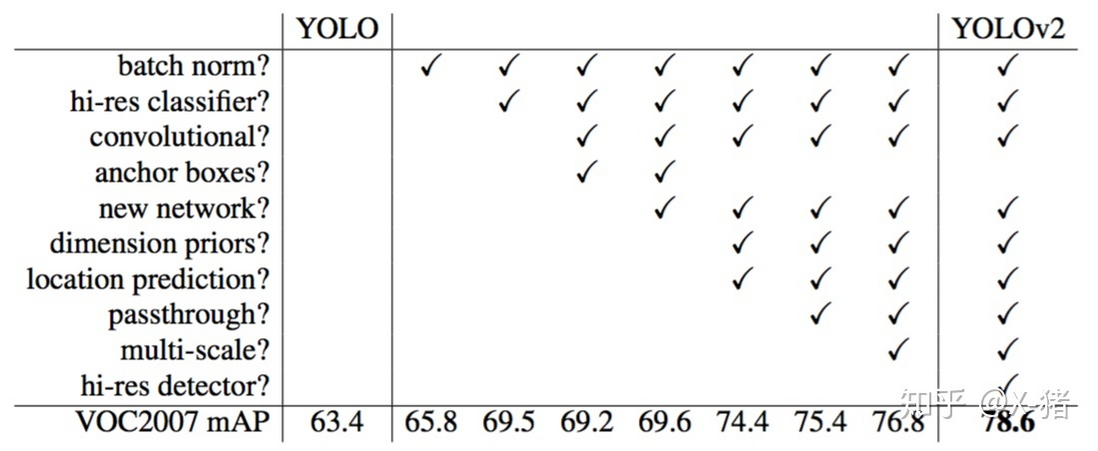
1. batch normalization(批归一化)
mAP提升2.4
2. 使用高分辨率图像微调分类模型
mAP提升3.7
YOLO2在采用 224224 图像进行分类模型预训练后,再采用 448448 的高分辨率样本对分类模型进行微调(10个epoch),使网络特征逐渐适应 448448 的分辨率。然后再使用 448448 的检测样本进行训练,缓解了分辨率突然切换造成的影响。
3.采用先验框(Anchor Boxes)
召回率大幅提升到88%,同时mAP轻微下降了0.2。
借鉴Faster RCNN的做法,YOLO2也尝试采用先验框(anchor)。在每个grid预先设定一组不同大小和宽高比的边框,来覆盖整个图像的不同位置和多种尺度,这些先验框作为预定义的候选区在神经网络中将检测其中是否存在对象,以及微调边框的位置。
4. 聚类提取先验框尺度、约束预测边框的位置
mAP提升4.8
之前先验框都是手工设定的,YOLO2尝试统计出更符合样本中对象尺寸的先验框,这样就可以减少网络微调先验框到实际位置的难度。
另一个是约束边框的位置,主要是约束先验框的中心在特定的网格里。提高模型的稳定性。
5. passthrough层检测细粒度特征
mAP提升1
对象检测面临的一个问题是图像中对象会有大有小,输入图像经过多层网络提取特征,最后输出的特征图中(比如YOLO2中输入416416经过卷积网络下采样最后输出是1313),较小的对象可能特征已经不明显甚至被忽略掉了。为了更好的检测出一些比较小的对象,最后输出的特征图需要保留一些更细节的信息。
YOLO2引入一种称为passthrough层的方法在特征图中保留一些细节信息。具体来说,就是在最后一个pooling之前,特征图的大小是2626512,将其1拆4,直接传递(passthrough)到pooling后(并且又经过一组卷积)的特征图,两者叠加到一起作为输出的特征图。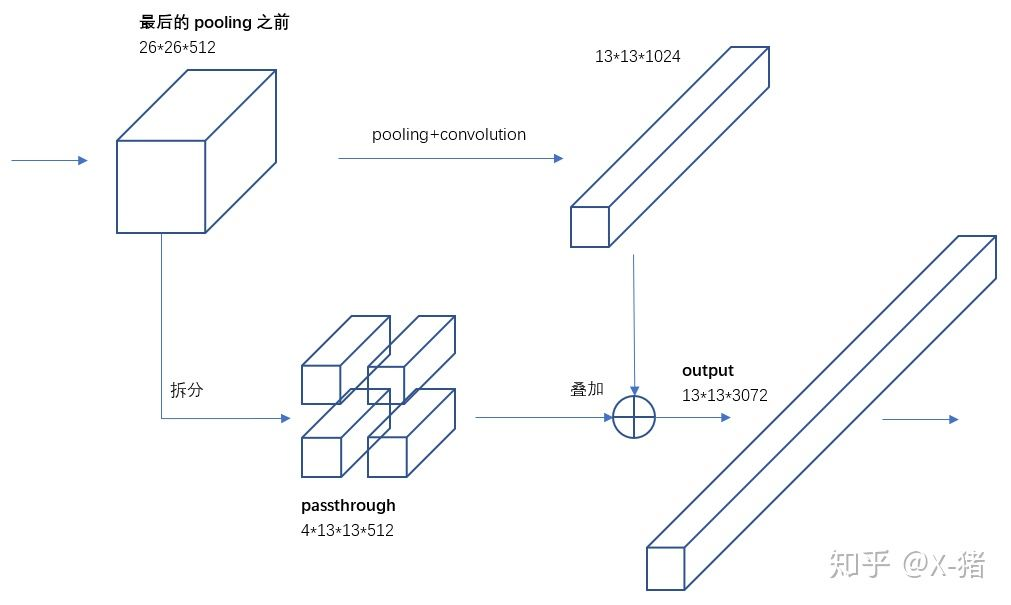
6. 多尺度图像训练
mAP有1.4的提升
因为去掉了全连接层,YOLO2可以输入任何尺寸的图像。因为整个网络下采样倍数是32,作者采用了{320,352,...,608}等10种输入图像的尺寸,这些尺寸的输入图像对应输出的特征图宽和高是{10,11,...19}。训练时每10个batch就随机更换一种尺寸,使网络能够适应各种大小的对象检测。
7. 高分辨率图像的对象检测
图1表格中最后一行有个hi-res detector,使mAP提高了1.8。因为YOLO2调整网络结构后能够支持多种尺寸的输入图像。通常是使用416416的输入图像,如果用较高分辨率的输入图像,比如544544,则mAP可以达到78.6,有1.8的提升。
速度更快
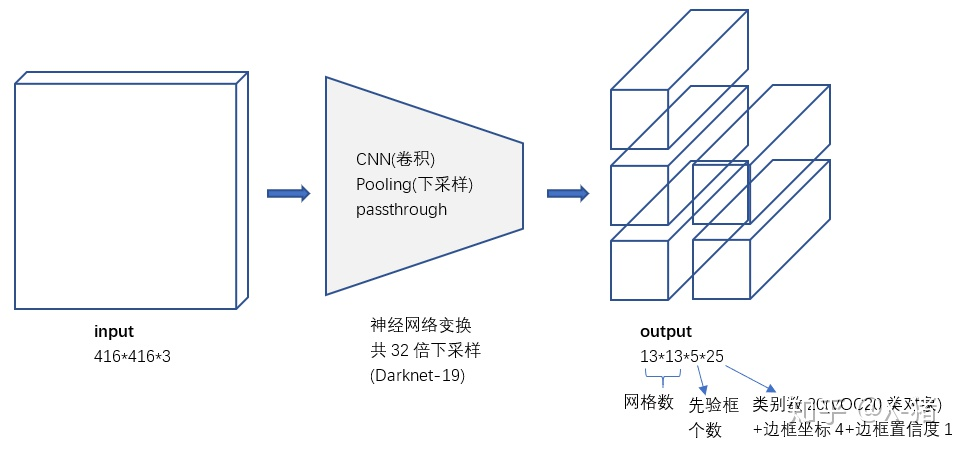
为了进一步提升速度,YOLO2提出了Darknet-19(有19个卷积层和5个MaxPooling层)网络结构。DarkNet-19比VGG-16小一些,精度不弱于VGG-16,但浮点运算量减少到约1/5,以保证更快的运算速度。
输入输出
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论