Python 代码加速:实用小技巧
文章目录
Python 代码加速:实用小技巧
Python几乎是必学的编程语言,它编写容易,上手简单,也有丰富的软件工具包。
然而,Python素来被人诟病效率低下。确实,相比于C/C++,裸写的Python确实很慢。
不过,在机器学习/深度学习的场景下,Python其实更像一个“胶水”语言,用来串联各类工具包和组件,一般不会成为主要的效率瓶颈。
但是,我们也经常用Python来处理数据:要么离线处理,要么在DataLoader里动态处理。很多时候这些代码的运行效率也很低,尤其是在数据处理逻辑复杂的情况下。
本文将教大家一些简单的使用技巧,来加速你的Python代码。
- Profiling:定位瓶颈
- LRU Cache:一行代码加速
- JIT:静态语言性能
- 多进程:解放多核性能
- 共享内存:避免多进程内存爆炸
1. Profiling: 定位瓶颈
定位瓶颈永远是最关键的一步,只有知道瓶颈在哪,才能有针对性地进行优化。
除了理论分析,在实践中,我们也可以借助各种工具,来定位瓶颈在哪。
大家最熟悉的方法也就是直接统计运行的时间。
import timeit

timeit.timeit("1 + 2")
timeit 是很常见的一个统计方法,但局限也比较明显,只能统计一些简单的语句,对于复杂的函数或已有的代码不太方便使用。
另一个常用的是 profile,可以统计更复杂的函数。
import profile

def sum(a, b):
    return a + b

def test_sum(n=100):
    s = 0
    for i in range(n):
        s = sum(s, i)
    return s

profile.run("test_sum(100000)")
我们更推荐用profile,因为它支持更复杂的输入,也可以分析出函数的层级调用,并给出详细的统计。
如果你需要一些更细节的统计,也可以用line_profiler和memory_profiler,分别得到每一行代码的运行统计,及对应的内存占用。
在本文,我们主要关心运行时间,所以也简单实现了一个装饰器,用于统计函数的运行时间。
from functools import wraps
import time


def timeit(func):
    @wraps(func)
    def timeit_wrapper(*args, **kwargs):
        start_time = time.perf_counter()
        result = func(*args, **kwargs)
        end_time = time.perf_counter()
        total_time = end_time - start_time
        print(f'Function {func.__name__} Took {total_time:.8f} seconds')
        return result
    return timeit_wrapper

@timeit
def test_sum(n=100):
    s = 0
    for i in range(n):
        s += i
    return s

test_sum(100000)
这个装饰器的使用非常简单,只需要在函数前加一个@timeit,就会自动执行timeit_wrapper里实现的在函数调用前后插入的计时统计代码。
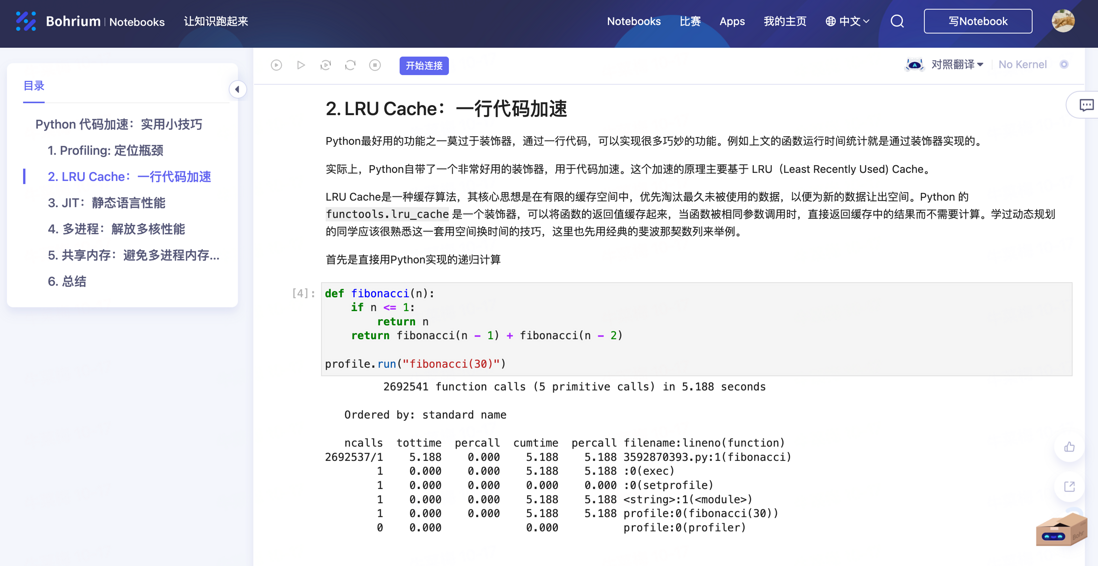
此外,还可以通过LRU Cache,JIT,多进程,共享内存来进行加速,此处就不展开细说了,可自行点击查看
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论