大军闲聊 -- 注册中心之注册
文章目录
注册中心,是为了解决分布式系统中,服务发现的问题,也就是说,服务A想调用服务B,需要知道服务B的地址是什么,而注册中心,就是提供这个功能。
所以服务A和服务B,需要把自己的信息发送给注册中心进行注册。
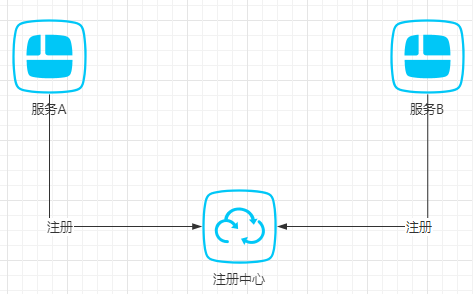
注册中心,如果只有一个服务,那会有单点故障问题的,导致整个系统瘫痪,所以生产上都是集群部署的。
那就有一个问题,服务是怎么注册到注册中心的呢?向任意一个注册中心注册还是向所有的注册中心注册?
Nacos&Eureka
Nacos&Eureka都是peer 2 peer的模式,所以在注册的大体流程上是一样的。
服务A随机找一个Server,然后进行注册,如果注册失败,就换下一个Server进行注册。(服务B同理)

在peer 2 peer模式下,每个Server都是对等的,但是注册的时候只往一个Server注册,所以每个Server之间要进行数据同步。
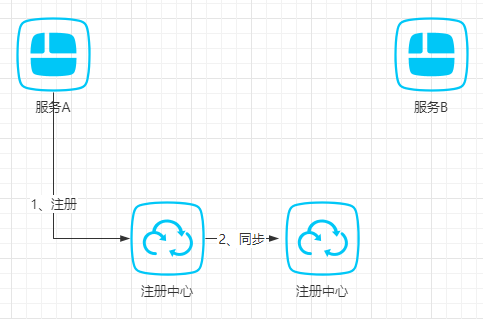
数据同步包括2种,一个是增量同步,一个是全量同步。
增量同步一般在服务注册或服务信息变更的时候,把服务同步到其他Server。由于同步是网络请求比较耗时,一般都是放入队列或则缓存中,用其他线程进行同步。
全量同步一般是在服务初始化数据或则当前服务发现本身有误,会从其他服务获取全量数据。

peer 2 peer还有一个问题,就是数据的一致性问题,也就是AP模型还是CP模型。
AP性能较高,数据是弱一致性。CP性能较差,数据是强一致性。
Nacos通过临时节点和永久节点,实现AP模型和CP模型。
Eureka是CP模型。
Rocketmq
Rocketmq的NameServer也是一个注册中心,也是peer 2 peer的模式。
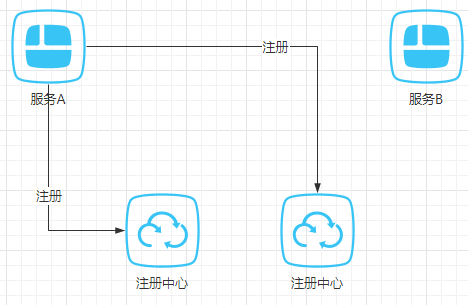
Broker启动的时候,会开启一个定时任务,向集群的所有NameServer进行注册。
因为Broker是直接向所有的NameServer注册,所以NameServer之间的数据就不需要进行同步。
由于网络波动或者其他问题,数据也是弱一致性的,在某个时刻的数据可能并不会相同。
Zookeeper
Zookeeper是Master Slave模式的,只有Master节点可以写,然后同步到其他Follower节点。

Spark
Spark是Master Slave模式的(基于ZooKeeper的持久化引擎来说明)。也就是他是有2个Master,但是一个是ALIVE,一个是STANDBY。哪个为ALIVE节点,通过获取Zookeeper的临时节点来决定的。
当Worker往Master注册的时候,Master除了把Worker的信息保存在内存中,还会把Worker的信息在Zookeeper中进行了持久化,这样也保证的系统的一致性。
当ALIVE节点宕机后,STANDBY就会从Zookeeper中获取Worker数据继续提供服务。

Hadoop
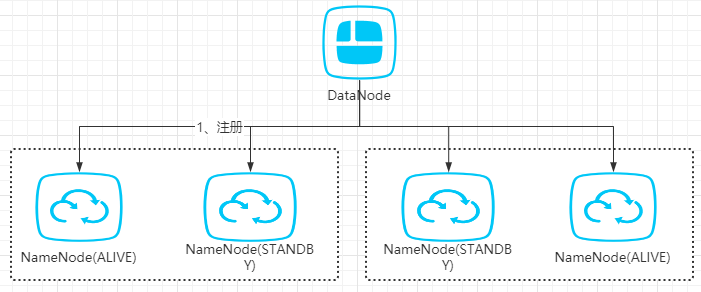
Hadoop的高可用,也是Master Slave模式的,而且还有联邦模式。
所以DataNode注册的时候,需要查看有多少个联邦,再给每一个联邦的ALIVE节点和STANDBY节点注册。
当ALIVE节点宕机后,STANDBY节点会切换到ALIVE节点,此时也有完整的注册信息。
总结

评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论