A Path Towards Autonomous Machine Intelligence
文章目录
论文链接:https://openreview.net/forum?...
论文内容
一、自主机器智能
关于自主机器智能,论文给出了这样的描述:
动物和人类表现出的学习能力和对世界的理解远远超出了当前人工智能和机器学习 (ML) 系统的能力。
一个青少年怎么可能在大约 20 小时的练习中学会开车,而孩子怎么可能只需要少量接触就可以学习语言。答案可能在于人类和许多动物学习世界模型的能力,即世界如何运作的内部模型。
今天,关于自主机器智能,人工智能研究必须解决三个主要挑战:
- 机器如何通过观察来学习代表世界、学习预测和学习采取行动?现实世界中的交互既昂贵又危险,智能代理应该在没有交互的情况下(通过观察)尽可能多地了解世界,以尽量减少学习特定任务所需的昂贵和危险试验的数量。
- 机器如何以与基于梯度的学习兼容的方式进行推理和计划?我们最好的学习方法依赖于估计和使用损失的梯度,这只能在可微架构中执行,并且很难与基于逻辑的符号推理相协调。
- 机器如何学习以分层的方式、在多个抽象级别和多个时间尺度上表示感知和行动计划?人类和许多动物能够构想多层次的抽象,通过将复杂的动作分解为较低层次的序列,可以进行长期预测和长期规划。
本篇文章提出了一种智能代理架构——世界模型,可以解决所有三个挑战。
本文的主要贡献如下:
- 一个整体认知架构,其中所有模块都是可区分的,其中许多模块是可训练的;
- JEPA 和分层 JEPA:用于学习表示层次结构的预测世界模型的非生成架构;
- 一种非对比的自我监督学习范式,它产生的表征同时具有信息性和可预测性;
- 一种使用 H-JEPA 作为预测世界模型基础的方法,用于不确定性下的分层规划;
二、世界模型

世界模型是自主智能的系统架构。 该模型中的所有模块都被假定为“可微分的”,一个模块馈入另一个模块(通过连接它们的箭头)可以获得成本的标量输出相对于其自身输出的梯度估计。
构成:
- Configurator;根据任务调制其他模块的参数和注意力网络;
- Perception;估计当前的状态;
- World Model;根据Actor提出的想象动作序列预测可能的未来世界状态;
- Cost Module;计算一个称为“能量”的标量输出,用于衡量智能体的不适程度。 它由两个子模块组成,Intrinsic Cost,它是不可变的(不可训练的)并计算当前状态(疼痛、快乐、饥饿等)的即时能量,以及Critic,一个预测未来值的可训练模块 的内在成本;
- Short-term Memory;跟踪当前和预测的世界状态以及相关的内在成本;
- Actor;计算建议的动作序列。 World Model和Critic计算可能的结果, Actor通过合作可以找到一个使估计的未来成本最小的最优动作序列;
2.1 Perception-Action Loops
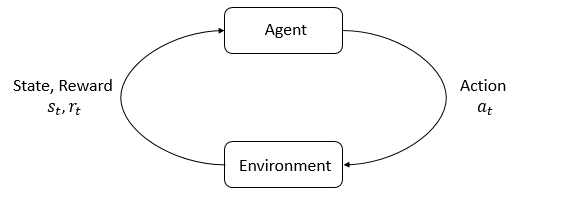
经典的强化学习模型如上图所示,和经典强化学习一样,世界模型通过Perception-Action Loop学习。
世界模型有两种运作模式Mode-1(反应性行为)和Mode-2(使用世界模型进行推理和规划)。Mode-1是典型的强化学习方式,是Perception -> Actor的循环。在执行过程中可以选择记录percept和action,用于离线训练World Model。
Mode-2类似最优控制和机器人技术的MPC,通过World Model和Cost Module进行推理和规划,可以用来执行复杂任务,Mode-2执行逻辑如下:
- perception: the perception system extract a representation of the current state of the world \( s[0]=P(x) \). The cost module computes and stores the immediate cost associated with that state.
- action proposal: the actor proposes an initial sequence of actions to be fed to the world model for evaluation \( (a[0], ..., a[t], ..., a[T]) \).
- simulation: the world model predicts one or several likely sequence of world state representations resulting from the proposed action sequence \( (s[1], ..., s[t], ..., s[T]) \).
- evaluation: the cost module estimates a total cost from the predicted state sequence, generally as a sum over time steps \( F(x)=\sum_{t=1}^{T} C(s[t]) \).
- planning: the actor proposes a new action sequence with lower cost. This can be done through a gradient-based procedure in which gradients of the cost are back-propagated through the compute graph to the action variables. The resulting minimum-cost action sequence is denoted \( (\v{a}[0], ..., \v{a}[T]) \). Full optimization may require iterating steps 2-5.
- acting: after converging on a low-cost action sequence, the actor sends the first action (or first few actions) in the low-cost sequence to the effectors. The entire process is repeated for the next perception-action episode.
- memory: after every action, the states and associated costs from the intrinsic cost and the critic are stored in the short-term memory. These pairs can be used later to train or adapt the critic.
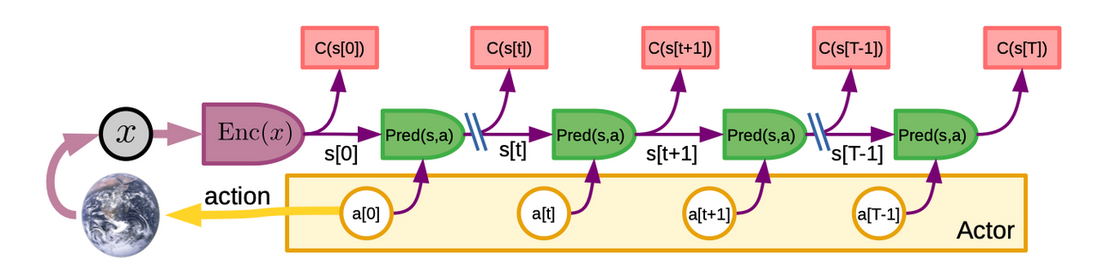
损失函数是:
$$ L(\theta_1, \theta_2, x) = WC(Actor(\theta_1, Perception(\theta_2, x))) $$
其中WC是World Model和Cost Module的组合函数,输入Actor建议的行动序列\( (a[0], ..., a[t], ..., a[T]) \),预测状态\( (s[1], ..., s[t], ..., s[T]) \),并计算损失\( F(x)=\sum_{t=1}^{T} C(s[t]) \)。
使用Mode-2很麻烦。 Agent只有一个世界模型“引擎”。 它可由配置器针对手头的任务进行配置,但一次只能用于单个任务。 因此,与人类类似,Agent一次只能专注于一项复杂的任务。
Mode-1的繁重程度要低得多,因为它只需要通过一个策略模块。 代理可能拥有多个同时工作的策略模块,每个模块专门用于一组特定的任务。
这个过程允许Agent使用其世界模型和推理能力的全部力量来获取新技能,然后将这些技能“编译”到不再需要仔细规划的反应策略模块中。
2.2 Cost Module
世界模型的行动由Cost Module驱动。Cost Module由不变的Intrinsic Cost Module和可训练的The Critic构成。IC 和 TC 都由多个子模块组成,它们的输出能量是线性组合的。 每个子模块在代理中赋予特定的行为驱动。 线性组合中的权重\( u_i \)和\( v_j \)由配置器模块确定,并允许智能体在不同时间专注于不同的子目标。
$$ C(s) = IC(s) + TC(s); IC(s) = \sum_{i=1}^k u_i IC_i(s); TC(s) = \sum_{j=1}^l v_j TC_j(s) $$
内在成本模块 (IC) 是定义代理的基本行为性质的地方。 这是可以间接指定基本行为的地方。
对于机器人来说,这些术语将包括与“疼痛”、“饥饿”和“本能恐惧”相对应的明显本体感受测量,测量诸如外力过载、危险的电气、化学或热环境、过度功耗、 电源中的能量储备水平低等。
同时为了防止某种行为崩溃或不受控制地转向不良行为,IC 必须是不可变的,并且不受学习(也不受外部修改)的影响。
2.2.1 训练TC
TC有两个主要作用:(1)以最少的世界模型使用来预测长期结果,以及(2)允许Configurator通过配置修改专注子目标。
TC的主要角色是预测IC的未来值。通过检索过去的状态向量\( s_{\tau} \)以及稍后时间 \( IC(s_\tau + \delta) \)的固有能量,可以训练TC来预测未来的固有能量值。 然后可以优化TC的参数以最小化预测损失,例如\( ||IC(s_\tau + \delta) - TC(s_\tau)||^2 \)。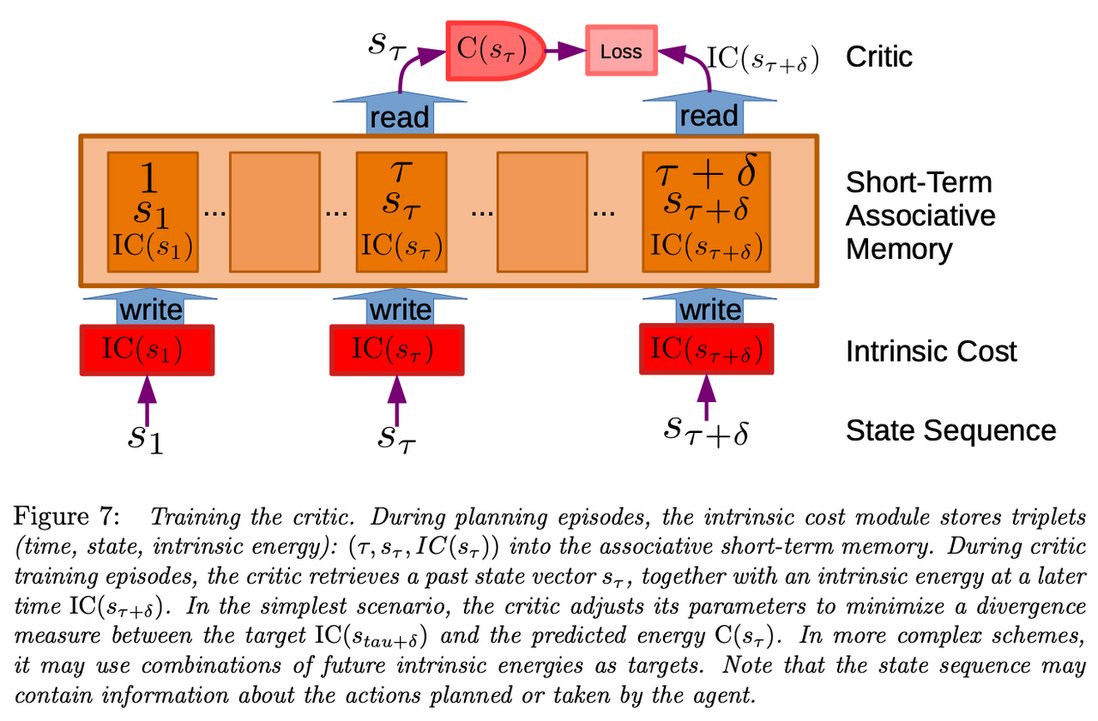
2.3 训练世界模型
训练世界模型是自我监督学习(SSL)的一个典型例子,其基本思想是模式补全。 对未来输入(或暂时未观察到的输入)的预测是模式补全的一个特例。 在这项工作中,世界模型的主要目的被视为预测世界状态的未来表示。
这里有三个主要问题需要解决:
- 首先,很明显,世界模型的质量将在很大程度上取决于状态序列的多样性,或者它在训练时能够观察到的三元组(状态、动作、结果状态)。
- 其次,由于世界不是完全可预测的,因此可能存在多个合理的世界状态表示,它们遵循给定的世界状态表示和代理的动作。 世界模型必须能够有意义地表示这个可能无限的合理预测集合。
- 第三,世界模型必须能够在不同的时间尺度和不同的抽象层次上做出预测。
Lecun设计了JEPA结构,用来解决上述三个问题,JEPA会在 三、JEPA 讲到。
2.4 信息收集
还记得问题
机器如何通过观察来学习代表世界、学习预测和学习采取行动?现实世界中的交互既昂贵又危险,智能代理应该在没有交互的情况下(通过观察)尽可能多地了解世界,以尽量减少学习特定任务所需的昂贵和危险试验的数量。机器如何通过观察来学习代表世界、学习预测和学习采取行动?
通过研究信息收集,尝试解决这个问题。论文列出五种信息收集模式,认为Agent可以通过这些模式了解世界是如何运作的:
- 被动观察:代理正在接收传感器流(例如视频、音频等)
- 活跃的foveation(注意力):代理正在被馈送一条流,在该流中可以引导注意力而不影响环境。例如,在能够定位视觉和声音传感器的同时观看一个场景,或者被馈送一个广角、高分辨率的视频和/或音频流,在其中可以引导注意力的焦点。
- 被动代理:感知流,其中正在观察另一个代理对环境的作用,从而能够推断代理行为对环境状态的因果影响。
- 主动自我运动:代理接收来自真实或虚拟环境的感觉流,在其中可以修改传感器的位置而不会显着影响环境。这可能包括可操纵的有源传感器(例如距离传感器、热传感器、化学传感器)以及触摸传感器。
- 主动代理:受代理行为影响的感觉流。这使得能够建立因果模型,在其中代理可以学习预测其行为的后果。这种模式将探索与开发的困境带到了最前沿。
在复杂的环境中,为世界模型收集足够的被动数据以捕获足够部分的环境行为可能是不切实际的。 模式 2、4 和 5 允许代理收集最大程度地了解环境的信息。 但要做到这一点可能需要内在的动机模块来驱动注意力、好奇心和探索驱动到世界模型的预测当前不准确或不确定的状态空间的角落。
主要的悬而未决的问题是使用被动观察可以学到多少(模式 1、2、3),多少需要自我运动(模式 4),以及多少需要完全代理(模式 5)。
2.5 设计和训练Actor
Actor有三个作用:
- 在Mode-2过程中,推断出使成本最小化的最优动作序列。
- 产生代表Agent不知道的世界状态部分的潜在变量的多种配置。
- 训练产生Mode-1 行动的政策网络。
这里有一个有趣的设计,Action就是潜变量,世界模型接受Action来获取观察不到的世界状态。潜变量会在JEPA章节解释。
当世界模型和成本表现良好时,Actor 模块可以使用基于梯度的优化过程来推断最佳动作序列。为此,它接收通过通过成本和展开的世界模型反向传播梯度计算的成本梯度的估计。它使用这些估计来更新动作序列。
当世界模型或成本表现不佳时,基于梯度的最佳动作序列搜索可能会失败。在这种情况下,可以应用另一种搜索/规划方法。如果动作空间是离散的或可以离散的,可以使用动态规划方法或近似动态规划方法,例如束搜索或蒙特卡洛树搜索。实际上,在优化控制、机器人或“经典”人工智能的背景下开发的任何规划方法都可以在这种情况下使用。
一旦通过规划/推理/优化过程获得最佳动作序列,就可以将动作作为目标来训练策略网络。策略网络随后可用于快速行动,或仅用于在优化阶段之前将建议的行动序列初始化为良好的起点。可以针对多个任务训练多个策略网络。
2.6 设计Configurator
Configurator是Agent的主要控制器。它从所有其他模块获取输入并调整它们的参数和连接图。调制路由信号、激活子网络、聚焦注意力等。在World Model和Perception的上层是Transformer的场景下,Configurator输出可能构成这些Transformer的额外输入令牌,从而调制它们的连接图和函数。
Configurator模块之所以必要,有两个原因:硬件重用和知识共享。能够为多个任务重用相同的网络有一个明显的优势,特别是如果任务可以按顺序完成,并且资源量(例如参数内存)是有限的。但还有另一个优势:知识重用。一个合理的假设是,针对给定环境训练的世界模型可以用于一系列不同的任务,只需进行微小的更改。可以想象一个环境的“通用”世界模型,其中一小部分参数由Configurator为手头的任务进行调制。这将比为每个技能使用单独的世界模型更有效地提高数据效率和计算效率。缺点是Agent一次只能完成一项任务。
论文提到一个尚未解决的问题是Configurator如何学习将复杂的任务分解为一系列子目标,这些子目标可以由Agent单独完成。
三、JEPA
JEPA是解决2、3问题的关键,也是这篇论文的主要贡献。
- 机器如何以与基于梯度的学习兼容的方式进行推理和计划?我们最好的学习方法依赖于估计和使用损失的梯度,这只能在可微架构中执行,并且很难与基于逻辑的符号推理相协调。
- 机器如何学习以分层的方式、在多个抽象级别和多个时间尺度上表示感知和行动计划?人类和许多动物能够构想多层次的抽象,通过将复杂的动作分解为较低层次的序列,可以进行长期预测和长期规划。
3.1 为什么选择JEPA?
论文没有一个总结性说明,个人理解选择JEPA,是因为JEPA是生成模型 ,能够学习不确定的状态,能够对状态选择性编码。下面引用论文内容介绍。
3.1.1 JEPA是生成模型
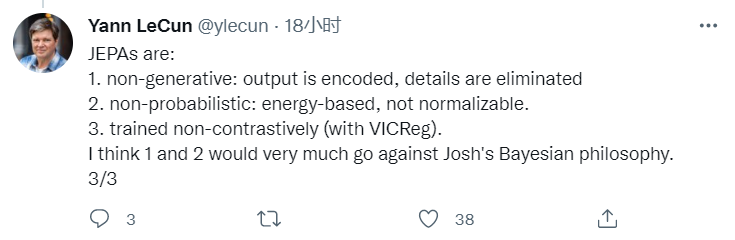
数学上,JEPA属于能量模型Energy-Based Model(是一种生成模型 Generative Model)。论文中使用的能量模型可以定义为,一个能量函数\( F: X \times Y \rightarrow R \),标量\( F(x, y) \)表示\( x \)和\( y \)的相关程度,又叫做能量(Energy);能量函数可以用自监督的方式训练,训练学习系统通过标量值能量函数\( F(x, y) \)捕获\( x \)和\( y \)之间的依赖关系,当\( x \)和\( y \)一致或兼容时取低值,如果\( x \)和\( y \)不一致或不兼容则取高值。在视频预测场景中,如果视频剪辑\( y \)是视频剪辑\( x \)的合理延续,系统将产生低能量值。 这种基于能量的模型 (EBM) 公式使系统能够表示多模态依赖关系,其中\( y \)的多个值(可能是无限集)可能与给定的\( x \)兼容。 在下图右侧面板中,表示能量景观,其中深色圆盘表示数据点,闭合线表示能量函数的轮廓(水平集)。
3.1.2 使用潜变量处理不确定性

想象一个场景,其中 x 是一个场景的照片,而 y 是从稍微不同的视点拍摄的同一场景的照片。要判断 x 和 y 是否确实是来自同一场景的视图,可能需要推断相机在两个视图之间的位移。类似地,如果 x 是一辆汽车驶向岔路口的图片,而 y 是几秒钟后同一辆车在岔路口之一上的图片,则 x 和 y 之间的兼容性取决于二进制可以推断的潜变量:汽车是左转还是右转。
在时间预测场景中,潜变量表示仅从 x 和过去的观察(过去)无法预测关于 y(未来)的内容。它应该包含对预测有用但不可观察或不可知的所有信息。我可能不知道我前面的司机是左转还是右转、加速还是刹车,但我可以用一个潜在变量来表示这些选项。
如上所述,主要问题之一是使模型能够表示多个预测。这可能需要使用潜变量。潜变量是一个输入变量,其值不是观察到而是推断出来的。潜变量可以被视为参数化 x 和一组兼容 y 之间的可能关系集。潜变量用于表示无法从 x 中提取的关于 y 的信息。
潜变量 EBM (LVEBM) 是取决于 x、y 和 z 的参数化能量函数:\( E_w(x, y, z) \)。当出现一对 (x,y) 时,EBM 的推理过程会找到一个潜在变量 z 的值,它使能量最小化
$$ \v{z} = \argmin_{z \in Z}{E_w(x, y, z)} $$
这种通过最小化的潜变量推断允许我们从能量函数中消除 z:
$$ F_w(x, y) = \min_{z \in Z}{E_w(x, y, z)} = E_w(x, y, \v{z}) $$
3.1.3 Joint Embedding的优点

JEPA 的主要优点是它在表示空间中执行预测,避免了预测 y 的每个细节的需要,并且能够通过编码器消除不相关的细节。这在现代深度学习模型架构中非常常见,比如GPT-3,Flamingo。
3.2 JEPA的结构设计和训练
给定一个训练样本 (x, y),训练 EBM 归结为设计一个合适的损失函数\( L(x, y, F_w(x, y)) \),它可以直接表示为参数向量的函数\( L(x, y, w) \),并且最小化这种损失将使训练样本的能量\( F_w(x, y) \)低于任何不同于\( y \)的\( \hat{y} \)的能量\( F_w(x, \hat{y}) \)。
降低训练样本的能量很容易:损失是能量的增函数,并且能量具有下限就足够了。
困难的问题是如何确保与\( y \)不同的\( \hat{y} \)的能量高于\( y \)的能量。 如果没有具体规定来确保\( F_w(x, \hat{y}) > F_w(x, y) \)那么每个\( \hat{y} \neq y \)组成的能源格局可能会崩溃:给定输入\( x \),能源格局可能会变得“平坦”,有非常多的\( y \)具有相同的能量。这会使得能量函数非常难训练。
下面我们讨论哪些设计会导致“崩溃”,
3.2.1 能量模型的“崩溃”问题
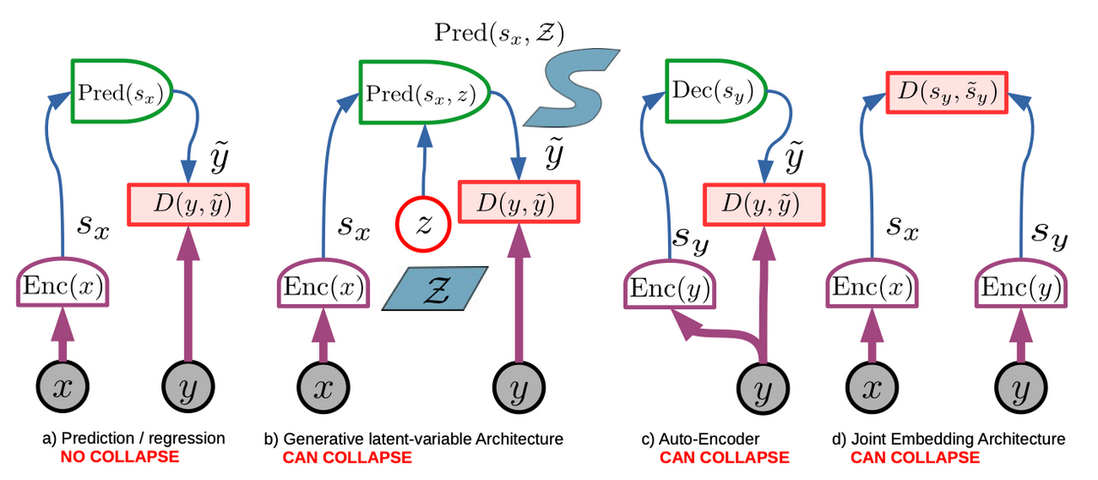
上图是四种常见的能量模型结构:
- 确定性生成架构:不能崩溃,因为它只能产生单个输出。 对于给定的 x,只有一个 y 值可能具有零能量:\( y = \tilde{y} \)。 当\( y \neq \tilde{y} \)时\( D(u, \tilde{y}) \)大于零,y 的其他值将具有更高的能量。
- 非确定性生成架构:当潜在变量具有过多的信息容量时,可能会崩溃。 如果对于给定的 x 和所有 y 存在产生零预测能量的 z(例如,如果 z 具有与 y 相同或更高的维度),则整个 y 空间将具有低能量。 z 的信息容量应该足够,以便在其集合上改变 z 将产生给定 x 的所有合理的\( \tilde{y} \)。简而言之,当z的信息熵超过y时,所有y都会是低能量。
- 自编码器:如果系统学习了恒等函数,或者如果它可以正确地重建一个比高数据密度区域大得多的 y 空间区域,则可能会崩溃,从而为过大的区域提供低能量。
- 简单联合嵌入架构:如果编码器忽略输入并产生保持恒定和相等的表示,或者如果编码器在空间的过宽区域上保持不变,则可能会崩溃。
JEPA是非确定性生成架构和简单联合嵌入架构的组合,因此JEPA也会面临“崩溃”。论文制定了四个标准避免崩溃:
- 最大化\( s_x \)关于\( x \)的信息量;
- 最大化\( s_y \)关于\( y \)的信息量;
- 使\( s_y \)容易从\( s_x \)预测;
- 最小化预测中使用的潜在变量\( z \)的信息内容。
标准 1 和 2 防止能量表面因信息崩溃而变得平坦。 他们确保\( s_x \)和\( s_y \)携带尽可能多的有关其输入的信息。 如果没有这些标准,系统可以选择使\( s_x \)和\( s_y \)保持不变,或者提供弱信息,这将使能量在输入空间的大范围内保持不变。
标准 3 由能量项\( D(s_y, \tilde{s}_y) \)强制执行,并确保 y 可从表示空间中的 x 预测。
标准 4 通过强制模型在尽可能少的潜变量帮助下预测\( s_y \)来防止系统成为另一种类型的信息崩溃的受害者。 这可以通过将 z 离散化,降低维度,稀疏化,加入噪声,或者其他方式实现。
3.2.2 训练能量模型
能量模型常见的有两种训练方法:(1)对比方法,和(2)正则方法。下图展示了两种方法,左侧显示了能源景观的概念图。 训练样本是蓝点。 低能量区域以橙色显示(能量函数的水平集)。
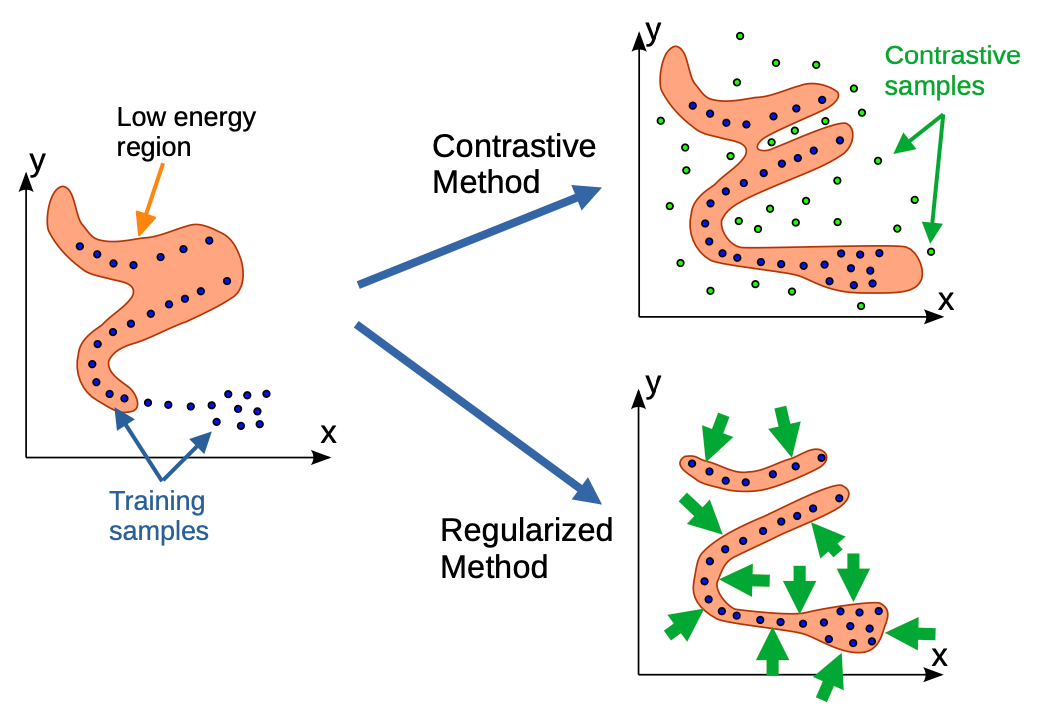
对比方法包括使用损失函数,其最小化具有下推训练样本\( (x, y) \)的能量的效果,并拉高适当幻觉的“对比”样本\( (x, \hat y) \)的能量。 应以确保 EBM 将更高的能量分配给高数据密度区域之外的点的方式选择对比样本\( \hat y \)。 这转化为设计一个损失函数,它是\( F_w(x, y) \)的递增函数和\( F_w(x, \hat y) \)的递减函数,至少当 \( F_w(x, \hat y) \)没有足够高于\( F_w(x, y) \)时 . 有很多这样的对比损失函数,其中一些采用单个三元组\( (x, y, \hat y) \),另一些则需要一批\( y \)的正值和对比值。
但是对比方法有两个主要问题。 首先,必须设计一个方案来生成或选择合适的\( \hat y \)。 其次,当\( y \)在高维空间时,如果 EBM 是灵活的,则可能需要非常大量的对比样本,以确保在未被局部数据分布占据的所有维度上能量更高。 由于维度灾难,在最坏的情况下,对比样本的数量可能会随着表示的维度呈指数增长。这就是Lecun反对对比方法的主要原因。
从长远来看,用于 EBM 训练的正则化方法比对比方法更有希望,因为它们可以避免困扰对比方法的维度灾难。它们包括构建一个损失函数,该函数具有下推训练样本能量的效果,同时最小化模型与低能量相关联的 y 空间的体积。低能量区域的体积通过能量和/或损失中的正则化项来测量。通过在降低数据点能量的同时最小化这个正则化项,低能量区域将“收缩包裹”高数据密度区域。非对比正则化方法的主要优点是它们比对比方法更不可能成为维度灾难的受害者。非对比方法已经存在了很长时间。示例包括稀疏建模、稀疏自动编码器和具有噪声潜在变量的自动编码器,例如 VAE。
3.2.3 训练JEPA
因为对比训练的缺陷,论文推荐使用一种叫做VICReg的方法训练,相比于对比学习单个数据,VICReg对一批次数据正则化后学习。
VICReg 方法 (Bardes et al., 2021) 对\( s_x \)和\( s_y \)的分布做了一些假设。结构表示如图所示。为了最大化\( s_x \)的信息内容,VICReg 使用以下两个子标准:(1)\( s_x \)的分量不能是恒定的,(2)\( s_x \)的分量必须与尽可能互相独立。这通过首先通过可训练的扩展模块(例如具有几层的神经网络)将\( s_x \)和\( s_y \)非线性映射到更高维的嵌入\( v_x \)和\( v_y \)来近似,并使用具有两个可微分损失项的损失函数在一个批次上计算:
- Variance: a hinge loss that maintains the standard deviation of each component of \( s_y \) and \( v_y \) above a threshold over a batch.
- Covariance: a covariance loss in which the covariance between pairs of different components of \( v_y \) are pushed towards zero. This has the effect of decorrelating the components of \( v_y \), which will in turn make the components of \( s_y \) somewhat indepen-
dent.
对比方法确保批次中不同输入的表示不同,VICReg 确保批次中表示的不同组件是不同的。 VICReg是对分量进行对比,而传统的对比方法是对向量进行对比,需要大量的对比样本。
3.3 H-JEPA

JEPA 学习抽象表示的能力可以进行准确的预测,从而允许分层堆叠。 在此图中,JEPA-1 提取低级表示并执行短期预测。 JEPA-2 将 JEPA-1 提取的表示作为输入,并提取可以执行长期预测的更高级别的表示。 更抽象的表示忽略了难以长期预测的输入细节,使它们能够通过对世界状态的更粗略描述来执行长期预测。H-JEPA具有分层抽象的能力。
讨论
欢迎评论!
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论