vLLM 前缀缓存压测:首 token 变快之前,先分清排队和预填充
文章目录
vLLM 的自动前缀缓存会复用相同前缀上已经计算的 KV,适合共享长系统提示或重复分析同一文档。收益主要在输入预填充阶段。排队仍受调度、并发和显存水位影响;长输出仍要逐步解码。所以观察整个服务的 P95 时,需要同时验证请求确实命中,而且缓存保留没有挤压其他负载。
让两组流量只差前缀复用机会
固定模型、tokenizer、并发、到达节奏和输出长度,分别构造「长前缀一致,只变末尾任务」与「相同输入长度,前缀各不相同」两组。对缓存开启和关闭都跑这两种流量,标清冷启动及热身后的统计区间。请求若被随机分给独立 worker,局部缓存命中率可能远低于单机压测;路由本身也是一个要单独控制的变量。
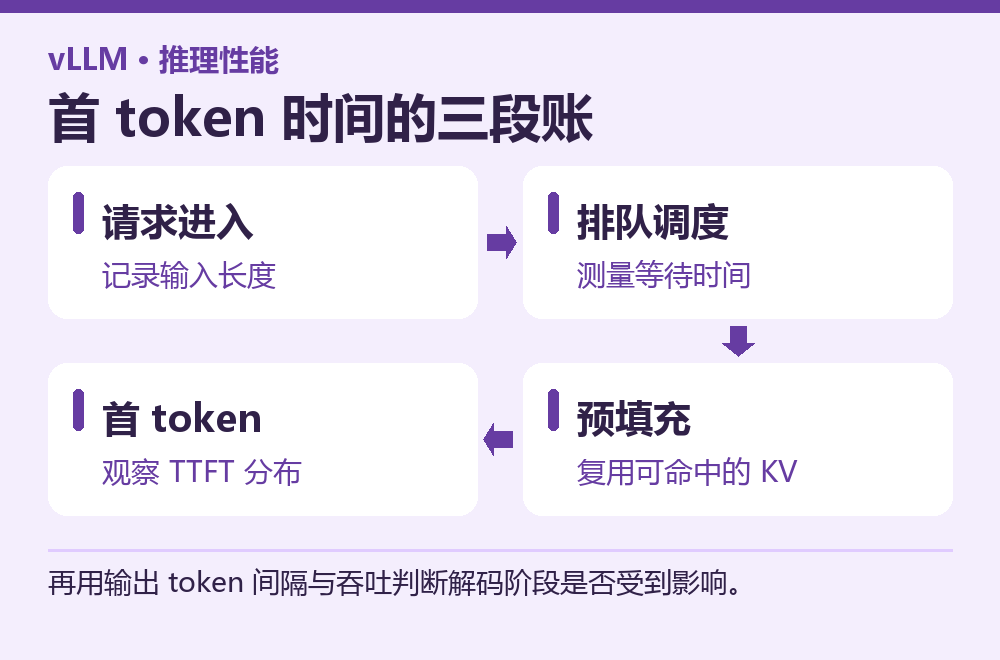
再用输出 token 间隔与吞吐判断解码阶段是否受到影响。
数据组  固定长前缀 / 随机等长前缀 / 真实流量回放
观测项  TTFT、排队时间、预填充时间、输出 token 间隔、缓存利用率
记录项  模型、引擎版本、并发、输入长度分桶、GPU 显存预算
命中率高而 TTFT 仍差时怎么查
将按请求统计的首 token 指标按输入长度和并发拆分,再对照缓存计数和排队指标。前缀稳定后命中改善、预填充下降,说明复用起效。此时若排队仍高,检查执行队列、批调度或显存压力。热请求改善而冷请求超时,可按请求类别设置观察指标或容量保护。若业务每次把随机 ID、时间戳插到系统指令前部,后续相同文档也无法形成同样的长公共前缀;先将会变化的内容放到语义允许的后部,再复测。
多租户环境要明确共享范围
不要为了提高命中率把不同权限范围的内容合成同一共享模板。决定哪些前缀来自全站公共规则,哪些属于租户或用户数据,并使用当前部署版本支持的隔离机制。在目标负载下加入低命中流量作对照,监控 P95 TTFT、超时率和输出吞吐,避免只优化少数重复提示。容量规划用稳定吞吐和尾延迟决定 worker 数量。
用两个假想结果判断瓶颈
热组的预填充时间下降、输出 token 间隔基本持平,符合复用输入 KV 的预期。如果热组显存利用率上升且冷组 P99 超时变多,就要检查热前缀是否挤占冷请求所需的块,或路由是否把所有长请求送到单节点。再将负载拆为长输入短输出与短输入长输出,对照各自吞吐。把两种请求只报一个总平均,会掩盖其中一类客户的退化。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论