airllm · 为低显存设计的模型推理
推理时按层调入模型权重,减少需要同时驻留在显存的数据量。
lyogavin/airllm ↗GitHub 数据采集于 2026年11月19日,以仓库当前信息为准。
为什么推荐
项目简介
推理时按层调入模型权重,减少需要同时驻留在显存的数据量。适合在显存有限的设备上做推理实验。
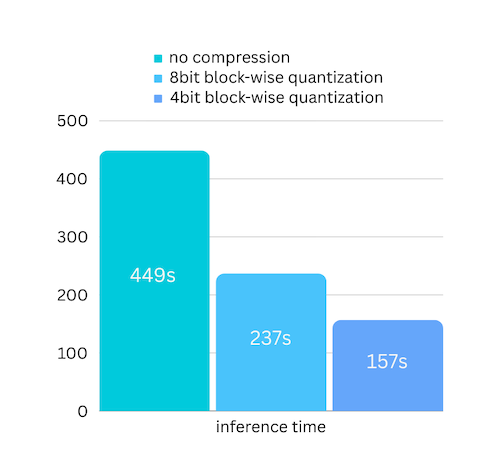
配图:项目仓库原图 · Apache-2.0

入门练习
这次练习的目标是在显存受限环境观察按层加载的推理取舍。沿着下面的实际操作走完一轮,可以判断项目解决了哪段工作、需要怎样的运行条件,以及发生异常时能否回到已验证的状态。按层载入会在磁盘、内存和加速器间交换权重。只看显存不足以解释生成为什么花费较多时间。
准备环境和样本
核对 AirLLM 支持的后端、模型和存储空间,选有使用许可的小模型。本次试用材料包括同一段短输入、一个固定输出上限和两种可比较的加载条件。建议保留一份起始状态,方便确认后续的变化。
从项目文档确认运行方式和当前版本支持的模型或后端。先把目标写成一次能由人工复核的短任务,确定哪些输入可以交给所选运行环境、哪些需要留在本地。测试时保留使用的版本、模型设置、输入范围与时间限制,使后续结果有可比较的基础。涉及远程服务时,同时了解可能使用的额度和数据处理位置。
操作步骤
- 按照官方最小示例加载模型,记录初次准备时间。
- 生成短结果,并观察内存、显存和读盘。
- 区分每轮首个输出与后续输出速度。
- 只改变一个配置,再比较延迟与稳定性。
准备带有明确预期的短输入,从最小配置跑通一次,再只改变一个条件。通过对比具体输出与过程状态判断变化发生在哪一步。若某个结果通过自动生成获得,安排一个能人工核对的环节,并记录无法确认的部分。选取质量要求不同的两组样本,也能帮助区分功能是否可用与它是否适合预期用途。
验收结果
完成上面的练习后,可以按这组具体表现判定是否跑通。可以复现推理输出和资源数据,能够解释显存节省对应的时间代价。把可以确认的结果和仍需查证的现象记成两栏,后续更换样本或升级版本时可用这份记录复查。
根据实际使用场景同时观察结果质量和完成一次任务的成本。可以记录等待时间、错误提示、资源消耗及需要人工修改的内容,再用相同输入复测。遇到看似成功的输出,仍应查看它有没有省略关键条件、误用术语或遗漏步骤。对硬件和模型结果的估算,可以通过独立实测找出偏差来自何处。
问题排查
内存不足先查总内存、加速器和分片;权重缓存与推理长度会影响速度。
当结果出现偏差时,检查输入是否完整、运行环境是否载入必要资源、任务是否超过已知能力范围。依次更换一个条件并重跑,避免把多项变化叠加后的结果归因给单一原因。项目文档、日志和实际产物各能提供不同线索;按复现流程整理证据,比只保存最终生成内容更方便后续核对。
下一次可以试什么
为计划应用分别测冷启动、短问答和较长输入,确认是否满足实际交互需求。
投入长期工作前,可为每种常用输入准备少量可追溯的验收样本,并明确谁检查结果、谁批准后续操作。对模型、工具和运行参数的变化分别留记录,若某一轮效果下降,可以复用一份已知语料进行归因。引入更多并发、更长的输入或更大的模型前,先确认最小用例能稳定复现。
项目链接
由社区成员推荐收录。 · 2026年11月19日
访问 GitHub ↗