HelloWorld 开发者社区
科技资讯

百度世界提出智能组织思路,关注 AI 从个人工具进入业务闭环
openKylin 全球生态推广会举行,推进本地化与社区合作
光船 1.1.0 尝鲜版二更新,探索 AI 会话与代码生成结合
Argus 0.5.0 发布:新增进程控制,完善原生 Windows 任务管理
MetaForge 2026.0.0 发布,整合数据库工作台与可视化分析
qData 1.6.7 发布:修复增量读取与 ETL 字段传递问题
Apple HomeView 在部分地区开售,整合家庭控制与视频通话
Cloudflare 推出 Spend Management Beta,为 Workers 增加支出限制
Cloudflare 开源 Kitesurf:面向 AI 智能体的轻量浏览器引擎
JeecgBoot 与敲敲云介绍分层方案,连接低代码开发与业务搭建
开源项目
全部项目推荐好文
Python笔记:用read_html()来抓取table格式的网页数据
read\_html()的基本语法及其参数:pandas.read_html(io,match'.',flavorNone,headerNone,index_colNone,skiprowsNone,attrsNone,parse_datesFalse,thousands',',encodingNone,
Python 使用selenium抓取网页文本和下载音频
Python使用selenium抓取网页文本和下载音频!\usr\bin\envpythoncoding:utf8'一个自动从https://podcast.duolingo.com/spanish中下载音频并且爬取文本的程序''需要配置下载以下所需库,并且配置好webdriv
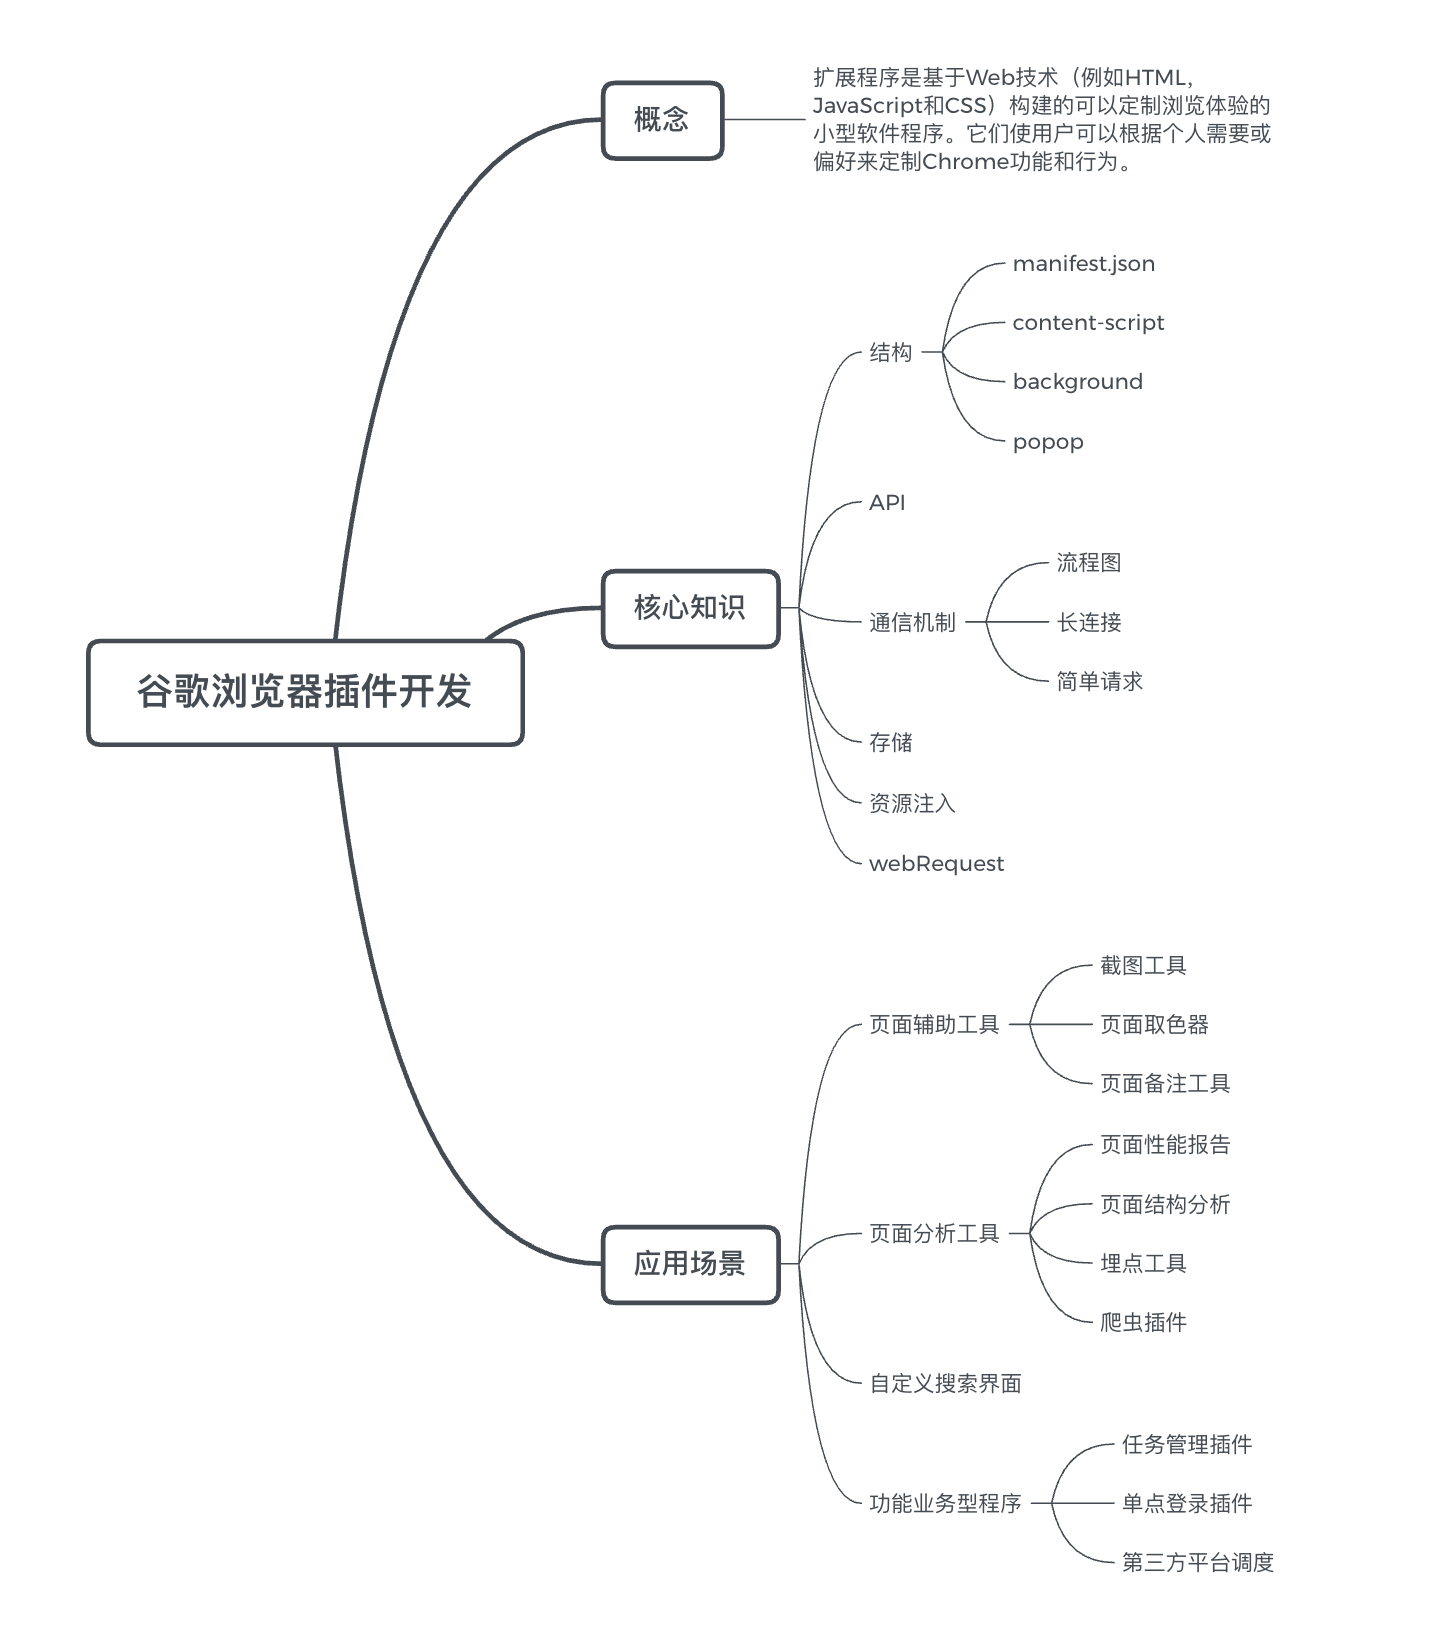
30分钟开发一款抓取网站图片资源的浏览器插件
前言由于业务需求,笔者要为公司开发几款实用的浏览器插件,所以大致花了一天的时间,看完了谷歌浏览器插件开发文档,在这里特地总结一下经验,并通过一个实际案例来复盘插件开发的流程和注意事项.你将收获如何快速上手浏览器插件开发浏览器插件开发的核心概念浏览器插件的通信机制浏览器插件的数据存储浏览器插件的应用场景开发一款抓取网站图片资源
golang 抓取网页并将其他编码(gbk,gb2312,big5等)中文文字转换成uft8编码的字符串处理函数
最近用golang采集网页中遇到了各种不能识别的的乱码字符串,他们大多编码是gbk、gb2312、big5、windows1252等编码。有时候,网页上并没有声明编码,却使用上面这种编码的网页也有,也有网页声明的编码和实际使用的编码不同的网页,导致网页编码转换工作带来诸多不便,更多的是根据提示的
node.js 抓取网页内容(针对微信小程序云开发)
最近在研究微信小程序的云开发功能。云开发最大的好处就是不需要前端搭建服务器,可以使用云端能力,从零开始写出来一个能上线的微信小程序,避免了买服务器的开销,对于个人来尝试练手微信小程序从前端到后台的开发,还是一个不错的选择。可以做到一天就能上线一个微信小程序。云开发的优点云开发为开发
快速制作规则及获取规则提取器API
!图片描述(/img/bVEFvL?w300&h300)1.引言前面文章的测试案例都用到了集搜客Gooseeker提供的规则提取器,在网页抓取工作中,调试正则表达式或者XPath都是特别繁琐的,耗时耗力,工作枯燥,如果有一个工具可以快速生成规则,而且可以可视化的
为采集动态网页安装和测试Python Selenium库
!图片描述(/img/bVEFuD?w512&h512)1.引言上一篇《为编写网络爬虫程序安装Python3.5(https://segmentfault.com/a/1190000007033950)》中测试小例子对静态网页做了一个简单的采集程序,而动态网
为编写网络爬虫程序安装Python3.5
!图片描述(/img/bVDF0n?w480&h260)1.下载Python3.5.1安装包1.1进入python官网,点击menu>downloads,网址:DownloadPython(https://link.segmentfault.co
已经看完全部文章
已加载文章中没有匹配内容,可继续加载更多。