HelloWorld 开发者社区
科技资讯

百度世界提出智能组织思路,关注 AI 从个人工具进入业务闭环
openKylin 全球生态推广会举行,推进本地化与社区合作
光船 1.1.0 尝鲜版二更新,探索 AI 会话与代码生成结合
Argus 0.5.0 发布:新增进程控制,完善原生 Windows 任务管理
MetaForge 2026.0.0 发布,整合数据库工作台与可视化分析
qData 1.6.7 发布:修复增量读取与 ETL 字段传递问题
Apple HomeView 在部分地区开售,整合家庭控制与视频通话
Cloudflare 推出 Spend Management Beta,为 Workers 增加支出限制
Cloudflare 开源 Kitesurf:面向 AI 智能体的轻量浏览器引擎
JeecgBoot 与敲敲云介绍分层方案,连接低代码开发与业务搭建
开源项目
全部项目推荐好文
10年前,我就用 SQL注入漏洞黑了学校网站
我是风筝,公众号「古时的风筝」,一个兼具深度与广度的程序员鼓励师,一个本打算写诗却写起了代码的田园码农!文章会收录在JavaNewBee(https://www.oschina.net/action/GoToLink?urlhttps%3A%2F%2Fgithub.com%2Fhuzhicheng%2FJavaNewBee)中,更有Java
30分钟轻松在华为云上搭建网站应用(零基础手把手教学)
30分钟轻松搭建网站应用华为云(https://www.oschina.net/action/GoToLink?urlhttps%3A%2F%2Flab.huaweicloud.com%2Ftestdetail.html%3FtestId%3D236)
java处理高并发高负载类网站的优化方法
一:高并发高负载类网站关注点之数据库没错,首先是数据库,这是大多数应用所面临的首个SPOF。尤其是Web2.0的应用,数据库的响应是首先要解决的。一般来说MySQL是最常用的,可能最初是一个mysql主机,当数据增加到100万以上,那么,MySQL的效能急剧下降。常用的优化措施是MS(主从)方式进行同步复制,将查询和操作和分别在不同的
手把手教你用Scrapy爬虫框架爬取食品论坛数据并存入数据库
大家好,我是杯酒先生,这是我第一次写这种分享项目的文章,可能很水,很不全面,而且肯定存在说错的地方,希望大家可以评论里加以指点,不胜感激!一、前言网络爬虫(又称为网页蜘蛛,网络机器人),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。另外一些不常使用的名字还有蚂蚁、自动索引、模拟程序或者蠕虫。百度百科 说人话就是,爬虫是用来海量规则化获取数据
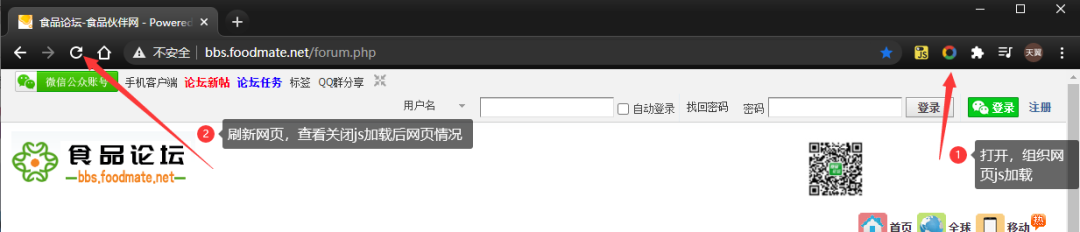
手把手教你用Scrapy爬虫框架爬取食品论坛数据并存入数据库
大家好,我是杯酒先生,这是我第一次写这种分享项目的文章,可能很水,很不全面,而且肯定存在说错的地方,希望大家可以评论里加以指点,不胜感激!一、前言网络爬虫(又称为网页蜘蛛,网络机器人),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。另外一些不常使用的名字还有蚂蚁、自动索引、模拟程序或者蠕虫。百度百科 说人话就是,爬虫是用来海量规则化获取数据
已经看完全部文章
已加载文章中没有匹配内容,可继续加载更多。