文章
使用Scrapy网络爬虫框架小试牛刀
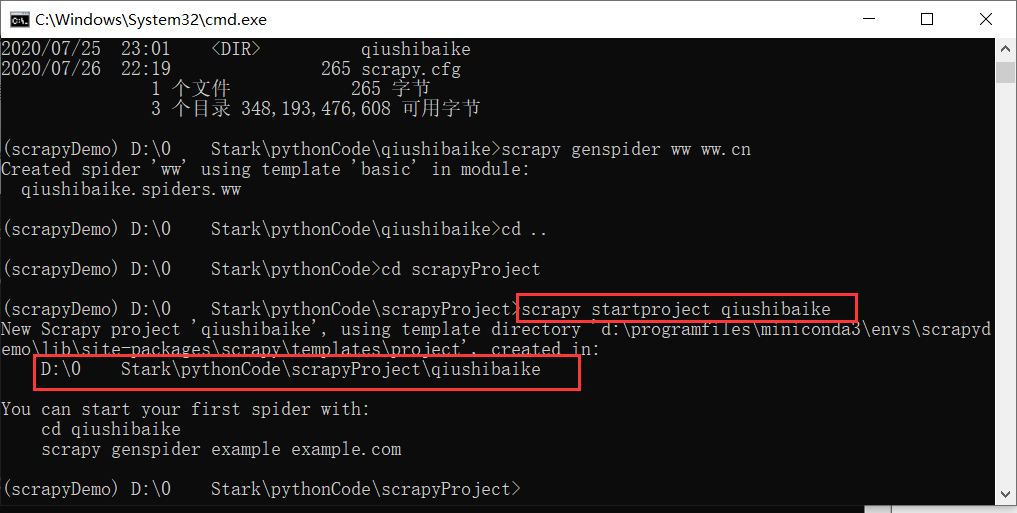
前言这次咱们来玩一个在Python中很牛叉的爬虫框架——Scrapy。scrapy介绍标准介绍Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架,非常出名,非常强悍。所谓的框架就是一个已经被集成了各种功能(高性能异步下载,队列,分布式,解析,持久化等)的具有很强通用性的项目模板。对于框架的学习,重点是要学习其框架的特性、各个功能的
纯干货:手把手教你用Python做数据可视化(附代码)
前言Hi,大家好,又见面了,我是Python进阶者,废话不多说,直接开始肝吧,奥里给!爬虫管理效果图依赖包文件:requirements.txt文件的内容这里直接贴出来了:appdirs1.4.4APScheduler3.5.1attrs20.1.0Automat20.2.0beautifulsoup44.9.1certifi202
手把手教你用Scrapy爬虫框架爬取食品论坛数据并存入数据库
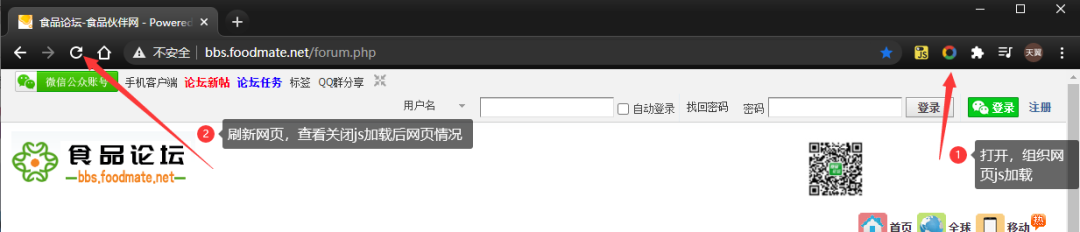
大家好,我是杯酒先生,这是我第一次写这种分享项目的文章,可能很水,很不全面,而且肯定存在说错的地方,希望大家可以评论里加以指点,不胜感激!一、前言网络爬虫(又称为网页蜘蛛,网络机器人),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。另外一些不常使用的名字还有蚂蚁、自动索引、模拟程序或者蠕虫。百度百科 说人话就是,爬虫是用来海量规则化获取数据
手把手教你用Scrapy爬虫框架爬取食品论坛数据并存入数据库
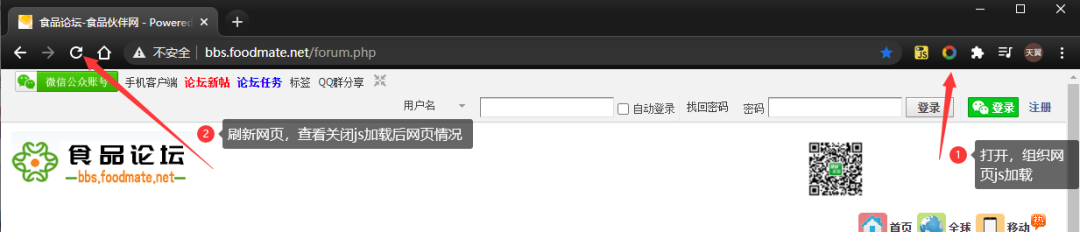
大家好,我是杯酒先生,这是我第一次写这种分享项目的文章,可能很水,很不全面,而且肯定存在说错的地方,希望大家可以评论里加以指点,不胜感激!一、前言网络爬虫(又称为网页蜘蛛,网络机器人),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。另外一些不常使用的名字还有蚂蚁、自动索引、模拟程序或者蠕虫。百度百科 说人话就是,爬虫是用来海量规则化获取数据
《Python3网络爬虫开发实战》
提取码:1028内容简介······本书介绍了如何利用Python3开发网络爬虫,书中首先介绍了环境配置和基础知识,然后讨论了urllib、requests、正则表达式、BeautifulSoup、XPath、pyquery、数据存储、Ajax数据爬取等内容,接着通过多个案例介绍了不同场景下如何实现数据爬取,后介绍了pyspider框架、S
Domain Admin:基于Python + Vue.js 技术栈实现的域名SSL证书监测平台
DomainAdmin基于PythonVue.js技术栈实现的域名SSL证书监测平台用于解决,不同业务域名SSL证书,申请自不同的平台,到期后不能及时收到通知,导致线上访问异常,被老板责骂的问题运行环境:Python3.7.0安装<pre<cod
介绍一款能取代 Scrapy 的爬虫框架 - feapder
1.前言大家好,我是安果!众所周知,Python最流行的爬虫框架是Scrapy,它主要用于爬取网站结构性数据今天推荐一款更加简单、轻量级,且功能强大的爬虫框架:feapder项目地址:https://github.com/Boriscode...(https
从零搭建 Redis-Scrapy 分布式爬⾍
!在这里插入图片描述(https://imghelloworld.osscnbeijing.aliyuncs.com/imgs/c9aa034c544bca65f39eff60e04075d0.png)一、ScrapyRedis分布式策略假设我有四台电脑:Windo
Scrapy 豆瓣搜索页爬虫
Scrapy豆瓣搜索页爬虫使用scrapy爬虫框架对豆瓣图书搜索结果进行爬取ScrapyScrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架可以应用在包括数据挖掘,信息处理或存储历史数据等一系列的程序它提供了多种类型爬虫的基类,如BaseSpi
36、利用开源的scrapy-redis编写分布式爬虫代码
【百度云搜索,搜各种资料:http://www.lqkweb.com(https://link.segmentfault.com/?encX8xDMysp7Ux6sdKMSei6xg%3D%3D.7EpuJy5a9uAl5V5Efpb57IiXs%2Ff1JzumiNHl5uTQp
已加载文章中没有匹配内容,试试其他关键词或清空搜索。