Go 1.27 换 JSON 解码器:两个请求都返回 200,哪个读对了?
文章目录
假设一个搜索接口约定 limit 缺省时返回二十条,显式写成 0 时关闭分页。某天团队更新 JSON 解码器,监控里的成功率一切正常,却有一批调用突然拿到了默认值。用结构体编码出来的测试报文都通过。后来从客户端的实际序列化路径排查,才发现有的旧请求用的是 Limit,有的中间件还会拼出两个同名字段。
这是一个用来讲迁移的例子。Go 1.27 的 encoding/json 已由新版实现驱动,同时保留 v1 的编解码语义。独立采用 encoding/json/v2 才会引入另一套默认行为,例如拒绝重复成员名、对结构体名称更严格地匹配。工具链先升,接口逐个迁,出了问题就能缩小到明确的一处改动。
样本必须长得像真的请求
测试习惯先构造结构体,再用 Marshal 生成请求。这样的生成器不会替你造出本来就不该有的字段。先用原始字节列一张对照表,尤其留意两边都能解码但解码结果不同的请求。
| 原始报文 | 核对项 |
|---|---|
| ’{}’ | 缺省值在什么地方应用 |
| ’{“limit”:0}’ | 显式零值是否保留 |
| ’{“Limit”:5}’ | 字段是否匹配,还是作为未知项被跳过 |
| ’{“limit”:10,“limit”:100}’ | 是否接受,如果接受取的是什么 |
| ’{“limit”:null}’ | 合同是否允许把 null 与缺省合并 |
大写字段最容易漏。若解码选择默认忽略未知字段,Limit 不匹配仍可能返回成功,最终走缺省值。只监控错误率的话,这条链路完全隐身。示例里用指针记录是否看见非 null 的值。如果接口要区分 null 和缺省,还需要显式记录字段存在状态,不能把两种情况都映射成 nil。
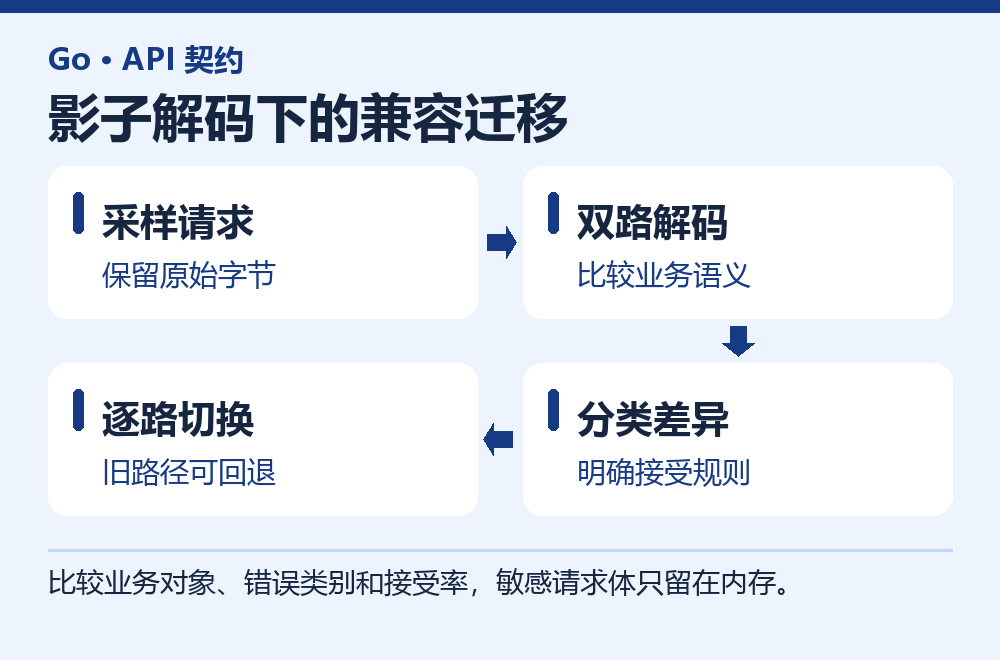
比较业务对象、错误类别和接受率,敏感请求体只留在内存。
一次解码真正生效,另一次留作比对
下面的函数只关心这例中的一个标量字段。实际服务做请求采样时,应让主路由按既有流程解析并执行业务,影子路径只返回分类结果。用 Go 1.27 编译。
import (
    v1 "encoding/json"
    v2 "encoding/json/v2"
)

type SearchInput struct {
    Limit *int `json:"limit"`
}

func compare(raw []byte) string {
    var old, next SearchInput
    ea := v1.Unmarshal(raw, &old)
    eb := v2.Unmarshal(raw, &next)
    switch {
    case ea != nil && eb != nil:
        return "both_invalid"
    case ea != nil:
        return "v2_only"
    case eb != nil:
        return "v1_only"
    case old.Limit == nil && next.Limit == nil:
        return "same"
    case old.Limit != nil && next.Limit != nil && *old.Limit == *next.Limit:
        return "same"
    default:
        return "different"
    }
}
读请求体要继续遵循接口已有的大小限制。不要在日志里写完整请求或字段值,路由、调用方版本和差异分类就足够看趋势。如果这条链路有签名,用原始字节做校验,并将影子解码放在合适的认证边界内。尤其别把两个解析结果各自送进业务逻辑,否则一次搜索也许仍然无害,换成扣款就会出问题。
把兼容条款写进能被执行的测试
影子数据告诉你流量里发生过什么,未出现不代表允许带过去。团队还得决定接口究竟承诺什么。针对示例搜索路由,明确缺省取二十、零值关闭分页、负数返回客户端错误、重复成员拒绝。把这些写成用原始 JSON 字节喂给处理器的表驱动测试。运行时同一个测试要覆盖默认值生效和真实查询选项,不要只断言内部解析结构。大小写临时保留的条款也要测,给它命名并注明老 SDK 的最后支持日期。SDK 升级完成后,删除兼容分支时测试就知道为什么改变。
错误演练可以对比两条看似接近的报文。’{“limit”:“10”}’ 是类型错误,’{“limit”:-1}’ 可能通过解码,却属于业务范围错误。如果应用将两个都转成统一的 400,内部监控仍可使用不同稳定类别。一旦灰度期间出现「类型错误」突然上升、有接受状态改变,能很快缩小客户端来源。新版库错误字符串的措辞偶尔会变,轮值的人应该从应用错误类别找到对应的修复说明。
对响应输出另留两个原始样本,例如空搜索结果、未填写的可选字段。写对照时首先读 HTTP 状态、内容类型和关键字段,再看需要保持的空数组语义与默认值。比较响应字节适合明确对字节签名或稳定输出的协议。其他前端往往关心 JSON 语义,键顺序变化不应该让迁移卡死。输入与输出有各自的用户群、风险和开关,混在一次发布里不会让流程更快。
若升级端本身受到第三方回调约束,拿一条只有未知字段的回调单独测试。未知字段究竟忽略还是拒绝,可能关系到对方日后扩展能否兼容。服务可以安排不同端点各自采用允许的策略,再把文档与测试配对。对整个站点直接使用一份全局设置,一旦遇到兼容例外,很容易临时打开更大的输入范围。
灰度时先解决「看起来都成功」的差异
假设前一天抽了十万条请求,二十条来自同一个旧 SDK,全部是大写字段。看比例很低,按调用方聚合却是某个客户端覆盖率百分之百。可以先更新 SDK,等旧版调用量退下去再切。如果合同原来明文接受大小写变体,就先保留兼容,记录该路由的规则以及去掉规则的时间。这与含重复键一次请求到底该取哪个值是两类选择,后者应该在公开输入协议中给出单一规则。
工具链升级前后另外回归常见错误的状态码和对外错误字符串。内部测试宜断言错误类型或应用自己的错误码,避免整个套件依赖实现细节。服务端编码也另跑一遍响应语料,比如 null 和空数组。等请求解码走通以后再考虑响应 JSON,客户端受影响的范围会清楚很多。
上线开关放在路由里。若灰度发现请求接受率持续下降,或业务对象差异超过事先约定的范围,先退回旧解析路径,再核对调用端。一个写得清楚的迁移说明,应该能拿出一条请求,解释它过去算哪种输入、今后算哪种输入,以及为什么。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论