Kubernetes 明明还有两张空闲 GPU,Pod 为什么一直 Pending?
文章目录
管理员看见监控上还有两张空闲卡,推理 Pod 却挂在 Pending。临时把副本投到另一个节点后,又出现了已调度但容器不启动。前者可能是声明找不到符合条件的设备,后者可能是节点驱动没把设备准备好。若告警只有「GPU 不足」,值班人员会先在错误的一侧加节点。
Kubernetes 1.37 继续扩充 DRA(动态资源分配)。这里用一条推理业务的设备声明举例,按供给、声明、调度和节点准备推进。驱动和 API 的可用范围看集群版本与设备厂商实现。例子中的命名都只是为了演练定位。
空闲配额、设备属性、节点条件,各查一遍
DRA 驱动把设备与属性公布到 ResourceSlice。团队可以通过 DeviceClass 界定候选设备,把具体工作负载要求写进 ResourceClaim。假设资源池公布六张卡,其中两张空闲,只有更小显存的型号。推理声明要求另一类别,自然找不到匹配。反过来,有合适设备但已分配给其它 Claim,监控仍可能因为该应用尚未用算力而看起来空闲。GPU 利用率看的是计算,分配对象看的是谁有权用它。
把 Pod 的 Claim 引用、命名空间、所属设备类连起来核对。读取必要信息可以从下面四类对象开始,实际部署还要看驱动对设备的命名方式。
kubectl -n inference describe pod inference-worker
kubectl -n inference get resourceclaims -o wide
kubectl get deviceclasses
kubectl get resourceslices
如果 Claim 没有分配结果,先看事件写的是找不到类别、筛选条件不匹配,还是设备被其他 Pod 占用。查到匹配的 ResourceSlice 后,核对所属节点以及节点亲和性与污点。设备可用还要求 Pod 可以使用那个节点。如果 Claim 有分配,Pod 也指向节点,但容器停在等待,才进一步查 Kubelet、节点驱动准备阶段的事件和日志。要查到具体设备和节点,而不仅是 Pod 标签。
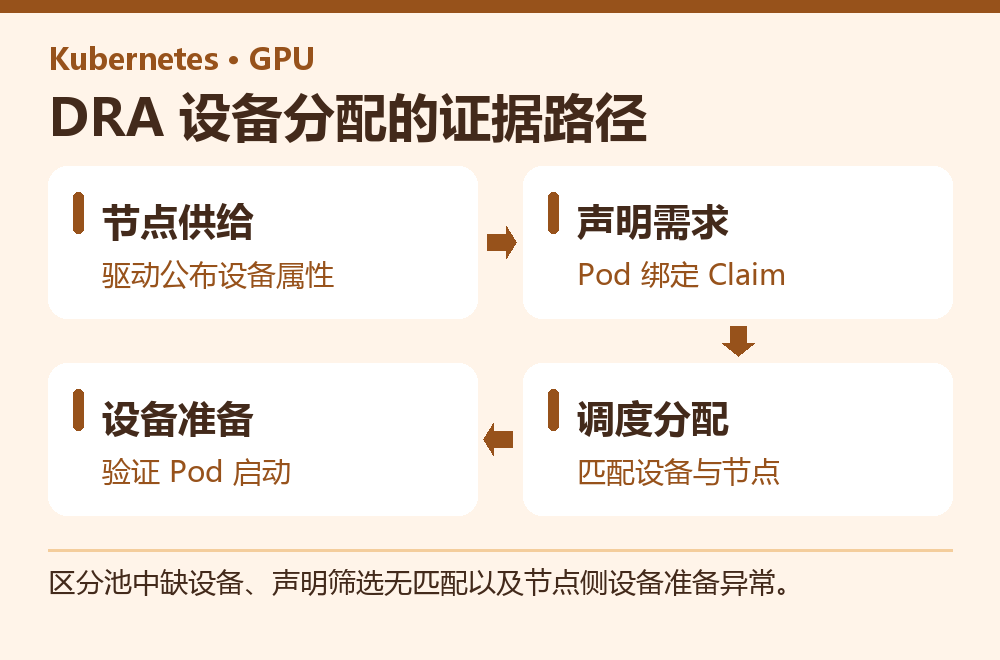
区分池中缺设备、声明筛选无匹配以及节点侧设备准备异常。
用两场资源演练验证发布窗口
第一场是竞争。在测试池给两个工作负载相同类别,但可用设备只够其中一个。观察先到者的资源何时获得,等待者拿到什么事件,以及释放后多久重新调度。若声明由模板随 Pod 创建,验证删除这一 Pod 后其声明如何清理。长期独立声明有另外的生命周期,不能指望删掉消费者就自动释放。
第二场是维护,把一台已承接测试推理的节点有序排空。看另外的节点是否真有同类设备,Pod 从等待、分配、节点准备到健康的耗时。可在演练表上记四个时刻:申请出现、Claim 分配、Pod 调度、主容器就绪。等了七分钟,前六分钟都没有分配,改镜像拉取不会解决;分配半秒完成,节点最后迟迟未就绪,此时再去查驱动和容器。若有训练任务与在线推理共享池,两者先约定不同的等待目标和优先级,避免普通训练队列等待触发在线业务告警。
一条跨团队问题,怎样从对象一路追过去
可以把试点记录做成一份按时间有原始证据的表。09:02 创建三个推理副本,两个立即得到 Claim 分配,第三个重复出现设备约束不匹配。现有池里另一台节点只有需要维护的设备,资源清单仍显示可调度。先核对设备驱动发布资源是否有延迟,随后看设备健康信息、节点标记和资源对象更新时间。若调度器确实没有符合条件的设备,扩容策略应建立新的同类容量,或者按业务标准调整要求。新的硬件到位后仍不启动,则另开节点准备的排查线路。记录到 Pod UID、Claim 名称与节点名,就能让调度与设备两个团队检查同一次尝试。
为发布验收保留一条负向测试。把声明改成一个测试池明确不存在的设备条件,确认它保持等待并给出可读的原因,而没有不声不响拿到其他型号。再让两个副本争同一设备,验证释放后下一请求是否接手。对于模型需要专属设备、能否切分资源等语义,要检查部署的驱动与设备类型说明,不能用 SKU 型号或一个可空闲指标替代服务条件。
试点真正进入在线业务前,还需要确认冒烟请求跑通实际 GPU 推理。容器就绪探针只验证端口的情况很常见,模型可能仍在下载或加载。让最小业务请求跟在「设备准备完成」记录之后,就可以区分调度成功和服务可用。
还需保留一份新旧容量水位。如果把旧设备池缩到只够当前流量,回退的瞬间可能无法承接刚移走的副本。先按最小可用业务量保有一些回迁容量,再决定多大比例进入新池。GPU 型号不同或新旧组件驱动要求不同时,让同一张小样本业务集在两端都完成推理与结果校验。
迁移时把设备池隔开
已有设备插件也可能暴露同一块物理卡。新驱动与旧插件并存时,按厂商说明检查两条路径是否能看到同一资源,别让两个机制各自认为可以分配。选一小组已隔离的节点试点,保留旧工作负载清单和容量。常驻服务可先从一个无状态副本试迁;训练任务要确认 checkpoint 能恢复到旧配置。测试变更包括驱动版本、设备类条件和工作负载模板,而不是一次同时换掉三套设置。
试点收尾时,给值班人员一张依赖实际对象的排查图:有无 Claim,Claim 有无分配,分配落在哪个节点,节点有没有准备完成。下次面对「还有卡却没启动」的工单,这条链更容易变成一项可处理的故障。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论