同样的 5xx 查询,为什么 DuckDB 能跳过这份 Parquet?
文章目录
同一份日志查出同一个错误率,凌晨跑十二秒,到了白天要四十秒。有人想把 Parquet 再压一遍,也有人要加机器。先问三个更便宜的问题:查询打开了哪些文件,文件里的哪些行组可以跳过,又读了几列?这三个问题的答案不一定在同一层。
DuckDB 的 Parquet 扫描支持投影和过滤下推。投影意味着扫描算子只读取查询需要的列。过滤下推进去以后,行组统计有时能让整组跳过。能下推只是执行计划的性质,实际跳不跳得掉,还要看文件怎么写。下面用本地造的两份文件呈现这一差别。样本只用于演示,不给出通用提速数字。
给同样数据换一次摆放位置
在一个空目录运行以下 SQL。行为完全相同的一百万行分别写进两个文件。permuted 用取模调换顺序,使稀少的错误记录分散。sorted 把错误状态聚集起来。这样比较时不必从真实系统搬日志。
CREATE TABLE events AS
SELECT i AS id,
       '/api/' || (i % 20)::VARCHAR AS route,
       CASE WHEN i % 997 = 0 THEN 503 ELSE 200 END AS status,
       repeat('x', 512) AS payload
FROM range(1000000) AS source(i);

COPY (SELECT * FROM events ORDER BY (id * 707) % 1000000)
TO 'permuted.parquet' (FORMAT PARQUET, ROW_GROUP_SIZE 32768);

COPY (SELECT * FROM events ORDER BY status, id)
TO 'sorted.parquet' (FORMAT PARQUET, ROW_GROUP_SIZE 32768);

EXPLAIN ANALYZE
SELECT route, count(*)
FROM read_parquet('sorted.parquet')
WHERE status >= 500
GROUP BY route;
换成 permuted.parquet 再跑一次,确认按 route 的结果一致。查看 parquet_metadata 每个状态列块的 min/max,比较最大值小于 500 的行组数。仅有一个 503,整组的最大值就可能是 503,扫描器无法直接排除那组。两份文件都能把条件下推,但聚集后的行组更容易跳过,其余列读得少、解码的行也可能少。示例里的 payload 高度可压缩,目的是解释列投影,不能用该大小推断真实业务的下载字节。
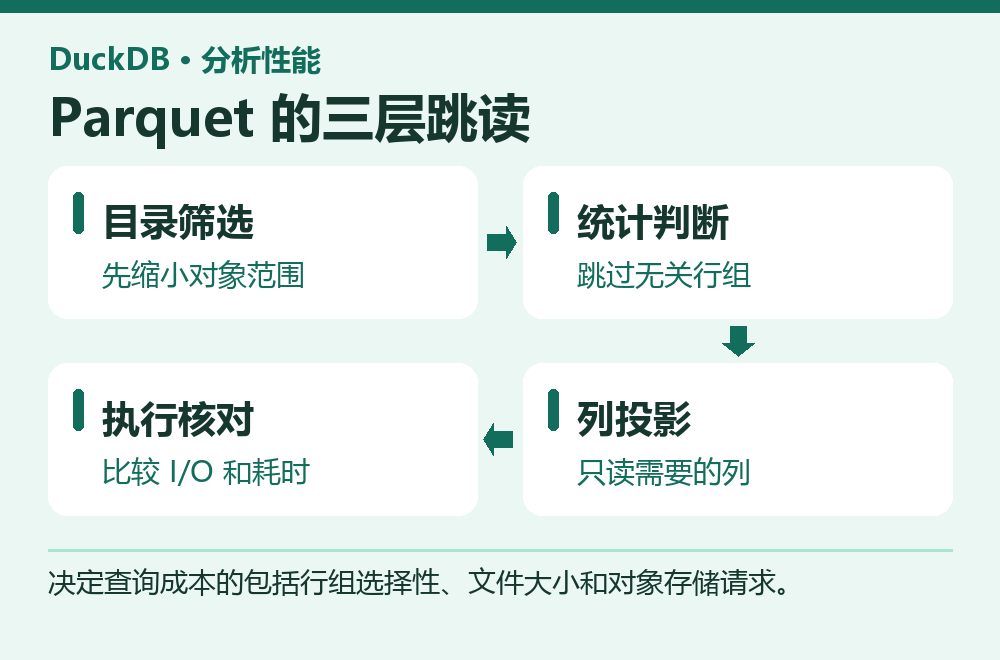
决定查询成本的包括行组选择性、文件大小和对象存储请求。
用元数据把「跳过了多少」亲手数出来
同一个过滤在两份文件上都成功下推,但计划如果只给你一个过滤表达式,肉眼还看不出它用了多少行组。从 Parquet 元数据读取状态列的行组统计,先估算可跳过组,再和两次查询的扫描观测比对。下面示例针对上面产生的单文件。需要查看不同 DuckDB 版本返回的列名时,先用 DESCRIBE 检查表函数。
SELECT count(*) AS status_chunks,
       count(*) FILTER (
         WHERE try_cast(stats_max_value AS INTEGER) < 500
       ) AS can_skip_for_5xx
FROM parquet_metadata('sorted.parquet')
WHERE path_in_schema = 'status';
对另一份文件运行同样语句。如果某个字段没有合适的统计或统计值是空,这项比较自然不会把那一组算进可跳过数。真实数据里的字符串排序、空值和不同写入引擎统计策略,都可能改变能做的判断。读取计划时将元数据的推断和执行时的输入合在一起看,不能用自己算出的几条统计为远程字节打包票。
回到白天慢、凌晨快的现象,再做一个小对照:同样文件、同样筛选,上午分别低并发与高并发跑查询,然后换本地文件重放。同一布局本地稳定、远程高并发才慢,先看对象存储并发、连接及请求排队。两边都慢,核对并行度和解压 CPU。如果错误查询经常与全量报表同一时间运行,共享资源也会改变边界。把这些情况写成有条件的建议,例如错误热点查询从按状态聚集受益,全量报表仍用原布局,月底再根据两类使用量决定是否保两份数据。
分区裁剪可以用另一份同样的数据单独验证。将两天文件分别写进 day=2026-11-18 与 day=2026-11-19,随后从父目录读,并在查询里限定后一天。先查看计划中的文件过滤,再比较请求或已扫描的文件数。随后去掉日期条件但保留状态过滤。第二条可能仍跳过许多状态行组,却得先打开更多文件取元数据。用这两个动作就能把目录优化和行组优化的收益分别记下来。朋友拿截图问「为什么扫描了那么多」,你也有办法判断是日期条件无法剪枝,还是行组分布不合适。
将磁盘读得少和分析更快分开
同一数据按另一方式排序,压缩率也会变化。比较总耗时之外记下文件长度、行组分布、各查询读取的列数。如果 DuckDB 读远程文件,再取网络请求数和下载字节。两次执行最好交换顺序,并分别留冷和热结果。业务上常见的是第二次读得快,因为数据已热,未必是文件新布局更适合。对于冷缓存条件可用彼此隔离的进程和样本,设计时注意对象存储或操作系统缓存仍可能存在。
有两个对照值得顺手做。其一,把查询改成聚合 payload 的长度,观察额外一列怎样改变成本。其二,去掉 status 条件并查全表,看看排序后有没有损害更重要的日常查询。目标是发现读者真正会运行的查询在哪种布局中受益,不能用一条专门设计的查询代表整个团队。
给真正的对象存储目录做决策
生产日志常按 day=2026-11-19 这样的路径分区。日期范围先把候选文件压小,状态条件再应用到文件内行组。日期粒度合适时,按月汇总也能扫到数量可控的对象。若为了加速单个用户查询,把数百万个用户 ID 直接做成分区,最终可能输给对象列表与大量小 GET。每个文件分得过小,建立远程请求的固定开销就会盖过 CPU 扫描。相反,行组过大则会减少执行时可并行的单位,并让统计范围过宽。
最后把变更写成一个可回滚的比较:保留旧目录,双写一个小范围的日期,运行错误率、全量计数、按日汇总和最常见的过滤查询,核对两个目录返回同一组数据。记录冷读网络量和热读 CPU,再决定是不是值得让新写入换布局。团队要的是白天也能及时查到结果,而不是一张写着「支持下推」的执行计划。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论